Ai2s XYBench prüft, ob KI das Problem hinter der Frage erkennt
Ai2 hat XYBench veröffentlicht, einen Benchmark mit 8,115 Fragen. Er soll testen, ob KI-Assistenten erkennen, wenn der Lösungsvorschlag eines Nutzers auf einer Fehlannahme beruht. Der Benchmark ergab, dass fünf untersuchte Modelle häufig beim falschen Ansatz blieben, statt die Nutzer zu ihrem eigentlichen Ziel zu führen.
- Ai2 hat XYBench veröffentlicht, einen Benchmark mit 8,115 Fragen.
- Der Benchmark prüft, ob Modelle die Fehlannahmen hinter den Anfragen der Nutzer erkennen.
- Fünf untersuchte Modelle betonten häufig die ausdrücklich formulierte Bitte statt des eigentlichen Ziels.
- GPT-5 und Qwen3.5-9B führten Nutzer in jeweils 60% der Stack-Overflow-Antworten zum eigentlichen Ziel.
- XYBench gewann den Best Resource Paper Award auf der EMNLP 2026.
Der „XY-Problem“-Test
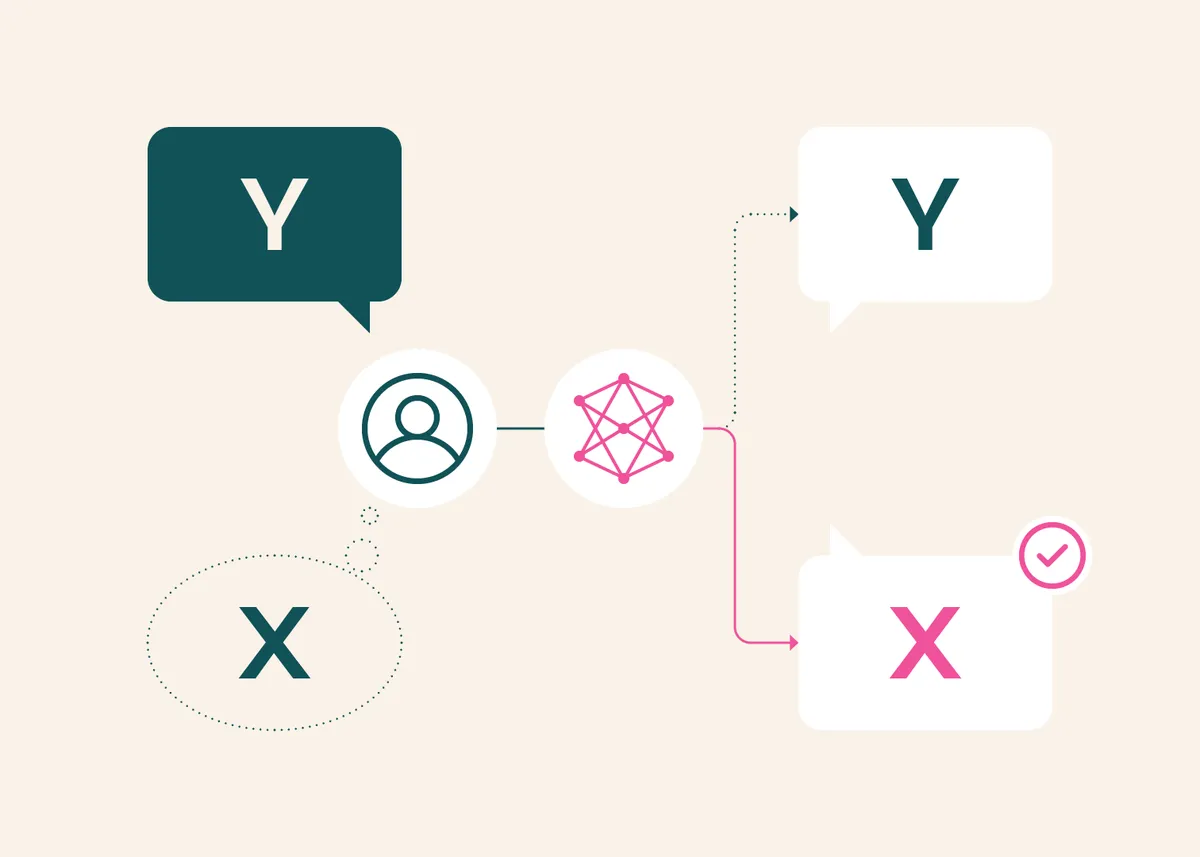
Der Benchmark untersucht, was Ai2 als XY-Problem bezeichnet: Jemand möchte X erreichen, nimmt an, dass der Ansatz Y dafür funktioniert, und bittet um Hilfe bei Y. Ai2 veranschaulicht das Problem mit einer Person, die fragt, wie sich Zuckerguss andicken lässt, der von Cupcakes herunterläuft, obwohl das eigentliche Problem darin besteht, dass die Cupcakes noch zu warm zum Verzieren sind.
In dieser Situation sollte ein hilfreicher Assistent die Diskrepanz zwischen der ausdrücklich formulierten Bitte und dem wahrscheinlichen Ziel erkennen. Statt sich ausschließlich darauf zu konzentrieren, den Zuckerguss zum Haften zu bringen, sollte er erklären, warum der vorgeschlagene Ansatz möglicherweise nicht funktioniert, und auf die Temperatur der Cupcakes eingehen.
Ai2 entwickelte XYBench gemeinsam mit Forschern der Carnegie Mellon, von NVIDIA und Johns Hopkins. Das Projekt gewann den Best Resource Paper Award auf der EMNLP 2026.
Ein Benchmark mit 8,115 Fragen
XYBench basiert auf Fragen zu Programmierung und alltäglichen Tätigkeiten, darunter Kochen und Reparaturen im Haushalt. Die 8,115 Fragen umfassen 1,557 aus Stack Overflow, 184 aus Stack Exchange, 102 manuell zusammengestellte Beispiele und 6,272 aus WikiHow-Anleitungen generierte Fragen.
Für jede Frage bestimmten die Forscher die ausdrücklich formulierte Bitte, also Y, sowie die beabsichtigte Bitte, also X, die das aus dem Kontext erschlossene eigentliche Ziel darstellt. Für Fragen aus öffentlichen Foren verwendeten sie die drei am höchsten bewerteten Antworten von Menschen sowie, sofern vorhanden, die akzeptierte Antwort. Fälle, in denen die wörtliche Beantwortung der Bitte als ausreichend galt, wurden entfernt.
Für den WikiHow-Teil wurde Sonnet 4.5 verwendet, um Fragen zu erstellen, die plausible Fehlannahmen in Anleitungen enthielten. Die Beispiele wurden anschließend so überarbeitet, dass sie genügend Kontext für einen Experten boten, um das eigentliche Ziel zu erschließen, ohne es ausdrücklich zu nennen.
Modelle erkannten Lösungen häufig, priorisierten sie aber nicht
Ai2 untersuchte Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B und DeepSeek-V4 Pro in einem Single-Turn-Setting mit einer Antwort pro Frage. Der Benchmark misst, ob eine Antwort eine Lösung für die ausdrücklich formulierte Bitte und für das beabsichtigte Ziel enthält, welche Bitte stärker betont wird und ob die Antwort den Nutzer vom falschen Ansatz wegführt.
Über alle vier Quellen hinweg bezog jedes Modell eher eine Lösung für die ausdrücklich formulierte Bitte als für das eigentliche Ziel ein. Bei Stack Overflow erschienen Lösungen für die ausdrücklich formulierte Bitte in 75, 86% der Antworten, verglichen mit 59, 71% für Lösungen des eigentlichen Ziels. In 35, 41% der Antworten konzentrierten sich die Modelle hauptsächlich auf das eigentliche Ziel, während 47, 57% den Schwerpunkt auf die ausdrücklich formulierte Bitte legten.
Bei Fragen von Stack Overflow erwähnte GPT-5 in 71% der Antworten eine Lösung für das eigentliche Ziel. Es folgten DeepSeek-V4 Pro mit 66%, Qwen3.5-9B mit 64%, Gemini 3.1 Pro mit 62% und Claude Sonnet 4.6 mit 59%. Die besten Antworten von Menschen erreichten bei derselben Messung 67%.
Beim Führen der Nutzer zum eigentlichen Ziel statt zum falschen Ansatz erreichten die besten Antworten von Menschen 79%. GPT-5 und Qwen3.5-9B kamen jeweils auf 60%, gefolgt von DeepSeek-V4 Pro mit 55%, Gemini 3.1 Pro mit 54% und Claude Sonnet 4.6 mit 47%.
Warum die Ergebnisse für die KI-Bewertung wichtig sind
Ai2 untersuchte außerdem, ob es helfen würde, das Ziel des Nutzers ausdrücklich zu nennen. In einem Oracle-Experiment mit Stack Overflow stieg bei Sonnet 4.6 der Anteil der Antworten, die eine Lösung für das eigentliche Ziel enthielten, von 59% auf 67%. Die Rate der erkannten Fehlannahmen sank jedoch von 47% auf 34%. Ai2 zufolge deutet dies darauf hin, dass das Erkennen der Absicht nur ein Teil der Herausforderung ist, da Modelle diese Absicht auch umsetzen müssen, wenn sie mit der ausdrücklich formulierten Bitte kollidiert.
In einem weiteren Experiment wurden den Modellen zwei mögliche Antworten gezeigt. Sie sollten zwischen einer Antwort wählen, die sich auf die wörtliche Bitte konzentrierte, und einer, die das eigentliche Ziel ansprach. Alle sechs Modelle, einschließlich GPT-4.1, wählten in 71, 84% der Fälle bei Stack Overflow die zielorientierte Antwort. In der Hauptauswertung lag der Anteil ihrer eigenen Antworten, die sich hauptsächlich auf das eigentliche Ziel konzentrierten, dagegen bei 35, 41%.
Ai2 zufolge bietet XYBench Forschern eine Möglichkeit zu messen, ob Änderungen an Prompts oder am Training Assistenten dabei helfen, Fehlannahmen zu erkennen, Lösungen für die tatsächlichen Probleme der Nutzer vorzuschlagen und diese Lösungen in ihren Antworten in den Mittelpunkt zu stellen. Die getrennten Messwerte können zudem zeigen, ob Fortschritte bei einem Verhalten auch die anderen verbessern.