Amazon und Booking.com verkleinern LLMs und machen sie bis zu 20-mal schneller
Forscher von Amazon Web Services haben gemeinsam mit Booking.com Wissensdestillation mit dem Medusa-2-Framework kombiniert. Das Ergebnis ist nach eigenen Angaben ein Modell mit 1,1 Milliarden Parametern, das die Qualität eines Lehrermodells mit 70 Milliarden Parametern erreicht und dabei 10- bis 20-mal schneller läuft. Laut Amazon Science senkte der Ansatz zudem die Kosten für Reisefunktionen wie den AI Trip Planner und Smart Filters.
- Die Kombination aus Wissensdestillation und Medusa-2 ergab ein TinyLlama mit 1,1 Mrd. Parametern, das qualitativ ein Llama-3.1-Lehrermodell mit 70 Mrd. Parametern erreichte und 10- bis 20-mal schneller lief.
- Die Wissensdestillation allein schloss die Qualitätslücke zu mehr als 90 Prozent und machte die Inferenz etwa 6-mal schneller; Medusa brachte weitere 2 bis 3,6 Mal.
- Smart Filters von Booking.com lieferte bei 99 Prozent der Anfragen 15-mal schnellere Antworten.
- Der AI Trip Planner verzeichnete 2,9 Prozent mehr Engagement gegenüber GPT-3.5, Unterkunftsbeschreibungen erhielten 1,4 Prozent mehr „hilfreich“-Bewertungen bei weniger als einem Drittel der Kosten von GPT-4.
- Die Arbeit erhielt den Best-Paper-Preis der Industry Track auf der ACL.
Warum Reiseplattformen schnellere Modelle brauchen
Reiseplattformen bedienen täglich Millionen Nutzerinnen und Nutzer, die sich nach Reisezielen erkundigen, Hotelempfehlungen suchen und Reisen planen. Viele setzen dafür inzwischen auf große Sprachmodelle (Large Language Models, LLMs). Laut dem Beitrag von Amazon Science liefern solche Modelle dank ihrer Größe, meist mehrere Dutzend Milliarden Parameter, präzise und kontextrelevante Empfehlungen.
Diese Größe hat ihren Preis. Die Modelle sind rechenintensiv, und die Kosten steigen mit der Zahl der Kundenanfragen. Für Web- und Mobilanwendungen können sie außerdem zu langsam sein: Schon eine Verzögerung von 100 Millisekunden kann ein Unternehmen nach Darstellung der Autoren Kunden und Umsatz kosten.
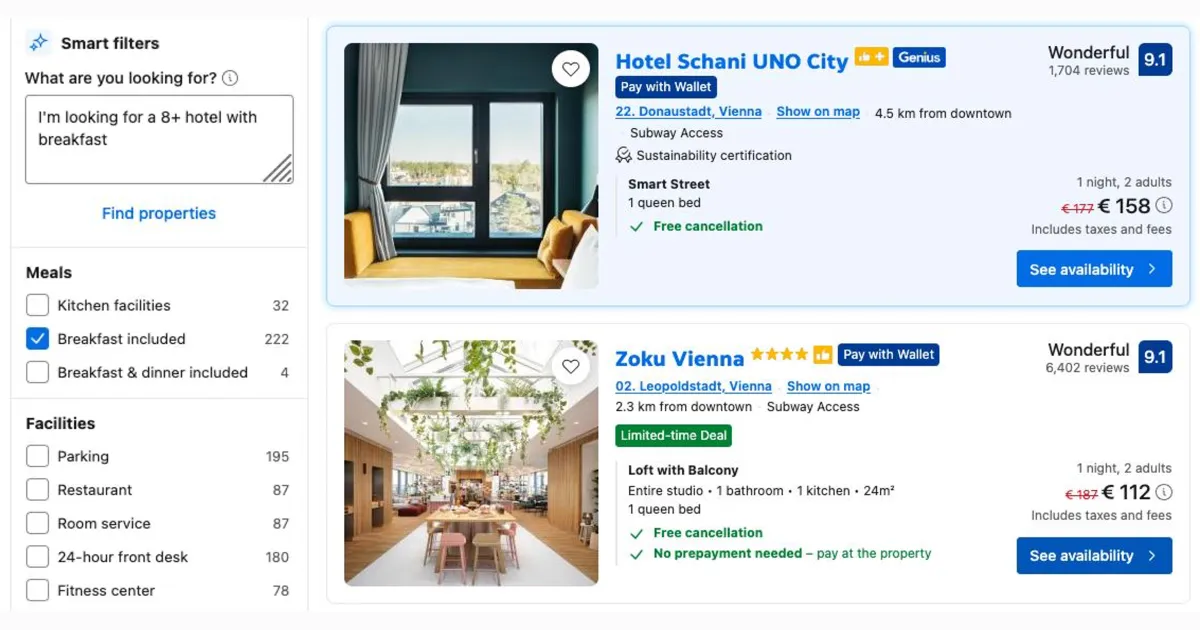
Die Autoren Daniel Zagyva und Laurens van der Maas, beide bei AWS, arbeiteten mit Booking.com an drei Funktionen. Der AI Trip Planner ist ein Dialogassistent, der Reisepräferenzen in weniger als einer Sekunde aus dem Gespräch herauslesen muss. Smart Filters wandelt Suchanfragen in natürlicher Sprache in Echtzeit in strukturierte Filter um. Die Accommodation Description Generation erstellt Unterkunftsbeschreibungen für Millionen von Einträgen, wo die Kosten die größte Rolle spielen.
Zwei Techniken, eine Pipeline
Das Team kombinierte zwei Verfahren. Bei der Wissensdestillation (Knowledge Distillation, KD) wird Wissen von einem großen Lehrermodell auf ein kleineres Schülermodell übertragen. Das Lehrermodell wird mit annotierten Daten feinabgestimmt und erzeugt anschließend Vorhersagen für unannotierte, domänenrelevante Texte. Das Schülermodell wird mit der Kombination aus von Menschen und von der Maschine annotierten Daten trainiert und lernt so, das Lehrermodell nachzuahmen.
Medusa zielt auf die Inferenzzeit. Ein LLM erzeugt normalerweise ein Token nach dem anderen. Medusa ergänzt das Basismodell um Vorhersagemodule, sogenannte Medusa-Köpfe (Medusa Heads), und zwar je einen für jedes parallel dekodierte Token. Da GPU-Hardware auf Parallelität optimiert ist, entsteht dabei kaum zusätzlicher Aufwand. Laut den Autoren bringt Medusa typischerweise eine 2- bis 4-fache Beschleunigung, ohne die Qualität der Textgenerierung zu beeinträchtigen.
In der gemeinsamen Pipeline werden die Medusa-Köpfe beim Training auf dem kombinierten Korpus an das Schülermodell angehängt. Heraus kommt ein einziges kompaktes Modell, das das Wissen des Lehrers erbt und mehrere Tokens gleichzeitig vorhersagen kann.
Was die Experimente zeigten
Das Team nutzte TinyLlama mit 1,1 Milliarden Parametern als Schüler und Llama-3.1 mit 70 Milliarden Parametern als Lehrer. Es führte vier aufeinander aufbauende Experimente durch.
- Die Feinabstimmung von TinyLlama auf aufgabenspezifische Daten für jeden Anwendungsfall machte das Modell deutlich genauer als GPT-4o mit Few-Shot-Prompting, blieb aber hinter dem Lehrer zurück.
- Die Wissensdestillation schloss diese Lücke zu mehr als 90 Prozent, brachte das kleine Modell nahe an den Lehrer heran und machte die Inferenz etwa 6-mal schneller.
- Das Hinzufügen von Medusa-Köpfen beschleunigte die Inferenz um weitere 2 bis 3,6 Mal.
Getestet wurden zwei Medusa-Varianten. Bei Medusa-1 wird zuerst das Basis-LLM feinabgestimmt, dann werden seine Gewichte eingefroren und die Köpfe separat feinabgestimmt. Bei Medusa-2 wird alles in einer einzigen Phase trainiert. Beide erzielten vergleichbare Beschleunigungen ohne nennenswerten Qualitätsverlust, doch die einfachere Pipeline von Medusa-2 ist nach Ansicht der Autoren praxistauglicher für Produktteams, die mehrere Modelle betreuen.
Ergebnisse für Booking.com und was sie bedeuten
Laut den Autoren erreichte das finale Modell aus KD und Medusa-2 die Qualität des Lehrers mit 70 Milliarden Parametern und lief je nach Anwendungsfall 10- bis 20-mal schneller. Für jede Funktion wurde ein eigenes Modell feinabgestimmt.
- AI Trip Planner: 2,9 Prozent mehr Nutzerengagement im Vergleich zu GPT-3.5.
- Smart Filters: 15-mal schnellere Antworten bei 99 Prozent der Anfragen.
- Unterkunftsbeschreibungen: 1,4 Prozent mehr „hilfreich“-Bewertungen von Nutzern, bei weniger als einem Drittel der Kosten von GPT-4.
Der kombinierte Ansatz halte die Qualität der besten Open-Source-LLMs bei weniger als einem Drittel der Kosten und sei dabei bis zu 20-mal schneller, so die Autoren. Reiseplattformen und andere Anwendungen, die auf LLMs setzen, könnten mit dem Framework schnelle, kosteneffiziente und präzise Antworten in realen Szenarien liefern. Die Arbeit wurde auf der Tagung der Association for Computational Linguistics (ACL) vorgestellt und erhielt dort laut dem Beitrag den Best-Paper-Preis der Industry Track.
Amazon Science: Speeding up language models for travel applications