Anyscale senkt mit Ray die JEPA-Roboterplanung auf unter eine Sekunde
Anyscale hat ein Design und eine getestete Implementierung veröffentlicht, die die Inferenz des V-JEPA2-AC-Weltmodells in einen Ray-Cluster verlagert. In einer Konfiguration sinkt die Planungszeit auf 0.86 Sekunden pro Aktion. Der Ansatz verteilt die Suche des Modells auf acht NVIDIA A100-40GB-GPUs, während Wahrnehmung und Aktorik auf dem Roboter verbleiben.
- V-JEPA2-AC bewertet mögliche Zukunftsverläufe, um Aktionen für Roboterarme zu planen.
- Die Planung dauerte auf einer RTX 4090 16 Sekunden pro Aktion.
- Anyscale verteilte die Suche mit Ray auf 8 A100-40GB-GPUs.
- Das gemessene Ergebnis lag bei 2.86 Sekunden pro Aktion beziehungsweise 0.86 Sekunden bei 3 Runden.
Warum V-JEPA2-AC eine schnellere Planung benötigt
V-JEPA2-AC nutzt die Joint-Embedding Predictive Architecture, kurz JEPA, um zu entscheiden, was ein Roboterarm als Nächstes tun soll. Das Modell bewertet Hunderte mögliche Zukunftsverläufe und wählt denjenigen aus, der einem Ziel am nächsten kommt. Laut Anyscale wurde das Modell ohne Zero-Shot-Feinabstimmung für die jeweilige Umgebung in zwei Laboren auf Franka-Armen eingesetzt. Dabei wurden Erfolgsraten von 65, 80% bei Pick-and-Place-Aufgaben mit unbekannten Objekten gemeldet.
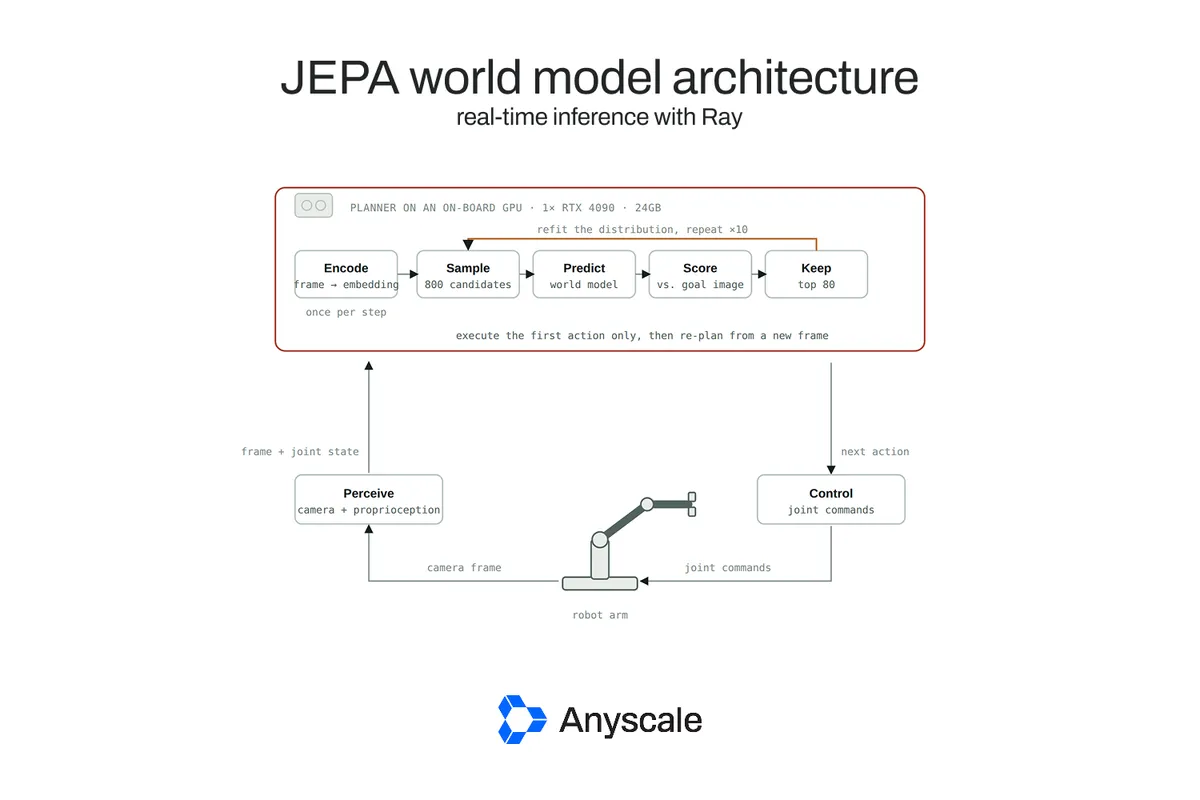
Das System lief auf einer einzelnen RTX 4090, benötigte jedoch 16 Sekunden für die Planung jeder Aktion. Diese Verzögerung verhindert einen kontinuierlichen Betrieb. Der Roboter nimmt ein Kamerabild auf, plant, bewegt sich und pausiert anschließend erneut, während die nächste Bewegung geplant wird. Laut Anyscale liegt das Problem nicht in der Genauigkeit des Modells, sondern in den wiederholten Kosten der Suche.
Jeder Planungsschritt nutzt die Cross-Entropy Method, kurz CEM. Dabei werden 800 mögliche Aktionssequenzen erzeugt, die besten 80 ausgewählt und die Suche um diese Kandidaten herum neu zentriert. Dieser Prozess läuft über zehn Runden und erzeugt für eine kleine Bewegung etwa 8.000 Vorhersageauswertungen. Aus der siegreichen Sequenz wird nur die erste Aktion ausgeführt.
Die Suche vom Roboter in einen Cluster verlagern
Anyscales Design verlagert die Inferenz des Weltmodells auf einen Cloud-Server. Der Roboter übernimmt weiterhin Wahrnehmung und Aktorik, sendet ein Kamerabild und seinen Gelenkzustand über das Netzwerk und erhält im Gegenzug einen Aktionsvektor. Das Unternehmen testete das Modell auf NVIDIA A100-40GB-GPUs. Diese bieten mehr Speicher als die im Paper verwendete RTX 4090 mit 24 GB sowie eine höhere bf16-Rechenleistung.
Eine einzelne A100 reduzierte die gemessene Zeit nach Optimierungen auf Modellebene auf 21.4 Sekunden pro Aktion. Anyscale berichtet außerdem, dass der Referenzplaner von Meta bei Ausführung mit dem veröffentlichten Planungscode und den angegebenen Einstellungen auf einer A100 81.8 Sekunden pro Aktion benötigte. Dieses Ergebnis von 81.8 Sekunden verwendet das Unternehmen im Beitrag als Ausgangswert für die Geschwindigkeitssteigerungen.
Die größere Verbesserung entsteht durch die Verteilung der unabhängigen Kandidatenauswertungen innerhalb jeder CEM-Runde. Anyscale führte die Suche mit Ray über einen Knoten mit acht GPUs und acht A100-40GB-GPUs aus. Das ergab gemessene 2.86 Sekunden pro Aktion beziehungsweise 0.86 Sekunden bei drei Runden pro Schritt. Die zehn Runden bleiben sequentiell, was die minimale erreichbare Suchzeit begrenzt.
Wie Ray den Inferenzdienst für Roboter organisiert
Ray ist ein Open-Source-Framework, das ursprünglich am RISELab der UC Berkeley entwickelt wurde und nun von Anyscale gepflegt wird. Ray Core stellt Remote-Funktionen für verteilte Aufgaben und Remote-Klassen für zustandsbehaftete Akteure bereit. Anyscale verwendet Akteure, um die Gewichte eines Checkpoints mit 1,2 Milliarden Parametern zwischen Anfragen geladen zu halten.
Ray Serve ergänzt eine Serviceschicht, die Replikate verwaltet, Anfragen weiterleitet und bei steigender Last skaliert. In der beschriebenen Implementierung teilen sich zwei Ray-Serve-Bereitstellungen die Arbeit. WorldModel ist die GPU-Ebene mit einem Replikat pro GPU, das Encoder und Predictor enthält. Planner führt die CEM-Schleife aus, verteilt jede Runde auf die Modellreplikate und stellt den Endpunkt bereit, den der Roboter einmal pro Steuerschritt aufruft.
Laut Anyscale liegen Bereitstellungsverwaltung, Zustandsprüfungen, Neustarts und Konfiguration durch diese Anordnung unter der Kontrolle von Ray Serve. Ein deklarativer KubeRay-RayService kann das System dem Unternehmen zufolge ohne Ausfallzeit ausrollen.
Was die Ergebnisse für die Robotersteuerung bedeuten
Die Implementierung verändert den Planungsteil der Roboterschleife, lässt Wahrnehmung, Regelung und Aktorik jedoch unverändert. Die zentrale Idee besteht darin, die unabhängig ausführbaren Kandidaten-Rollouts zu parallelisieren, anstatt sie als einen großen Batch auf einer einzelnen GPU zu verarbeiten.
Das gemeldete Ergebnis von 0.86 Sekunden zeigt, dass der Ansatz die Planungssuche in der getesteten Konfiguration auf unter eine Sekunde pro Aktion bringen kann. Die durch die Cloud-Inferenz entstehende Netzwerkumlaufzeit entfällt dadurch nicht. Außerdem berichtet die Quelle keine vollständige Messung der Ende-zu-Ende-Steuerschleife. Die Ergebnisse beschreiben vielmehr eine Möglichkeit, JEPA-basierte Planung durch die Kombination von Ray Core, Ray Serve und mehreren GPUs für den kontinuierlichen Roboterbetrieb geeigneter zu machen.
Anyscale: Real-time inference for JEPA world model architectures with Ray