Arize ersetzt beim Alyx-Agenten den Wissensgraphen durch eine einzige Memory-Datei mit 8.000 Zeichen
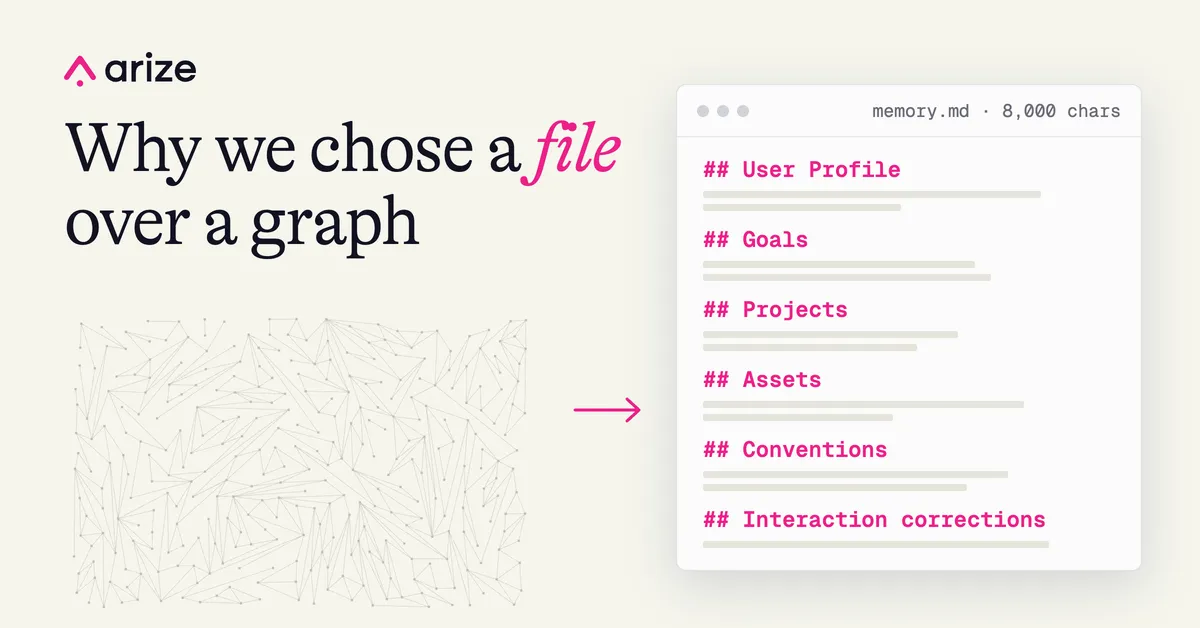
Arize AI zufolge besteht das Langzeitgedächtnis, das das Unternehmen für Alyx ausgeliefert hat, den KI-Engineering-Agenten in Arize AX, aus einer einzigen strukturierten Textdatei pro Nutzer und Arize-Space. Sie ist auf 8.000 Zeichen begrenzt und wird bei jeder Anfrage vollständig gelesen. Zuvor hatte das Team ein deutlich komplexeres System mit Vektorsuche, getrennten episodischen und semantischen Speichern und einem zeitlichen Wissensgraphen gebaut und es dann wieder verworfen.
- Alyx nutzt jetzt eine strukturierte Memory-Datei pro Nutzer und Arize-Space, begrenzt auf 8.000 Zeichen und bei jeder Anfrage vollständig gelesen.
- Arize verwarf nach wochenlanger Arbeit ein Design mit Vektorsuche, episodischen und semantischen Speichern und einem zeitlichen Wissensgraphen.
- Laut Beitrag kostet eine Runde mit 5 Entitäten und 6 Fakten in Graphiti ohne eigene Typen etwa 10 LLM-Aufrufe und mit eigenen Typen mehr als 20.
- Arize berichtet, Alyx habe 16 von 18 gedächtnisabhängigen Fragen richtig beantwortet und in einem Test mit Fällen, in denen Memory schaden könnte, jede Frage bestanden.
- Hintergrundjobs schlagen Änderungen vor und die Kompaktierung hält die Datei im Rahmen, doch ein abgelehntes Update kann aktuelle Informationen ungespeichert lassen.
Was Arize ausgeliefert hat
Laut dem Blogbeitrag von Arize erhält jeder Nutzer für jeden Arize-Space, in dem er arbeitet, eine eigene Memory-Datei. Alyx liest die gesamte Datei bei jeder Anfrage, sodass beim Lesen keine Memory-Suche mehr nötig ist. Hintergrundjobs fassen abgeschlossene Gesprächsrunden zusammen und schlagen gezielte Änderungen vor, eine Kompaktierung hält die Datei innerhalb des Größenlimits. Arize räumt einen Zielkonflikt ein: Wird ein Update abgelehnt, können aktuelle Informationen ungespeichert bleiben.
Der Autor sagt, das Design ähnele dem Ansatz, den OpenAI und Anthropic bei ChatGPT und Claude gewählt haben. Dem Beitrag zufolge legen beide ein kompaktes Memory-Profil direkt in den Kontext des Modells und heben sich die Suche für die seltenen Fälle am Rand auf. Arize argumentiert, dass für einen klar abgegrenzten Agenten eine stets geladene, gut strukturierte Datei ausreichen kann, und nennt sie für die meisten solcher Agenten den richtigen Standard.
Warum Alyx ein Gedächtnis über die Sitzung hinaus braucht
Arize beschreibt Langzeitgedächtnis als Kontext, den ein Agent über Sitzungen hinweg behält, etwa dauerhafte Nutzerpräferenzen, Ziele, Konventionen und Entscheidungen. Sitzungen enden, ein neuer Chat beginnt daher bei null. Außerdem lassen sie mit wachsender Länge nach. Der Beitrag verweist auf Tests von Chroma mit 18 Modellen, laut denen "performance grows increasingly unreliable as input length grows" (die Leistung wird mit zunehmender Eingabelänge immer unzuverlässiger), sowie auf die Studie "Lost in the Middle" von 2023 zu Modellen, die mit mitten im Input vergrabenen Informationen Schwierigkeiten haben. Lange Sitzungen werden irgendwann kompaktiert, und eine für eine Aufgabe geschriebene Zusammenfassung kann Details auslassen, die für die nächste gebraucht werden.
Nach Angaben von Arize ist das bei Alyx besonders akut, weil Nutzer zwischen Trace-Ansichten, Eval-Seiten, dem Prompt-Playground und Dashboards wechseln und jede davon einen eigenen Thread starten kann. Lernt Alyx, dass die Ground Truth in metadata.label liegt, soll das auch dann noch verfügbar sein, wenn der Nutzer in einer neuen Sitzung den Eval-Builder öffnet. Dasselbe gilt für Präferenzen wie "datasets should have exactly 70 rows" (Datasets sollen genau 70 Zeilen haben).
Wo der Ansatz mit Retrieval und Graph scheiterte
Der erste Prototyp behandelte Memory als Retrieval-Problem und bildete Nutzer, Projekte und Assets als Graph-Entitäten ab. Der Autor baute wochenlang auf Graphiti auf, dem zeitlichen Wissensgraphen von Zep, und hielt ihn für leistungsfähig, besonders bei Beziehungen und Fakten, die sich im Lauf der Zeit ändern. Für Alyx zeigten sich drei Probleme.
- Allgemeine Präferenzen wurden leicht übersehen. Eine aus der letzten Nachricht gebildete Abfrage wie "Make a dataset of agent-prod traces" hat kaum semantische Überschneidung mit einer Konvention wie genau 70 Zeilen. Werden Konventionen bei jeder Anfrage geladen, entfällt diese Lücke.
- Graph-Memory ist aufwendig zu betreiben. Beim Lesen von Graphitis Pfad add_episode zählte der Autor einen LLM-Aufruf zum Extrahieren von Entitäten, einen zum Auflösen mehrdeutiger Entitäten und einen zum Extrahieren von Fakten, dazu weitere Aufrufe pro Fakt und pro Entität. Bei einer Runde mit 5 Entitäten und 6 Fakten sind das ohne eigene Typen etwa 10 LLM-Aufrufe und mit eigenen Typen mehr als 20. Der Beitrag verweist zudem auf Ratenlimits und Latenz.
- Es wird zum Data-Science-Problem. Das Debugging verlagert sich auf Recall at k, Embedding-Modelle und Ähnlichkeitsschwellen. Dem Beitrag zufolge sind Memory-Benchmarks wackelig, selbst bei LoCoMo widersprechen sich die Anbieter: Zeps korrigierter Wert für sich selbst liegt bei 75,14 %, Mem0 gab in seiner Studie 65,99 % für Zep an, und ein auf GitHub veröffentlichter erneuter Mem0-Durchlauf kam auf 58,44 %.
Eval-Ergebnisse und Bedeutung
Arize berichtet, dass Alyx in den abschließenden Evals 16 von 18 Fragen, die vom Gedächtnis abhingen, richtig beantwortete, sowohl in drei getrennten Szenarien als auch in einem gemischten Durchlauf, in dem sich die Szenarien abwechseln. Das Team testete auch in die Gegenrichtung, mit Fragen, bei denen Memory den Agenten verschlechtern könnte, und gibt an, Alyx habe in dieser Gruppe jede Frage bestanden. Der Beitrag behandelt außerdem Fehler, die das Team fand, darunter verschwundene Präferenzen und Fehler, die der Agent in sein eigenes Memory zurückschrieb.
Für Teams, die abgegrenzte Agenten bauen, lautet die Botschaft von Arize, dass eine einfache, stets geladene Datei eine teure Retrieval-Pipeline ersetzen kann, auch wenn die eigentliche Schwierigkeit bleibt, zu entscheiden, was bewahrt und wann es angewendet wird. Die Ergebnisse stammen von Arize selbst aus internen Evaluierungen.