Arize-Benchmark: Hohe Wiederverwendung im Prompt-Cache garantiert keine niedrigeren Agentenkosten
Ein Prompt-Caching-Benchmark von Arize AI zeigt: Eine hohe Cache-Read-Quote führt nicht automatisch zu niedrigeren Kosten. Claude Opus 5.5 las 89,8 % seiner Prompt-Token aus dem Cache und hatte trotzdem die höchsten geschätzten Kosten, weil Output-Token den Großteil der Ausgaben verursachten.
- DeepSeek hatte laut Arize die höchste Cache-Read-Quote (93,6 %) und die niedrigsten von Phoenix geschätzten Kosten (1,17 US-Dollar für 100 Läufe).
- Claude las 89,8 % der Prompt-Token aus dem Cache, hatte mit 14,63 US-Dollar aber die höchsten geschätzten Kosten, da Output-Token den Großteil der Ausgaben verursachten.
- Die Cache-Nutzung stieg bei allen vier Modellen mit der Konversationslänge; bei GPT von 34,2 % bei 5 Turns auf 87,0 % bei 20 Turns.
- Die Kosten sind Phoenix-Schätzungen und nicht mit Anbieterrechnungen abgeglichen; zudem änderten sich Modell und Anbieterpfad gemeinsam.
So hat Arize den Test durchgeführt
Prompt Caching ermöglicht es einem Agenten, bereits verarbeitete Prompt-Token wiederzuverwenden, statt dieselbe Eingabe erneut zu verarbeiten. Bei mehrstufigen Agenten, die Anweisungen, Anwendungskontext oder den Gesprächsverlauf immer wieder mitführen, kann das laut Arize die Kosten für wiederholte Eingaben senken.
Für den Test baute das Unternehmen einen Shopping-Assistenten für Wonder Toys und einen Datensatz mit 20 mehrstufigen Konversationen mit jeweils 5 bis 20 Turns. Jede Konversation wurde pro Modell- und Anbieterpfad fünfmal ausgeführt, sodass pro Modell 100 Konversations-Traces entstanden. Arize nutzte Harbor, ein Framework zur Evaluierung von Agenten in Sandbox-Umgebungen, um die Aufgaben auszuführen. Das Phoenix-Harbor-Plugin erfasste die Jobs als versionierte Datensätze und Experimente und übermittelte die Traces an Phoenix.
Produktkatalog, Aufgabenanweisungen, Konversationsdatensatz und Bewertungskriterien blieben konstant. Nur Modell und Anbieter änderten sich. DeepSeek und GLM liefen über OpenRouter, GPT direkt über OpenAI und Claude direkt über Anthropic. Da sich Modell und Anbieter gleichzeitig änderten, vergleichen die Ergebnisse laut Arize das beobachtete Verhalten der jeweiligen Pfade und isolieren nicht die Caching-Effizienz eines Modells.
Die Kosten im Benchmark sind Schätzungen von Phoenix auf Basis der Token-Preise aus den Preisseiten der jeweiligen Anbieter. Arize hat sie nicht mit tatsächlichen Anbieterrechnungen abgeglichen.
Ergebnisse: Cache-Nutzung, Kosten und Latenz
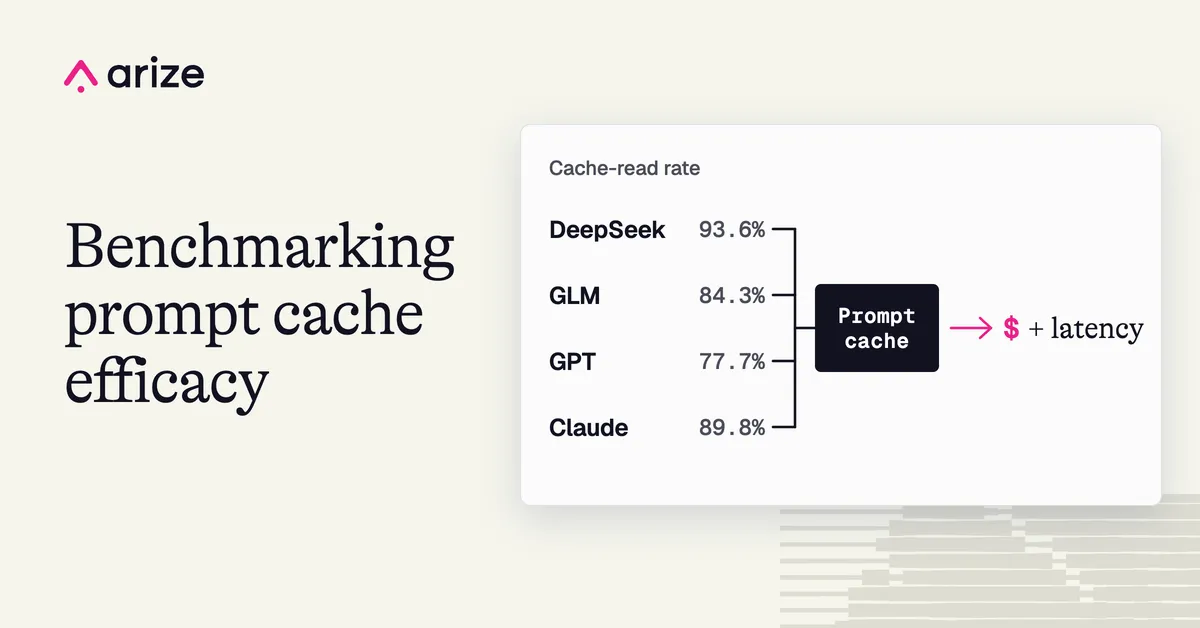
DeepSeek erreichte mit 93,6 % die höchste Cache-Read-Quote, gefolgt von Claude mit 89,8 %, GLM mit 84,3 % und GPT mit 77,7 %. DeepSeek hatte zudem die niedrigsten geschätzten Gesamtkosten über 100 Läufe, nämlich 1,17 US-Dollar, und die kürzeste durchschnittliche Trace-Latenz mit 34,7 Sekunden. Arize weist darauf hin, dass die Ergebnisse nicht belegen, dass allein das Caching einen der beiden Vorteile verursacht hat.
- DeepSeek V4 Pro 0813: 93,6 % Cache Read, 1,17 US-Dollar, 34,7 s
- GLM 5.3 Prime: 84,3 % Cache Read, 4,49 US-Dollar, 91,4 s
- GPT-6.1 Sol: 77,7 % Cache Read, 2,74 US-Dollar, 55,6 s
- Claude Opus 5.5: 89,8 % Cache Read, 14,63 US-Dollar, 81,2 s
Die Cache-Nutzung stieg bei allen vier Modellen mit der Länge der Konversation. Das hatte Arize erwartet, da spätere Turns mehr Katalog-, Anweisungs- und Verlaufsinhalte enthalten, die wiederverwendet werden können. Bei GPT war der Sprung am größten: von 34,2 % bei 5 Turns auf 87,0 % bei 20 Turns. DeepSeek startete bei 85,7 % und erreichte bei 20 Turns 95,6 %. GLM stieg von 70,0 % auf 88,3 %, Claude von 84,1 % auf 91,7 %.
Arize merkt an, dass für Teams, deren Agenten meist kurze Gespräche führen, die Ergebnisse bei 5 Turns relevanter sein können als das Gesamtranking, während Teams mit langen Threads auf das Verhalten in späteren Turns achten sollten.
Warum das Output-Volumen für die Kosten zählt
Die Cache-Read-Quote zeigt, wie viel der Prompt-Eingabe wiederverwendet wurde, bildet aber nicht das gesamte Kostenbild ab. Claudes geschätzte Gesamtkosten von 14,63 US-Dollar waren die höchsten im Test, und laut Arize entfiel der größte Teil davon auf den Output.
GPT liefert ein weiteres Beispiel. Die Cache-Read-Quote lag niedriger als bei GLM, die geschätzten Gesamtkosten aber ebenfalls: 2,74 US-Dollar gegenüber 4,49 US-Dollar. Laut Arize erzeugte GPT über alle Läufe 157.314 Completion-Token, GLM dagegen 725.047. Output-Volumen und Token-Preise bleiben also relevant.
In Phoenix erscheint jede Konversation als Trace mit einem LLM-Span pro Modellaufruf. Arize verweist auf einen Claude-Aufruf, bei dem 60 % der Gesamt-Token als Cache Reads eingestuft wurden, der Output aber 81 % der geschätzten Kosten ausmachte. Mit solchen Ansichten auf Span-Ebene können Teams beim Debugging prüfen, ob das Caching funktioniert, statt es später aus den aggregierten Ausgaben abzuleiten.
Was das für Teams bedeutet
Arize rät, Caching anhand der Konversationen zu messen, die ein Agent tatsächlich führt: Aufgabe, Datensatz und wiederholte Läufe mit Harbor konstant halten, Cache-Read-Quote, geschätzte Kosten und Latenz in den Phoenix-Experimentdiagrammen vergleichen und einzelne LLM-Spans untersuchen. Zudem empfiehlt das Unternehmen, die Cache-Nutzung mit Output-Volumen und Aufgabenqualität abzugleichen, bevor Modelle oder Anbieterpfade gewechselt werden.
Das Unternehmen betont, dass die Ergebnisse für diese Arbeitslast und diese Modell- und Anbieterpfade spezifisch sind. Sein Fazit: Sind Cache-Nutzung, Kosten, Latenz und Output-Volumen gemeinsam sichtbar, können Teams beurteilen, welche Konfiguration für ihre eigenen Agenten-Workloads effizient ist.