Arize-Test: Jevs Wahrscheinlichkeiten verraten eigene Fehler und schwierige Fälle für LLM-Judges
Arize AI zufolge kann Jev, ein Modell, das statt Text eine Wahrscheinlichkeit für jedes Label ausgibt, mit nur einem Aufruf zeigen, wo eine Bewertung wahrscheinlich falsch oder schwierig ist. In einem Test mit 36.190 Bewertungen über 10 Phoenix-Evaluatoren lagen Jevs Antworten mit niedriger Wahrscheinlichkeit deutlich häufiger falsch als jene mit hoher.
- Arize führte 36.190 Bewertungen durch: sieben Judges, 10 Phoenix-Evaluatoren, 517 gelabelte Beispiele, je zehn Durchläufe.
- Jev erreichte im Mittel über die 10 Evaluatoren 98,3 Prozent Genauigkeit, sowohl als Drop-in als auch nativ.
- Jev wechselte als Drop-in bei 0,97 Prozent der Beispiele die Antwort, nativ bei 0,19 Prozent, der niedrigste Wert aller Judges.
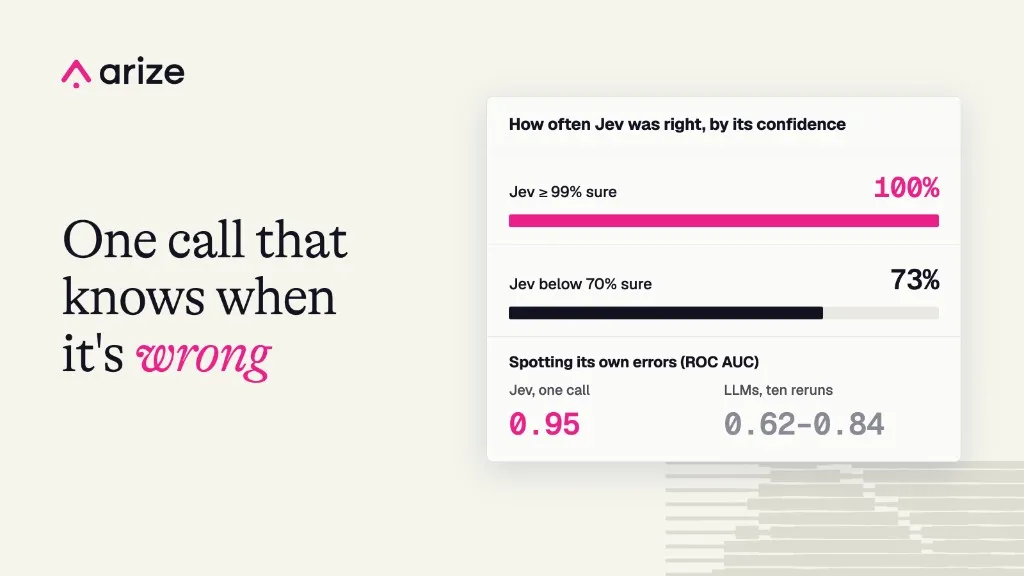
- Jevs Wahrscheinlichkeit erkannte eigene Fehler mit einer ROC AUC von 0,95 als Drop-in und 0,99 nativ, bei LLMs lag sie zwischen 0,62 und 0,84.
- Jevs Entropie sagte die Instabilität von LLMs mit einer ROC AUC von 0,85 voraus, ein Schwellenwert von 0,5 Bit markierte 11 Prozent der Beispiele zur Prüfung.
So testete Arize die Judges
Den Test führte ein Arize-Autor durch, der zuvor argumentiert hat, dass der Nichtdeterminismus eines LLM-Judges ein Signal und nicht nur ein Problem sei. Empfohlen wird, einen Judge bei der Entwicklung einer neuen Evaluierung zehnmal oder öfter mit hoher Temperatur laufen zu lassen, weil er bei schwierigen Beispielen und mehrdeutigen Kriterien am stärksten schwankt. Laut Arize ist das im Produktionsmaßstab zu teuer. Die Frage war daher, ob ein Judge, der eine Wahrscheinlichkeit zurückgibt, dasselbe Signal mit einem einzigen Aufruf liefern kann.
Arize nutzte die von Menschen gelabelten Benchmarks, die es für jeden in Phoenix integrierten Evaluator pflegt: Korrektheit, PII-Erkennung, Vollständigkeit, Tool-Aufruf, Umgang mit Tool-Antworten, Relevanz der Retrieval-Ergebnisse, Nutzerfrust, Halluzination, Ablehnung und Prägnanz. Zusammen umfassen sie 517 gelabelte Beispiele, zwischen 23 und 136 pro Evaluator. Sieben Judges bewerteten jedes Beispiel zehnmal: drei kleine LLMs (GPT-5 nano, Gemini 3.8 Flash, Claude Haiku 4.5), zwei Frontier-LLMs (GPT-5.6 Sol, Claude Opus 5) und zwei Jev-Konfigurationen. Der gesamte Durchlauf kostete laut Arize 169,84 US-Dollar, davon entfielen 64 Cent auf Jev.
Die PII-Erkennungssuite enthält ausschließlich Beispiele mit PII. Sie misst also, wie oft ein Judge PII findet, nicht, wie oft er Fehlalarme auslöst.
Drop-in versus natives Jev
Die eingebauten Evaluatoren von Phoenix verwenden Prompt-Vorlagen für LLMs, in denen Bewertungsraster, Daten und erlaubte Labels in einem Textblock stehen. Die API von Jev teilt eine Anfrage in drei Felder: state für die zu beurteilenden Daten, instructions für die Entscheidungsaufgabe und criteria für die erlaubten Labels samt Beschreibung. Arize betrieb Jev sowohl als Drop-in, mit dem vollständigen Phoenix-Prompt in state, als auch nativ, mit dem auf die drei Felder verteilten Raster. Als Drop-in läuft Jev derzeit in phoenix-evals.
Im Mittel über die 10 Evaluatoren erreichte Jev in beiden Varianten eine Genauigkeit von 98,3 Prozent, keiner der Unterschiede pro Aufgabe war signifikant. Den größten Zugewinn der nativen Variante gab es mit 7,1 Punkten bei der Vollständigkeit, wo Konversationen im Schnitt rund 1.950 Token lang sind. Arize empfiehlt, die native Variante bei Evaluatoren mit langen Eingaben auszuprobieren.
Konsistenz und Selbstdiagnose
Ein Judge galt als antwortwechselnd, wenn mindestens einer der zehn Durchläufe eines Beispiels von den übrigen abwich. Jev tat das als Drop-in bei 0,97 Prozent der Beispiele und nativ bei 0,19 Prozent, dem niedrigsten Wert aller Judges. Drop-in-Jev war signifikant stabiler als drei der fünf LLMs, darunter GPT-5 nano und Haiku 4.5, und gleichauf mit Gemini 3.8 Flash und Opus 5. GPT-5 nano wechselte bei 26 Prozent der Beispiele zum Tool-Aufruf die Antwort, Haiku 4.5 bei 12 Prozent der Beispiele zur PII-Erkennung.
Auch Jevs Wahrscheinlichkeit folgte der Korrektheit. Die mediane Wahrscheinlichkeit des gewählten Labels lag bei richtigen Antworten bei 1,00, bei falschen bei 0,71. Alle 3.561 Durchläufe, in denen Jev mindestens 99 Prozent auf seine Antwort setzte, waren korrekt, unter 70 Prozent lag es nur in 73 Prozent der Fälle richtig. Als Detektor für eigene Fehler erreichte die Wahrscheinlichkeit eine ROC AUC von 0,95 als Drop-in und 0,99 nativ. Bei den LLMs, die Labels ohne Wahrscheinlichkeiten pro Label zurückgaben, nutzte Arize die Übereinstimmung über zehn Aufrufe als Unsicherheitssignal, ihre ROC AUC reichte von 0,62 bis 0,84.
Viele LLM-Fehler sind konsistent: Von den Beispielen, die ein LLM in den meisten Durchläufen falsch beantwortete, schwankten 27 bis 75 Prozent nie, Wiederholung würde sie also nicht aufdecken. Jeder Judge lag nur bei 4 bis 14 Beispielen falsch, und Arize betont, die Zahlen seien als klare Tendenz, nicht als präzises Ranking zu lesen.
Unsicherheit als Wegweiser für die menschliche Prüfung
Arize verglich außerdem Jevs Unsicherheit, gemessen als Entropie, damit, ob einer der fünf LLM-Judges bei demselben Beispiel seine Antwort wechselte. Bei den 306 Beispielen, bei denen sich Jev nahezu sicher war, schwankte ein LLM-Judge in 3 Prozent der Fälle. Bei den 24, bei denen Jev nahe an einem Münzwurf lag, schwankten die LLMs in 71 Prozent. Die Rangkorrelation beträgt 0,47 und besteht einen Test, bei dem die Werte innerhalb jedes Evaluators gemischt werden. Als Detektor für Beispiele, die LLM-Judges instabil machen, erreicht Jevs Entropie eine ROC AUC von 0,85.
Ein Schwellenwert von 0,5 Bit markiert 11 Prozent der Beispiele, und die LLMs schwankten bei fast zwei Dritteln davon. Laut Arize sind das die Beispiele, die ein Mensch prüfen sollte, und zwar ermittelt, ohne ein LLM zehnmal laufen zu lassen.
Was das für Eval-Teams bedeutet
Nach der von Arize genannten Preisliste kostet Jev 0,042 US-Dollar pro Million Eingabetoken bei kostenloser Ausgabe, gegenüber 0,05 und 0,40 US-Dollar bei GPT-5 nano. Für Teams, die LLM-Judges im großen Maßstab einsetzen, deuten die Ergebnisse darauf hin, dass ein einziger Jev-Aufruf sowohl klassifizieren als auch anzeigen kann, welche Fälle menschliche Aufmerksamkeit verdienen. Die Benchmarks sind mit 23 bis 136 Beispielen pro Evaluator klein, die Ergebnisse haben daher Richtungscharakter.
Arize AI: What Jev’s probabilities reveal that repeated LLM judgments miss