Arize testet KI-Agenten mit Harbor und einem Phoenix-Plugin
Arize AI hat beschrieben, wie das Unternehmen seinen Coding-Agenten PXI sowie MCP-Server, Skills und CLIs mit dem Open-Source-Framework Harbor und einem Plugin testet, das die Ergebnisse in Arize Phoenix ablegt. Laut Arize ersetzt dieser Aufbau einen Haufen von Mocks durch eine realistische, reproduzierbare Umgebung.
- Arize nutzt das Open-Source-Framework Harbor, um seinen Coding-Agenten PXI in frischen, reproduzierbaren Sandboxes zu testen.
- Ein Phoenix-Plugin speichert Harbor-Aufgaben als versionierte Datasets, Agentenkonfigurationen als Experimente und Verifier-Rewards als Annotationen.
- Dieselben Aufgaben und Verifier können PXI, Claude Code, Codex, einen MCP-Server und die Phoenix-CLI testen.
- In Arizes Test waren fast alle Antworten korrekt, doch die Traces offenbarten Unterschiede bei Turns und Tool-Aufrufen, etwa einen Codex-Workflow, der länger lief als nötig.
Warum einfache Agenten-Evals nicht ausreichten
Arize zufolge gehört das Offline-Experimentieren zu den schwierigsten Teilen der Agentenentwicklung. Ist ein Agent erst einmal im Einsatz, lässt sich sein Verhalten in der Praxis beobachten. Davor braucht ein Benchmark für jede Version dieselben Aufgaben, Daten, Tools und Umgebung, wobei der Zustand zwischen den Läufen zurückgesetzt wird.
Auf dieses Problem stieß das Unternehmen bei der Bewertung von PXI, dem in Phoenix integrierten Coding-Agenten. Die ersten Evals prüften PXIs Tool-Aufrufe in einzelnen Turns, doch das Team stieß an Grenzen. Den Fixtures fehlte Kontext, den normalerweise das Frontend liefert, etwa die aktuelle Seite und die Uhrzeit. Manche Tools liefen ohne das Frontend gar nicht. Ein MCP-Server für Skills und Dokumentation bedeutete eine weitere Komponente, die gemockt werden musste. Ohne echte Phoenix-Datenbank konnte das Team zwar prüfen, ob PXI ein Tool aufrief, aber kaum testen, was der Agent mit dem Ergebnis anfing.
Arize zufolge hätte eine Erweiterung dieser Suite bedeutet, immer mehr vom System nachzubauen oder zu mocken. Zudem sei es schwieriger geworden, darauf zu vertrauen, dass sich diese „Frankenstein-Version von PXI" wie die Produktivversion verhält.
So funktioniert Harbor
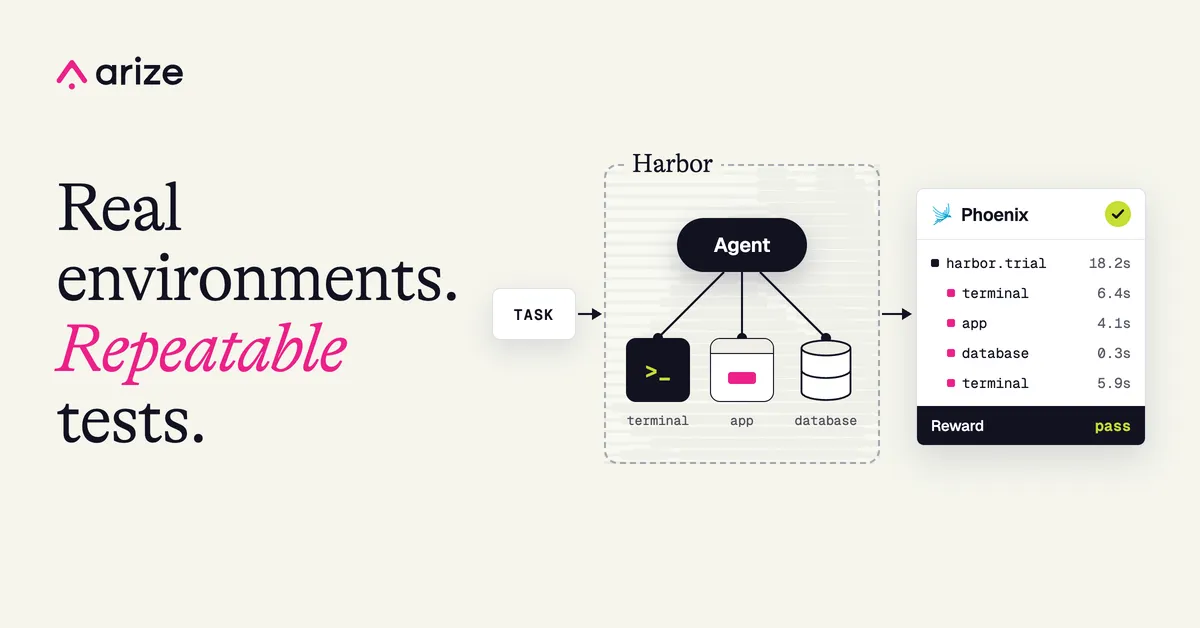
Harbor ist das Open-Source-Framework hinter Coding-Agenten-Benchmarks wie Terminal-Bench. Nutzer liefern eine Aufgabe, eine Umgebung mit ihrer Anwendung und ihren Daten sowie einen Verifier, der den Erfolg prüft. Jeder Versuch läuft in einer frischen Sandbox, entweder mit lokalem Docker oder bei einem unterstützten Cloud-Sandbox-Anbieter. Nachdem der Agent fertig ist, führt der Verifier Tests aus und vergibt daraus Rewards.
Für PXI hieß das: Der echte Agenten-Endpunkt läuft gegen einen Phoenix-Server, der mit Traces vorbefüllt ist. So konnte das Team testen, was PXI mit echten Tool-Ergebnissen anstellt, und anschließend die Datenbank untersuchen.
Harbor unterstützt neben eigenen Agenten auch Coding-Agenten wie Claude Code und Codex. Arize verwendet dieselben Aufgaben, um PXI, den eigenen MCP-Server und die Phoenix-CLI zu testen. Soll ein Agent fehlgeschlagene Traces annotieren, kann der Verifier prüfen, ob die Annotationen bei den richtigen Datenbankeinträgen angekommen sind. Außerdem lässt sich die Trajektorie des Agenten auswerten, um Turns und Tool-Aufrufe zu zählen. Laut Arize funktionieren dieselben Verifier agentenübergreifend und messen Korrektheit und Effizienz, ohne vorzuschreiben, wie jeder Agent die Aufgabe zu erledigen hat.
Ergebnisse in Phoenix festhalten
Das Phoenix-Plugin für Harbor speichert Aufgaben als versionierte Datasets, jede Agentenkonfiguration als Experiment und die Verifier-Rewards als Phoenix-Annotationen. Es wandelt die von Harbor aufgezeichnete Trajektorie in Phoenix-Traces um. Teams sehen so die Modellaufrufe, die Tool-Nutzung und die verfügbaren Nutzungsdaten hinter einem Reward, ohne den Agenten instrumentieren zu müssen.
- Alle Rewards aus den Harbor-Verifiern werden als Annotationen erfasst.
- Jeder Lauf erhält eine Annotation infra_ok, die Ausführungsfehler markiert.
- Ändern sich Aufgaben, entsteht eine neue Dataset-Version, während frühere Experimente an die Version gebunden bleiben, gegen die sie liefen.
Arize zufolge hilft die Versionierung, die Verbesserung eines Agenten von einer Änderung am Test zu unterscheiden. Die Ergebnisse stehen auch über den Phoenix-MCP-Server und die CLI bereit. Ein Coding-Agent kann dadurch Experimente vergleichen oder Traces untersuchen, während Menschen die Belege prüfen.
Was die Traces offenbarten
Arize ließ PXI, Claude Code und Codex dieselben Fragen zu einem Phoenix-Projekt beantworten. Fast alle Antworten waren korrekt, doch die Traces zeigten deutliche Unterschiede darin, wie die Agenten zum Ergebnis kamen. In einem Durchlauf diagnostizierte Codex ein fehlerhaftes Tool korrekt, folgte dann aber Arizes Error-Analysis-Skill in einen deutlich längeren Workflow, als die Frage erforderte. Die Erkenntnis laut Arize: Man sollte dem Agenten helfen, eine schnelle Diagnose von einer umfassenden Untersuchung zu unterscheiden. Der Benchmark kann nun prüfen, ob eine solche Änderung Turns und Tool-Aufrufe reduziert, ohne die Korrektheit zu beeinträchtigen.
Was das für Teams bedeutet, die Agenten entwickeln
Arize empfiehlt einen einfachen Ablauf: eine Aufgabe wählen, die Nutzern wichtig ist, dem Agenten eine realistische Umgebung geben, das Ergebnis prüfen, eine Baseline laufen lassen, den Trace untersuchen und dann einen Prompt, einen Skill oder ein Tool ändern und erneut testen. Das Unternehmen ergänzt, dass Optimierer wie GEPA, die Evaluierungs-Feedback nutzen, um Prompt-Änderungen vorzuschlagen und zu testen, Teile davon automatisieren könnten. Harbor-Aufgaben würden die Änderungen messen, Phoenix-Traces ihre Auswirkungen nachvollziehbar machen.
Teams, die einen MCP-Server, Skills oder eine CLI ausliefern, können denselben Ansatz nutzen, um zu sehen, ob Agenten diese effektiv einsetzen. Arize verweist auf den Harbor-Integrationsleitfaden und die interne Benchmark-Suite als Referenz und kündigt an, den Aufbau samt PXI-Benchmark am 8. Oktober 2026 in einer Live-Session vorzustellen.