Astera Labs stellt mit Orion eine GPU-unabhängige Rack-Scale-Referenzarchitektur vor
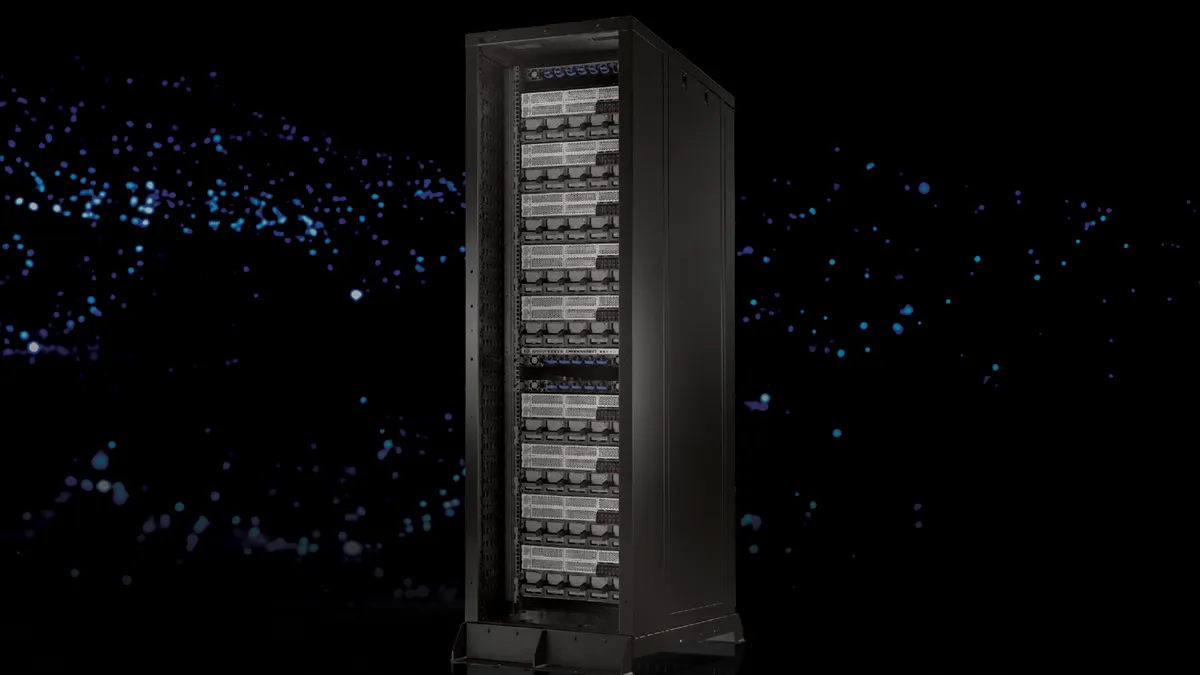
Astera Labs hat die Orion Rack-Scale Reference Architecture vorgestellt, eine Sammlung von Designs, die den Aufbau eines Racks von der Wahl des Beschleunigers trennt. Nach Angaben des Unternehmens können Neoclouds und Unternehmen ihre eigene XPU mitbringen und Inferenzkapazität schneller in Betrieb nehmen.
- Astera Labs hat die Orion Rack-Scale Reference Architecture vorgestellt, die unabhängig von einzelnen CPUs, GPUs oder XPUs ausgelegt ist.
- Orion ist als vollständiges Orion-Rack-System oder in beliebiger Kombination aus sechs modularen Designs für Compute, Speicher, Konnektivität und Software erhältlich.
- Das Unternehmen adressiert Neoclouds und Unternehmen und verweist auf den von JLL genannten Anteil von 11 % an der Rechenzentrumsnachfrage 2026 sowie auf Gartners Prognose von 20 % für 2030.
- Orion kommt gemeinsam mit ODM- und OEM-Partnern auf den Markt und wird am Stand B34 auf dem OCP Global Summit 2026 gezeigt.
Warum Astera Labs Orion entwickelt hat
Pravin Patel, Vice President und General Manager der Platform Solutions Group von Astera Labs, versteht Orion als Antwort auf einen Markt, in dem neue Anbieter Inferenzrechenleistung aufbauen, um eine anhaltend hohe Nachfrage zu bedienen. Er verweist auf JLL, laut denen Neoclouds 2026 einen Anteil von 11 % an der Nachfrage nach Rechenzentrumskapazität haben, sowie auf Gartner, das bis 2030 einen Anstieg dieses Anteils auf 20 % prognostiziert.
Neoclouds setzen laut dem Beitrag darauf, dass kostengünstige, von Inferenz getriebene Kapazität zu profitablen KI-Fabriken führt. Sie wollen ihren Kunden planbare, ergebnisbasierte Preise anbieten, die sich an Tokens pro Watt orientieren. Unternehmen wiederum bauen Rechenzentren für sichere, kostenkontrollierte und dedizierte KI-Kapazität.
Astera Labs argumentiert, dass beide Gruppen durch die Verfügbarkeit von Rechenleistung ausgebremst werden. Produktionsreife Architekturen beschränkten sich aus Sicht des Unternehmens auf wenige geschlossene Rack-Scale-Designs, deren Preise für Betreiber dieser Größenordnung nicht tragbar seien. Wer Rack-Scale-Systeme um alternative Rechenbeschleuniger herum baut, muss in der Regel lange und teure Validierungsphasen einplanen.
Was Orion umfasst
Orion ist eine Sammlung von Referenzdesigns, die von der Board-Ebene bis zum Rack-Maßstab reicht. Leitgedanke ist nach Aussage des Unternehmens, dass sich die Infrastruktur an die Rechenleistung anpassen soll und nicht umgekehrt. Indem die Rack-Architektur von einzelnen CPUs, GPUs oder XPUs entkoppelt wird, schafft Orion eine gemeinsame Grundlage für Compute, Fabric, Speicher und Management.
Kunden können einen Beschleuniger danach auswählen, wie gut er zu bestimmten Workloads passt, oder schlicht danach, ob er verfügbar ist, und behalten dabei einen einheitlichen Weg für Integration, Qualifizierung, Rollout und Betrieb. Orion wird als vollständiges, einsatzbereites Orion-Rack-System angeboten oder in beliebiger Kombination aus sechs modularen Designs für die Ebenen Compute, Speicher, Konnektivität und Software.
Astera Labs beschreibt den Ansatz nach eigenen Angaben als offen und modular. Orion kommt in Zusammenarbeit mit den ODM- und OEM-Partnern des Unternehmens auf den Markt, und jedes Design basiert auf Interconnect-Komponenten, die nach Angaben von Astera Labs in Millionen von Hyperscale-Einheiten im Einsatz sind.
- Wahlfreiheit statt Lock-in: Kunden können Beschleuniger nach Workload, Verfügbarkeit und Wirtschaftlichkeit auswählen.
- Schnellere Bereitstellung: Produktionsreife Referenzdesigns verringern den Aufwand für Integration und Validierung auf Rack-Ebene bei jeder neuen XPU.
- Rack-Intelligenz: Ein erweiterter COSMOS Rack and Fabric Manager dehnt Transparenz und Kontrolle von Silizium- und Flottendiagnose bis zu Leistungsüberwachung und Management auf Rack- und Fabric-Ebene aus.
- Token-Wirtschaftlichkeit: Skalierbare Fabric, In-Network Compute, Hypercast™ und über die Fabric angebundener Speicher sollen die Auslastung verbessern und effizientere Inferenz ermöglichen.
Was das für Neoclouds und Unternehmen bedeutet
Astera Labs nennt vier erwartete Vorteile für neuere Cloud-KI-Betreiber. Eine validierte, wiederholbare Architektur kann den Weg von der Verfügbarkeit eines Beschleunigers bis zum Produktivbetrieb verkürzen. Organisationen gewinnen die Flexibilität, auf einer breiteren Palette von Beschleunigern zu arbeiten, statt auf eine einzelne Plattform zu warten. Eine bessere Fabric-Effizienz und eine günstigere Speicherplatzierung können helfen, aus der eingesetzten Rechenleistung mehr Tokens pro Dollar herauszuholen. Ein einheitliches Rack- und Fabric-Management soll den Übergang von einzelnen Systemen zu Infrastruktur im großen Maßstab vereinfachen.
Das Unternehmen weist darauf hin, dass sich Rechenleistung weiter diversifiziert und für neue Workloads spezialisiert, und sagt, Betreiber könnten es sich nicht leisten, bei jeder Inbetriebnahme neuer Rechenleistung wieder bei null anzufangen. Dabei handelt es sich um Aussagen des Unternehmens selbst; Leistungsdaten, Preise oder Verfügbarkeitstermine für Orion nennt der Beitrag nicht.
Astera Labs zeigt einen vollständigen Aufbau der Architektur am Stand B34 auf dem OCP Global Summit 2026.