Blindtest zu KI-Webdesign: Menschen küren gpt-6-astra zum Spitzenreiter
In einer von HumanSignal durchgeführten Blindstudie zu menschlichen Präferenzen belegte gpt-6-astra unter zehn KI-Modellen, die Websites nach denselben Design-Briefings erstellten, mit einer Gewinnquote von 64,3 Prozent den ersten Platz. Nach Angaben des Unternehmens wiegt das jeweilige Briefing schwerer als die Gesamtrangliste: Sieben verschiedene Modelle gewannen mindestens ein Briefing.
- HumanSignal sammelte in 450 direkten Vergleichen von 10 Modellen bei 10 Design-Briefings 4.500 blinde Stimmen von 29 Annotatoren.
- Gpt-6-astra belegte mit einer Gewinnquote von 64,3 Prozent den ersten Platz vor grok-4.6 (62,7 Prozent) und muse-spark-1.3 (60,3 Prozent).
- Ein Bradley-Terry-Modell ergab laut Unternehmen dieselbe Reihenfolge von 1 bis 10 wie die Rangliste nach Gewinnquote.
- Sieben verschiedene Modelle gewannen mindestens ein Briefing, gpt-6-astra landete bei einem davon auf Rang 8.
- Inter tauchte in 53 von 100 kreativen Ausrichtungen auf, IBM Plex Mono in 34 und Fraunces in 25.
So lief die Studie ab
HumanSignal, das Unternehmen hinter Label Studio, gab Anfang des Monats 10 Modellen von 10 Laboren dieselben 10 Design-Briefings. Die Modelle durften keine Referenzen, Frameworks oder Websuche nutzen. Ziel war es laut Unternehmen, das Designverständnis der Modelle selbst zu erfassen: wo sie sich unterscheiden und wo sie übereinstimmen, wie sie ihre Designentscheidungen begründen und wie gut diese Entwürfe zu menschlichen Vorlieben passen.
Für die menschliche Bewertung führte das Team in Label Studio ein blindes, ausgewogenes Round-Robin-Turnier durch. Jedes Modell trat pro Briefing einmal gegen jedes andere an, was 450 direkte Vergleiche ergab. Bei 10 Stimmen pro Vergleich kamen 4.500 Stimmen von 29 Annotatoren zusammen. Die Annotatoren sahen zwei Websites nebeneinander ohne Modellnamen und wählten diejenige, die ihnen ästhetisch besser gefiel, oder markierten ein Unentschieden.
Die Gewinnquote vergibt für jede gewonnene Stimme einen ganzen Punkt, für jedes Unentschieden einen halben und für eine Niederlage keinen, geteilt durch die Zahl der Stimmen, an denen das Modell beteiligt war.
Die Rangliste
Gpt-6-astra führte mit einer Gewinnquote von 64,3 Prozent, gefolgt von grok-4.6 mit 62,7 Prozent und muse-spark-1.3 mit 60,3 Prozent. Das Mittelfeld bildeten deepseek-v4-pro (56,2 Prozent), kimi-k3 (53,3 Prozent) und glm-5.3 (53,2 Prozent). Claude-sonnet-5 kam auf 49,1 Prozent, qwen3.8-2.4t auf 48,9 Prozent. Gemini-3.8-flash landete mit 32,8 Prozent auf Rang neun und seed-2.0-code mit 19,1 Prozent auf dem letzten Platz.
HumanSignal passte zudem ein Bradley-Terry-Modell an die paarweisen Ergebnisse an, das für jedes Modell eine einzelne verborgene Stärke schätzt. Laut Unternehmen ergab sich dieselbe Reihenfolge von 1 bis 10. Das werte man als Beleg dafür, dass die Rangliste weder auf der Spielplanung noch auf einer unausgewogenen Paarung beruht. Der Spielplan war ausgewogen, sodass jedes Modell gleich oft gegen dieselben Gegner antrat.
Zwei Paarungen gelten als Gleichstand: kimi-k3 und glm-5.3, getrennt durch 0,1 Prozentpunkte, sowie claude-sonnet-5 und qwen3.8-2.4t, getrennt durch 0,2.
Warum eine einzelne Zahl in die Irre führen kann
Das Unternehmen warnt davor, allein die Gesamtrangliste zu zitieren. Sieben verschiedene Modelle belegten bei mindestens einem der 10 Briefings den ersten Platz. Gpt-6-astra gewann zwei Briefings klar, landete beim Briefing für eine medizinische Fachkonferenz aber nur auf Rang 8.
- glm-5.3 hatte außerhalb der Top drei den besten durchschnittlichen Briefing-Rang (4,5), schloss beim Briefing für eine Wissenschaftspublikation mit einer Gewinnquote von 24 Prozent jedoch als Letztes ab und kam insgesamt auf Rang 6.
- claude-sonnet-5 landete bei keinem Briefing besser als auf Platz 4 oder schlechter als auf Platz 9 und war damit das konstanteste Modell der Studie. Insgesamt reichte es trotzdem nur für Rang 7. In den Worten von HumanSignal machte Beständigkeit es nicht zu jemandes Favoriten.
Wer ein Modell für eine bestimmte Art von Designarbeit auswählen will, findet laut Unternehmen in den Ergebnissen ähnlicher Briefings mehr Orientierung als in der Gesamtreihenfolge.
Gemeinsame Designentscheidungen im Blick
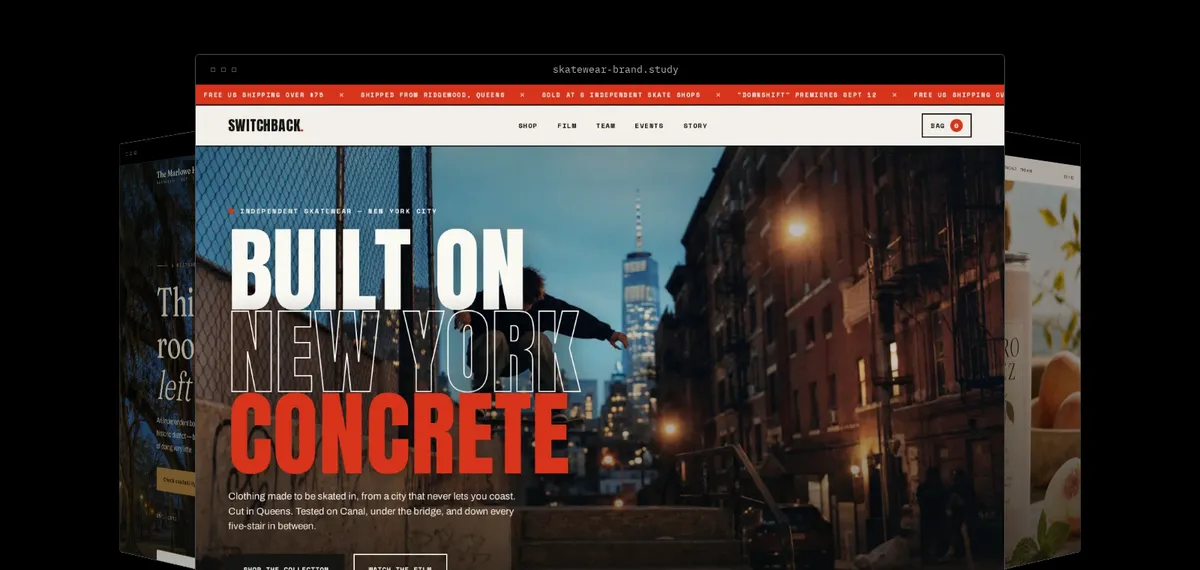
Das interaktive Dashboard hat vier Bereiche: die Entwürfe, die Entscheidungen, die Gesamtranglisten und gemeinsame Muster. Im Bereich Entwürfe lassen sich die zehn Websites je Briefing durchsehen, samt Kosten, Generierungszeit, der vom Modell genannten Gestaltungsrichtung und der menschlichen Bewertung. Der Bereich Entscheidungen vergleicht Schriftarten, Farbpaletten und die jeweilige Begründung der Modelle.
Der Bereich zu gemeinsamen Mustern zeigt eine auffällige Angleichung. Inter tauchte in 53 von 100 kreativen Ausrichtungen auf, IBM Plex Mono in 34 und Fraunces in 25. Das Dashboard weist außerdem wiederkehrende Farb- und Layoutentscheidungen aus. Die Ergebnisse stehen als JSON zum Download bereit, die Ranglisten und die Pilotmethodik als CSV, damit andere die Berechnungen nachprüfen können.
HumanSignal kündigt an, in den kommenden Wochen vertiefende Analysen der interessantesten Ergebnisse der Studie zu veröffentlichen.
Was das für Anwender bedeutet
Die Studie legt nahe, dass ein einzelner Platz in einer Rangliste wenig darüber aussagt, wie ein Modell bei einer konkreten Designaufgabe abschneidet. Da das Spitzenmodell bei einem Briefing nur auf Rang 8 kam und ein Modell aus dem Mittelfeld andere Briefings gewann, haben Teams bei der Modellauswahl für Designarbeit möglicherweise mehr davon, ihren eigenen Projekttyp mit den Ergebnissen pro Briefing abzugleichen. Die Daten sind öffentlich, sodass Leser die Stimmen und Begründungen selbst einsehen können.
HumanSignal (Label Studio): The industry trained an AI design monoculture. People preferred the models that broke from it.