Ein CatBoost-Modell sagt die Feinabstimmungsdauer weit genauer voraus als FLOPs
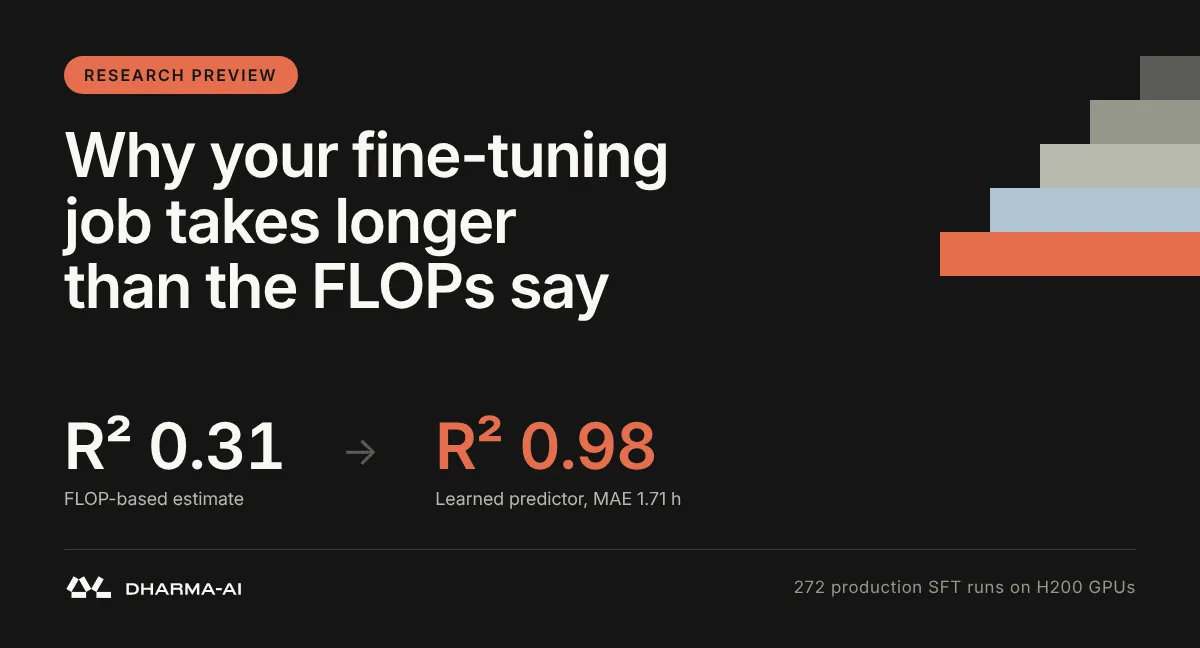
In einer Hugging-Face-Studie mit 272 Produktionsläufen sagte ein CatBoost-Modell die Gesamtdauer von Feinabstimmungsjobs deutlich genauer voraus als herkömmliche FLOP-Berechnungen. Das Modell erreichte in einer 5-fachen Kreuzvalidierung ein R² von 0.98 und einen mittleren absoluten Fehler von 1.71 Stunden.
- Die Studie analysierte 272 SFT-Produktionsläufe auf NVIDIA H200 GPUs.
- Die beste FLOP-Baseline erreichte einen mittleren absoluten Fehler von 12.41 Stunden.
- CatBoost erzielte ein R² von 0.98 und einen mittleren absoluten Fehler von 1.71 Stunden.
- Evaluierungs- und Checkpoint-Aktivitäten gehörten zu den wichtigsten Merkmalen des Modells.
- Das Modell nutzt Informationen, die vor der Zuweisung eines Jobs verfügbar sind.
Warum FLOP-Schätzungen nicht den gesamten Job erfassen
FLOP-basierte Schätzungen konzentrieren sich auf die Rechenarbeit innerhalb der Optimierungsschleife. Für einen dichten Transformer beschreibt die Quelle die Trainingskosten als etwa 6·P·D Gleitkommaoperationen, wobei P für die Zahl der Parameter und D für die Zahl der Trainingstokens steht. Dieser Wert wird anschließend durch die Zahl der GPUs, deren Spitzenleistung und eine angenommene Model FLOPs Utilization, kurz MFU, geteilt.
Dieser Ansatz erfasst nicht die gesamte tatsächliche Laufzeit. Vor Beginn des Trainings müssen Jobs möglicherweise die Umgebung einrichten, Modelle herunterladen, laden und tokenisieren. Während des Trainings können Evaluierungen durchgeführt und Checkpoints hochgeladen werden. Am Ende wird das fertige Modell in einen Objektspeicher übertragen. In einem gemeinsam genutzten Cluster konkurrieren diese Aktivitäten mit anderen Jobs um Netzwerk- und Speicher-I/O.
Die Studie testete FLOP-Baselines mit MFU-Werten von 30%, 45% und 60%. Die Einstellung mit 30% schnitt am besten ab, erreichte aber lediglich ein R² von 0.31 und einen mittleren absoluten Fehler von 12.41 Stunden. Bei 45% und 60% lag der mittlere absolute Fehler bei 13.01 beziehungsweise 14.62 Stunden.
Ein Modell auf Basis von Informationen, die vor dem Start verfügbar sind
Die Forschenden behandelten die Gesamtdauer als überwachte Regressionsaufgabe. Zielgröße war die verstrichene Zeit ab dem Moment, in dem ein Job seine GPUs erhielt, bis zu seinem Abschluss, ohne Wartezeit in der Warteschlange. Jede Eingabe musste vor dem Start verfügbar sein, darunter Hyperparameter, Datensatzgrößen, Modellkennungen und die GPU-Zuweisung.
Der Merkmalsumfang umfasste Konfigurations- und Modellmetadaten sowie abgeleitete Größen, die den operativen Overhead abbilden sollten. Dazu gehörten num_eval_data, also die Zahl der über alle Evaluierungszyklen verarbeiteten Beispiele, num_saves, num_params_saved und die Token-Mengen pro GPU. Die FLOP-Schätzung mit einer fest auf 0.45 gesetzten MFU wurde ebenfalls als Merkmal einbezogen. Dadurch konnte das Modell lernen, die reine Rechenschätzung anzupassen.
Das Team verglich Linear Regression, Ridge, XGBoost und CatBoost. Nach Merkmalsauswahl und einer Rastersuche anhand des mittleren absoluten Fehlers nutzte das finale CatBoost-Modell 24 Merkmale.
Ergebnisse aus 272 Produktionsläufen
Die Daten stammten aus 272 überwachten Feinabstimmungsläufen in einer Unternehmensproduktionsumgebung und repräsentierten rund 7,382 GPU-Stunden. Die Läufe umfassten mehrere Modellfamilien mit bis zu 15 Milliarden Parametern, LoRA- und vollständige Feinabstimmungen sowie eine große Bandbreite an Datensatzgrößen und Hyperparametern.
Die Jobs nutzten 1, 2 oder 4 GPUs aus Pools mit 8 bis 32 NVIDIA H200 GPUs über 1 bis 4 Knoten hinweg, neben anderen Trainings- und Inferenz-Workloads. Ihre gemessenen Laufzeiten reichten von 1.6 bis 172.4 Stunden. Die durchschnittliche Dauer betrug 23.43 Stunden, der Median lag bei 15.29 Stunden. Zum Software-Stack gehörten Hugging Face Transformers und Unsloth.
CatBoost erreichte ein R² von 0.98, einen RMSE von 3.52 Stunden und einen mittleren absoluten Fehler von 1.71 Stunden. XGBoost folgte mit einem R² von 0.97 und einem mittleren absoluten Fehler von 1.95 Stunden. Ridge kam auf einen mittleren absoluten Fehler von 7.23 Stunden, Linear Regression auf 7.52 Stunden. Calculon, ein detaillierteres analytisches Leistungsmodell, erreichte in diesem Vergleich ein R² von -0.51 und einen mittleren absoluten Fehler von 20.36 Stunden.
Warum die Ergebnisse für gemeinsam genutzte Cluster wichtig sind
In der Merkmalswichtigkeit von CatBoost standen Evaluierungs- und Checkpoint-Einstellungen neben Modell- und Workload-Variablen. num_eval_data belegte den ersten Platz, gefolgt von num_trainable_params, batch_eval_size_percent, num_all_params und num_gpus*batch_train_percent. Auch num_params_saved rangierte weit oben.
Über alle Out-of-Fold-Prognosen hinweg lag der mediane absolute Fehler bei 0.51 Stunden. Laut Quelle lagen 80% der Prognosen innerhalb von 2.20 Stunden und 90% innerhalb von 4.31 Stunden. Diese Schätzungen könnten Betreibern gemeinsam genutzter Cluster helfen, die Platzierung und Reihenfolge von Jobs anhand von Details zu planen, die bereits vor dem Start bekannt sind, statt sich ausschließlich auf die nominale Rechenleistung zu verlassen.
Die Forschenden beschreiben die Arbeit als Vorschau auf eine kommende Studie mit dem Titel Predicting End-to-End Fine-Tuning Time for Generative Language Models. Die vollständige Version werde dem Artikel zufolge bald auf arXiv veröffentlicht.
Hugging Face: Why your fine-tuning job takes longer than the FLOPs say