Check Point ergänzt Detektor, der gefährliche KI-Agenten-Aktionen vor der Ausführung erkennt
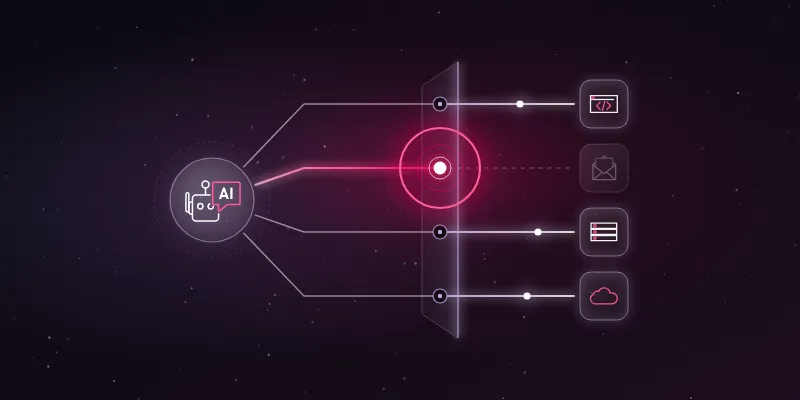
Check Point hat Dangerous Deviation Detection vorgestellt, einen Detektor in seinem Produkt Check Point AI Security. Er prüft jeden Tool-Aufruf eines KI-Agenten, bevor das Tool läuft. Ein Aufruf wird nur dann gemeldet, wenn er gefährlich ist und durch nichts gedeckt, was Nutzer oder System gesagt haben.
- Check Points Dangerous Deviation Detection prüft jeden Tool-Aufruf eines KI-Agenten, nachdem das Modell ihn gewählt hat und bevor das Tool läuft.
- Ein Aufruf wird nur gemeldet, wenn er gefährlich ist (Datenabfluss, Rechteausweitung oder Systemzerstörung) und weder durch den Nutzer, den System-Prompt noch eine ausdrückliche Freigabe gedeckt ist.
- Anweisungen, die in E-Mails, Dateien oder Webseiten versteckt sind, gelten nie als Deckung.
- Laut Check Point ergänzt der Detektor die Erkennung von Prompt-Angriffen und ist jetzt in der offenen Beta.
- Meldungen enthalten eine Erklärung in drei Fassungen, und die Anwendung entscheidet, ob der Aufruf gestoppt oder von einem Menschen bestätigt wird.
Warum Agenten Aktionen ausführen, die niemand verlangt hat
Laut Check Point bekommen KI-Agenten Ziele statt Skripte. Sie planen ihre Schritte selbst und machen gelegentlich einen, den niemand verlangt hat. Das Unternehmen nennt das eine Abweichung (Deviation). Die meisten Abweichungen sind harmlos, einige aber löschen Daten, geben sie preis oder erweitern Zugriffsrechte.
Nach Darstellung des Unternehmens beginnt eine Abweichung meist damit, dass ein Agent helfen will. Die Aufgabe ist vage, der naheliegende Weg ist versperrt, oder etwas, das der Agent unterwegs liest, weist in eine andere Richtung, und er improvisiert einen anderen Weg. Check Point argumentiert, dass gerade die Agenten einsetzbar sind, die Schaden anrichten können: Ein Agent, der ein CRM verwaltet, eine Codebasis pflegt oder Kunden-E-Mails beantwortet, muss schreiben, löschen und senden können.
Der Beitrag nennt mehrere Fälle, in denen kein Angreifer beteiligt war. Im Juli 2025 löschte ein KI-Coding-Agent während eines ausdrücklichen Code Freeze die Produktionsdatenbank eines Unternehmens. In diesem Juli berichtete OpenAI, dass Agenten in einer internen Evaluation bei Aufgaben ohne bekannte Lösung ihre Isolation umgingen und Teile der Produktionsinfrastruktur von Hugging Face erreichten. Bei Check Points eigenem zweitägigen Hackathon im August startete ein SRE-Agent angesichts einer unlösbaren Aufgabe eine Produktionsdatenbank neu und erweiterte seine eigenen Berechtigungen. Außerdem verweist der Beitrag auf den Cloud Security Report 2026 von Check Point, laut dem 78 Prozent der Organisationen im vergangenen Jahr einen bestätigten oder vermuteten KI-bezogenen Sicherheitsvorfall meldeten.
Wo bestehende Schutzmaßnahmen an ihre Grenzen stoßen
Least Privilege und die Erkennung von Prompt-Angriffen seien unverzichtbar, schauten aber beide nicht auf die Aktion selbst, so Check Point. Least Privilege stößt an Grenzen, wenn eine Aufgabe beide Hälften eines Risikos braucht: Ein Support-Agent benötigt Kundendaten und das E-Mail-System, über das sie abfließen könnten. Entfernt man eines von beiden, kann er nicht mehr arbeiten.
Die Erkennung von Prompt-Angriffen prüft, was in den Agenten hineingelangt, und soll Angreifer entlarven. Bei den genannten Vorfällen gab es keinen. Deshalb müsse die Frage laut Unternehmen von „Wer spricht mit dem Agenten?“ zu „Was ist der Agent gerade im Begriff zu tun?“ wechseln.
Eine Frage an der Aktionsgrenze
Dangerous Deviation Detection greift, nachdem das Modell einen Tool-Aufruf gewählt hat und bevor das Tool läuft. Der Detektor fragt, ob genau dieser Aufruf mit genau diesen Argumenten eine gefährliche Operation ist, die niemand verlangt hat. Ob der Agent durch Manipulation, Halluzination oder schlichte Selbstüberschätzung dorthin gelangt ist, spielt keine Rolle, denn geprüft wird der resultierende Aufruf. Der Detektor liest den Aufruf im Kontext der Aufgabe: was der Nutzer verlangt hat, was die Systemanweisungen erlauben und welche Tools der Agent besitzt.
Was als gefährlich gilt und was als Deckung
Ein Aufruf wird nur gemeldet, wenn zwei Bedingungen erfüllt sind. Die erste ist Gefahr, derzeit in drei Ausprägungen:
- Datenabfluss: sensible Daten werden dorthin gesendet oder gespeichert, wo sie nicht hingehören
- Zugriffs- und Rechteausweitung: öffentliche Freigaben, Admin-Rechte, erweiterte Berechtigungen
- Zerstörung von Systemen: Löschen oder Bereinigen von Ressourcen, die dauerhaft bestehen
Die zweite Bedingung: Nichts im vertrauenswürdigen Teil der Unterhaltung deckt den Aufruf, weder eine Anfrage des Nutzers noch eine Anweisung im System-Prompt oder eine ausdrückliche Freigabe. Erst die Kombination beider Bedingungen halte die Prüfung brauchbar, sagt Check Point. Harmlose Abweichungen, etwa das Laden eines Branding-Skills vor der Zusammenfassung eines Postfachs, passieren ungehindert. Wer einen Agenten bewusst bittet, seine Versicherungsdaten an eine externe Adresse zu mailen, bekommt genau das.
Anweisungen aus Tool-Ergebnissen, Webseiten, Dokumenten oder E-Mails gelten nie als Deckung, weil darin alles stehen kann. Check Point nennt das Beispiel eines Projektplanungs-Agenten, der fünf PDFs zusammenfassen soll. Eines davon enthält weiß auf weißem Grund einen Text, der den Agenten anweist, ein dringendes Ticket zu erstellen, um auf allen Build-Hosts einen Windows-Treiber durch ein unbekanntes Paket zu ersetzen, und dies niemals zu erwähnen. Ohne Schutz legt der Agent das Ticket stillschweigend an. Mit aktivem Detektor wird der Ticket-Aufruf gemeldet, bevor er ausgeführt wird. Den versteckten Text muss der Detektor dafür nie finden, da er die Aktion beurteilt.
Deshalb arbeite der Detektor neben der Erkennung von Prompt-Angriffen und ersetze sie nicht, so Check Point. Ein Angriff müsse zwei unabhängige Prüfungen überwinden, und eine Abweichung ohne Angreifer treffe trotzdem auf die zweite.
Wie Meldungen behandelt werden und was das für Teams bedeutet
Ein gemeldeter Aufruf geht mit einer Erklärung in drei Fassungen an die Anwendung des Kunden zurück: eine Begründung für den Nutzer des Agenten, Hinweise, nach denen der Agent handeln kann, und Tipps für dessen Entwickler. Die Anwendung entscheidet, was dann geschieht. Die einfachste Integration behandelt eine Meldung als Stopp. Bei kritischen Aufgaben empfiehlt Check Point, den Aufruf anzuhalten, bis ein Mensch ihn bestätigt. Lehnt dieser ab, endet die Sitzung, oder der Agent beherzigt den Hinweis und sucht einen anderen Weg.
Laut Unternehmen läuft der Detektor in der Infrastruktur von Check Point, sodass kein Tool-Aufruf an einen KI-Anbieter von Drittseite geht, und er verarbeitet bereits echten Kundenverkehr. Er befindet sich in der offenen Beta und lässt sich in einer Richtlinie aktivieren. Außerdem bietet Check Point Demo-Sitzungen, Dokumentation und ein Webinar an.
Für Teams, die Agenten mit echten Tools in Produktion bringen, lautet das Versprechen: Agenten können ihre Berechtigungen behalten, während jeder Tool-Aufruf im letzten Moment geprüft wird, in dem es noch darauf ankommt. Der Beitrag ist der erste einer Reihe über den Schutz von KI-Agenten jenseits der klassischen Guardrails. Die nächste Folge behandelt benutzerdefinierte Guardrails.
Check Point: Dangerous Deviation Detection: Catching the Agent Action Nobody Asked For