Clockwork.io sammelt 31 Millionen Dollar ein: LinkedIn und Together AI setzen auf Software gegen GPU-Ausfälle
Clockwork.io, Anbieter von Software für Fehlertoleranz beim KI-Training, beim Reinforcement Learning und bei der Inferenz, hat 31 Millionen Dollar frisches Kapital eingesammelt. Zudem meldet das Unternehmen den Produktiveinsatz bei LinkedIn und Together AI, eine breitere Nutzung bei WhiteFiber sowie zwei neue Funktionen für TorchPass.
- Clockwork.io hat 31 Millionen Dollar eingesammelt und Produktiveinsätze bei LinkedIn und Together AI angekündigt.
- LinkedIn zufolge verhindert LinkPass in der gesamten Flotte jeden Monat Zehntausende ungenutzte GPU-Stunden.
- TorchPass erhält Multinode-Plattform-Snapshots und schnelle asynchrone Anwendungs-Checkpoints für Reinforcement Learning.
- Together AI bietet TorchPass als Service auf seinen GPU-Clustern an, WhiteFiber weitet die Nutzung der Software aus.
Warum Ausfälle im KI-Maßstab so teuer sind
Große verteilte KI-Jobs können sich über Tausende GPUs erstrecken, die synchron bleiben müssen. Laut Clockwork.io kann der Ausfall einer einzelnen GPU, einer defekten Verbindung oder eines abgestürzten Servers den gesamten Job zum Stillstand bringen.
Das Unternehmen verweist auf Meta, das bei einem 54-tägigen Training von Llama 3 auf 16.384 GPUs unerwartete Unterbrechungen im Schnitt etwa alle drei Stunden meldete. Üblicherweise lädt man dann einen Checkpoint, also eine gespeicherte Kopie des Job-Fortschritts. Laut Clockwork.io kann diese Wiederherstellung bis zu 90 Minuten dauern, lässt gesunde GPUs brachliegen und zwingt die Teams, alle Arbeitsschritte seit dem Checkpoint zu wiederholen. Kunden zahlen für ungenutzte GPUs und redundante Berechnungen, und die Modelle werden später fertig.
Was Clockwork.io anbietet
Clockwork.io bietet eine Reihe von Werkzeugen für Fehlertoleranz, die Plattform-Teams als Schicht zwischen Hardware und Workload einsetzen. Laut Unternehmen sind zwei Produkte bereits produktiv im Einsatz:
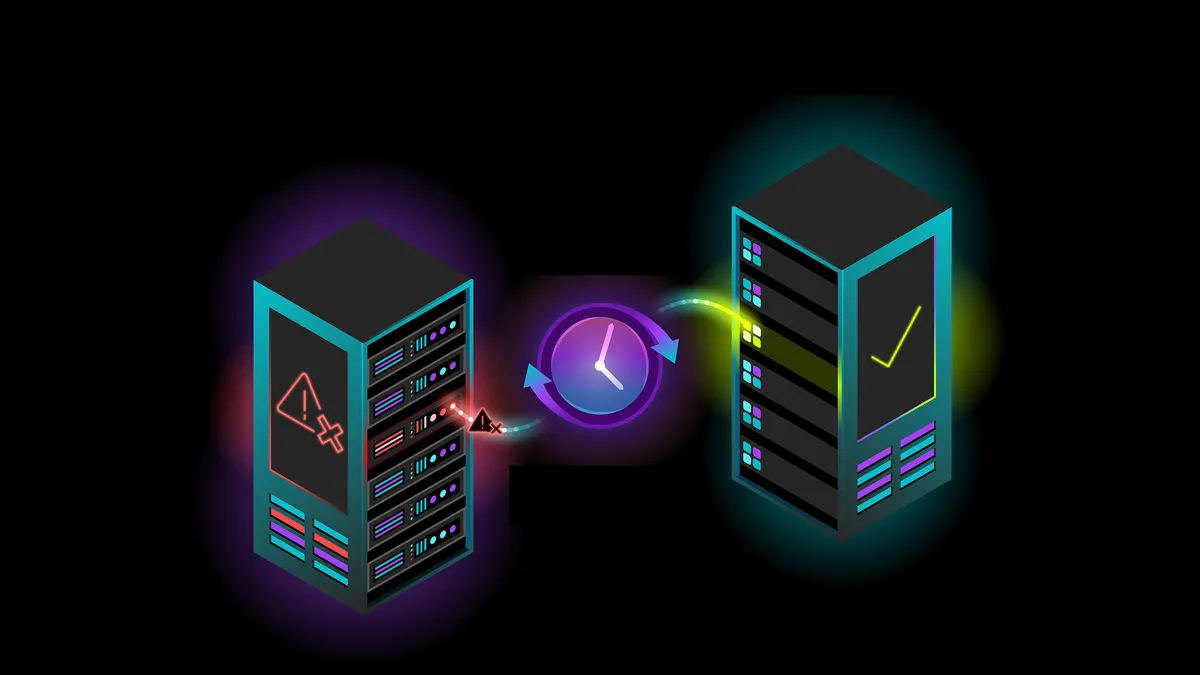
- LinkPass leitet den Datenverkehr um eine ausgefallene Netzwerkverbindung herum, sodass der Job den Fehler gar nicht bemerkt.
- TorchPass verlagert einen Workload von einer fehlerhaften GPU auf eine funktionierende, sodass das Training ohne Rückschritt auf einen früheren Stand weiterlaufen kann.
Nun hat das Unternehmen TorchPass um zwei Fähigkeiten erweitert. Multinode-Plattform-Snapshots, die als branchenweit erstmalig für das Training beschrieben werden, sichern den gesamten Job über alle Knoten hinweg, ohne dass der Trainingscode angepasst werden muss, sodass er später wiederhergestellt werden kann. Sie sind für Ausfälle gedacht, die zu schwerwiegend sind, um allein per Migration behoben zu werden. Schnelle, asynchrone Anwendungs-Checkpoints laufen im Hintergrund, während der Job weiterarbeitet, und beschleunigen das Reinforcement Learning. Sie liefern aktualisierte Modellgewichte an die Inferenz-Replikate, die die Rollouts erzeugen, also die Beispiele, aus denen das Modell lernt. Diese Replikate warten so weniger oft oder arbeiten seltener mit einem veralteten Modell.
CEO Suresh Vasudevan sagte: "Los fallos son inevitables a la escala de la IA; perder horas de trabajo útil debido a ellos no debería ocurrir."
Kunden: LinkedIn, Together AI und WhiteFiber
LinkedIn hat LinkPass in seiner gesamten KI-Infrastruktur ausgerollt. Laut der Ankündigung verhindert das, dass jeden Monat Zehntausende GPU-Stunden durch Leerlauf verloren gehen. Raghu Hiremagalur, Senior Vice President und Leiter der Infrastrukturtechnologie bei LinkedIn, sagte, vor Clockwork.io habe ein Flap einer InfiniBand-NIC einen Server mit acht GPUs außer Betrieb setzen können, und ein Flap eines Switch-Ports einen zweiten Server lahmlegen, wodurch sich die Auswirkung auf 16 GPUs verdoppelt habe.
Together AI bringt TorchPass als Service auf seinen GPU-Clustern auf den Markt. Auf der PyTorch-Konferenz planen beide Unternehmen eine Live-Demonstration eines Multinode-Trainingsjobs, der trotz bewusst herbeigeführter Netzwerk- und GPU-Fehler ohne Neustart weiterläuft. Pavneet Ahluwalia, Produktleiter bei Together AI, sagte, Kunden bewerteten das Unternehmen anhand des Goodput, also des Anteils der GPU-Stunden, der das Modell tatsächlich voranbringt.
WhiteFiber (NASDAQ: WYFI), bereits Kunde, weitet den Einsatz der Software in seiner GPU-as-a-Service-Infrastruktur aus. Tom Sanfilippo, der Chief Technology Officer des Unternehmens, sagte, das automatisierte Flottenaudit von Clockwork.io prüfe jede Verbindung und jeden Knoten gleichzeitig und finde Fehler innerhalb weniger Minuten, sodass sie behoben werden könnten, bevor ein Cluster an einen Kunden übergeben wird.
Was das bedeutet
Die Ankündigung zeigt, dass Fehlertoleranz vom Forschungsthema zum Produkt wird, das Unternehmen, Hyperscaler und Neocloud-Anbieter kaufen, um den Anteil der GPU-Stunden für nützliche Arbeit zu erhöhen. Je größer die Jobs werden, desto mehr GPU-Zeit steht bei jedem Neustart auf dem Spiel. Genau diese Kosten will Clockwork.io mit seinen Werkzeugen senken. Die Finanzierung verschafft dem Unternehmen die Mittel, diesen Ansatz über das Training hinaus auf Reinforcement Learning und Inferenz auszudehnen.
PR Newswire: Clockwork.io recauda 31 millones de dólares