Cloudflares Auto Router wählt das Modell pro Anfrage und senkt KI-Kosten um bis zu 30 Prozent
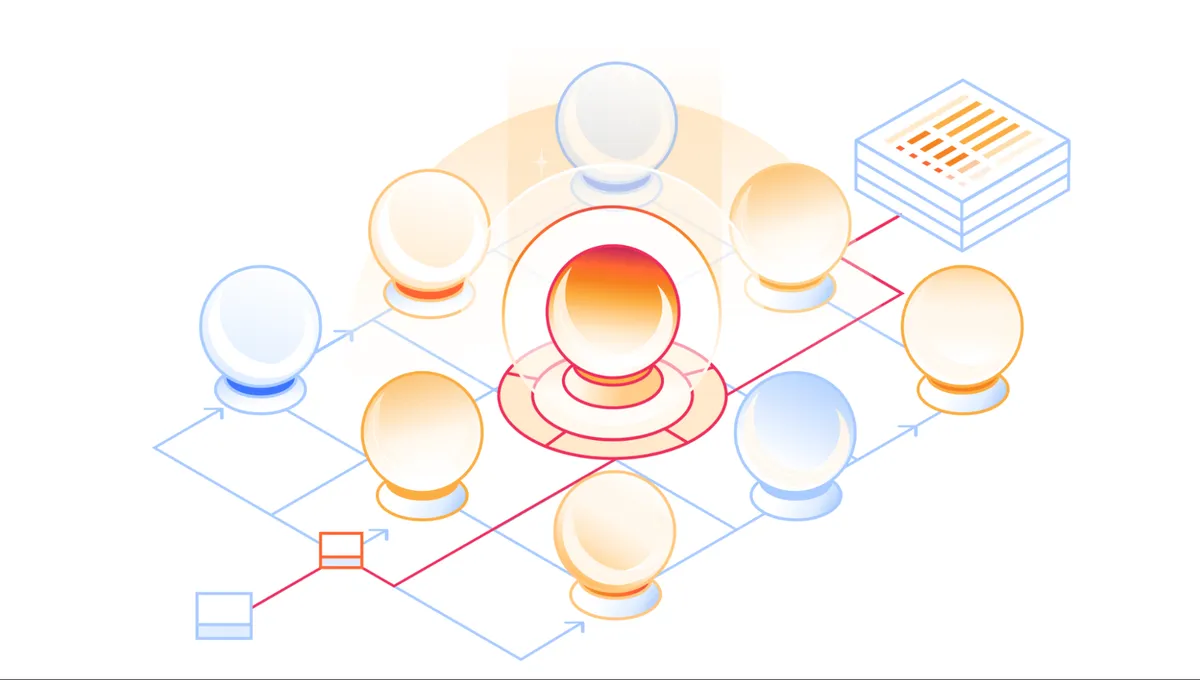
Cloudflare hat Auto Router als Public Beta im AI Gateway veröffentlicht. Wer als Modell cloudflare/auto einstellt, überlässt dem Gateway die Entscheidung, welches Modell für die jeweilige Aufgabe leistungsfähig genug ist, und zwar Anfrage für Anfrage. Nach Angaben des Unternehmens zeigen erste interne Ergebnisse Einsparungen von bis zu 30 Prozent im Vergleich zur ausschließlichen Nutzung von Frontier-Modellen.
- Cloudflares Auto Router ist als Public Beta über AI Gateway verfügbar; Nutzer stellen als Modell cloudflare/auto ein.
- Cloudflare berichtet aus der internen OpenCode-Nutzung von Einsparungen von bis zu 30 % gegenüber der ausschließlichen Nutzung von Frontier-Modellen.
- Im internen Benchmark erreichte auto 86,6 % bei 0,0084 $ pro Erfolg, Claude Opus 5.5 96,6 % bei 0,0210 $ und GPT-6 Sol 84,2 % bei 0,0108 $.
- Ein Klassifikator auf Workers AI bewertet Aufgabenkategorie und vier Schwierigkeitsdimensionen, der Router wägt Qualität gegen Kosten und Cache-Wechselabzüge ab.
- Cloudflare plant weitere Router wie cloudflare/auto-best.
Einsparungen, um die sich Nutzer nicht kümmern müssen
Cloudflare zufolge wollen Unternehmen, die ihre KI-Nutzung formalisieren, die Ausgaben für Tokens steuern und überwachen. Budgets und Regeln stoßen dabei aber an Grenzen. In den Worten des Unternehmens: "The best savings are the ones users never notice." (Die besten Einsparungen sind die, die Nutzer nie bemerken.)
In vielen Harnesses, darunter OpenCode, Claude Code und Codex, wählen einzelne Nutzer Modelle weiterhin manuell aus. Laut Cloudflare landen Menschen dabei oft bei Modellen, die für ihre Arbeit überdimensioniert sind. Eine E-Mail oder einen Chatverlauf zusammenzufassen, erfordere zum Beispiel keine Intelligenz auf Opus-Niveau. Ein solches Modell würde das Unternehmen einem Security-Engineering-Team aber auch nicht grundsätzlich sperren wollen.
Cloudflare möchte AI Gateway als Control Plane für Organisationen etablieren, die KI intern einsetzen. Da bereits jede Anfrage jedes Nutzers, Agenten und Tools durch das Gateway läuft, kann es im Auftrag der Nutzer Entscheidungen treffen, statt sich allein auf Budgets, Ausgabenlimits und identitätsbezogene Analysen zu verlassen.
Was der interne Benchmark zeigt
Cloudflare setzt Auto Router intern in seiner OpenCode-Installation und in Cloudflare OS ein, dem eigenen Agent-Harness. Bei Coding-Aufgaben berichtet das Unternehmen von Ergebnissen, die mit Frontier-Modellen vergleichbar sind. Am besten schneide der Router bei einer breiten Palette von Wissensarbeit ab, die technische wie nicht technische Teams abdeckt.
Das Unternehmen verglich cloudflare/auto in einem internen Benchmark für allgemeine Wissensarbeit mit GPT-6 Sol von OpenAI und Claude Opus 5.5 von Anthropic. Der Benchmark nutzt simulierte Workspace-Tools und deckt E-Mail, Kalender, Slack, Dateien, Reisen und Finanzen ab. Er umfasst 97 Aufgaben, mit drei Durchläufen pro Modell und Aufgabe. Die Ergebnisse:
- cloudflare/auto: 252/291 erfolgreiche Durchläufe, Erfolgsquote 86,6 %, Gesamtkosten 2,10 $, 0,0084 $ pro Erfolg.
- Anthropic Claude Opus 5.5: 281/291, 96,6 %, Gesamtkosten 5,91 $, 0,0210 $ pro Erfolg.
- OpenAI GPT-6 Sol: 245/291, 84,2 %, Gesamtkosten 2,64 $, 0,0108 $ pro Erfolg.
Laut Cloudflare lag Auto Router bei 80 % der Kosten von Sol und 35 % der Kosten von Opus, mit einer Leistung, die anderen modernsten Alltagsmodellen ähnelt. Opus 5.5 hatte in der Tabelle weiterhin die höchste Erfolgsquote. Niedrigere Token-Preise bedeuten laut Unternehmen nicht immer geringere Kosten pro Ergebnis, denn ein scheinbar günstigeres Modell könne unverhältnismäßig mehr Tokens verbrauchen, um ein Problem zu lösen.
So funktioniert das Routing
Trifft eine Anfrage ein, stellt AI Gateway zunächst einen Pool von Modellen zusammen, die sie bedienen können. Es filtert Modelle heraus, die das Anfrageformat oder den Ausführungsmodus nicht unterstützen, und berücksichtigt Zugangsdaten, Abrechnungskonfiguration, Zugriffsrichtlinien und Ausgabenlimits. Anbieter oder Modelle mit Störungen werden während eines Ausfalls entfernt und nach dessen Ende wieder in den Pool aufgenommen.
Anschließend betrachtet der Router eine kompakte Darstellung des Gesprächs und gewichtet die neuesten Beiträge stärker. Ein Multi-Head-Klassifikationsmodell, das auf Workers AI läuft und auf GPUs im Edge-Netzwerk von Cloudflare bereitgestellt ist, weist 14 Aufgabenkategorien wie Coding, Planung, Recherche und Datenanalyse Wahrscheinlichkeiten zu. Zudem bewertet es die Anfrage auf einer Skala von eins bis fünf in vier Dimensionen: Komplexität, Mehrdeutigkeit, Tragweite und Abhängigkeit vom früheren Kontext.
Eine Scoring-Matrix verknüpft diese Signale mit den Benchmark-Ergebnissen der Modelle, um zu schätzen, wie gut jedes Modell passt. Der Router wägt dann die erwartete Qualität gegen die Preise für Ein- und Ausgabe-Tokens des jeweiligen Modells ab. Bei einfachen Anfragen fällt der Preis stärker ins Gewicht, bei schwierigeren wird der Kostenabzug abgemildert. Cloudflare fasst das so zusammen: utility = expected quality - adaptive cost penalty.
Bei langen agentischen Sitzungen berücksichtigt der Router außerdem die Cache-Kosten. Ein Modellwechsel verwirft den Cache und zwingt das neue Modell, den gesamten Kontext erneut zu schreiben. Deshalb wendet der Router einen Wechselabzug an, der mit den bereits im Kontext befindlichen Tokens wächst. Innerhalb eines Turns bleibt er bevorzugt beim selben Modell. Das Ergebnis ist eine Rangliste: AI Gateway probiert zuerst den Spitzenreiter und kann auf ein anderes geeignetes Modell ausweichen, falls der Anbieter die Anfrage nicht bedienen kann.
Was das für Teams bedeutet
Cloudflare nennt mehrere Vorteile des Designs. Da Aufgabenklassifikator und Scoring-Matrix getrennte Stufen sind, sind die Routing-Entscheidungen nachvollziehbar: Teams können die vorhergesagte Kategorie und Komplexität einer Aufgabe einsehen und sehen, wie daraus eine Modellwahl wurde. Wird ein neues Modell veröffentlicht, muss der Router nicht neu trainiert werden, denn Cloudflare ergänzt lediglich dessen aus Benchmarks abgeleitete Gewichte in der Scoring-Matrix.
Das Unternehmen plant zudem weitere Router, darunter cloudflare/auto-best, der dieselbe Klassifikation und denselben Modellpool nutzen, aber ohne Kostenabwägung die höchste erwartete Qualität auswählen soll. Außerdem soll der Router bei einem Wechsel bevorzugt innerhalb derselben Modellfamilie bleiben, da die meisten Modelle die Reasoning-Tokens anderer Modelle nicht lesen können.
Für Organisationen lautet das Versprechen: geringere Ausgaben, ohne dass Beschäftigte ihre Gewohnheiten ändern müssen, während Nutzer weiterhin Zugriff auf die leistungsfähigsten Modelle haben, wenn ihre Arbeit sie erfordert. Die Zahlen stammen aus Cloudflares eigenem internen Benchmark und der eigenen Nutzung, in anderen Umgebungen können die Ergebnisse abweichen.
Cloudflare: Cut your AI spend with AI Gateway's Auto Router