Convergent Science und CoreWeave testen GPU-Skalierung für Turbulenzsimulationen
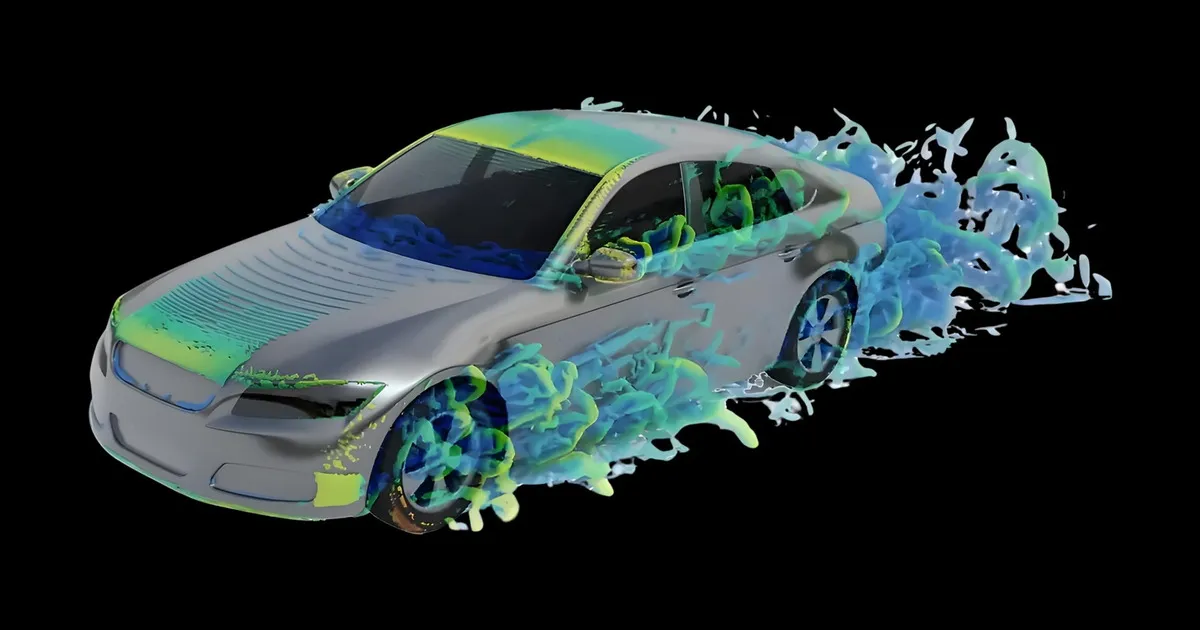
Convergent Science und CoreWeave haben die Software CONVERGE CFD auf NVIDIA-Blackwell-GPUs laufen lassen, um Genauigkeit und Skalierung des Solvers zu prüfen. Als Testmethode diente die direkte numerische Simulation (DNS), der anspruchsvollste Ansatz der numerischen Strömungsmechanik. Laut CoreWeave lief der größte Testfall mit 536 Millionen Zellen auf 16 GPUs in 3,62 Stunden durch.
- Convergent Science und CoreWeave ließen CONVERGE CFD auf NVIDIA RTX PRO 6000 Blackwell Server Edition und NVIDIA HGX B200 laufen.
- Die Tests nutzten die direkte numerische Simulation, den genauesten CFD-Ansatz, an einem klassischen Fall abklingender Turbulenz.
- Ein Fall mit 536 Millionen Zellen lief laut CoreWeave auf 16 Blackwell-GPUs in zwei HGX-B200-Instanzen in 3,62 Stunden durch.
- Die Studie trennt Weak von Strong Scaling sowie die GPU-Kommunikation innerhalb eines Servers von der zwischen Servern.
- Die Autoren raten, GPU-CFD-Aufträge zuerst nach Speicher und erst danach nach FLOPS zu dimensionieren.
Warum Turbulenzsimulation den Rechenbedarf antreibt
CoreWeave beginnt seinen Bericht mit dem Argument, Turbulenz sei weiterhin ein ungelöstes Problem, das für die Kühlung von Mikroprozessoren, die Aerodynamik von Fahrzeugen, Verbrennungsmotoren, Kernreaktoren, Schiffe und die Fertigung relevant ist. Zitiert wird eine Zahl, wonach rund 30 % des weltweiten Energieverbrauchs im Verkehr dafür aufgewendet werden, den Strömungswiderstand zu überwinden, wobei Turbulenz die Hauptursache sei. Ein besseres Verständnis von Turbulenz könne den weltweiten CO₂-Ausstoß senken und Kraftstoffkosten sparen.
Die Navier-Stokes-Gleichungen, die Strömungen beschreiben, haben nur für eine Handvoll einfacher Fälle analytische Lösungen. Für alles andere setzen Ingenieure auf numerische Strömungsmechanik (Computational Fluid Dynamics, CFD), die die Gleichungen numerisch löst. Die Genauigkeit hängt vom Netz, den numerischen Verfahren und den gewählten physikalischen Modellen ab. Automobilhersteller und andere Erstausrüster (OEMs) rechnen deshalb mit immer größeren und detaillierteren Simulationen, und der Rechenbedarf steigt mit.
Der Testaufbau: DNS auf zwei NVIDIA-Hardwareklassen
Das Projekt verfolgte zwei Ziele: Es sollte die Genauigkeit des CONVERGE-GPU-Solvers anhand eines etablierten Testfalls validieren und messen, wie er auf zwei unterschiedlichen Hardwareklassen skaliert, nämlich NVIDIA RTX PRO 6000 Blackwell Server Edition und NVIDIA HGX B200.
Das Team entschied sich für die direkte numerische Simulation. Das Arbeitspferd der Industrie ist Reynolds-Averaged Navier-Stokes (RANS): Ein Turbulenzmodell schätzt dabei die Bewegung auf kleinen Skalen ab, und man nimmt einen gewissen Fehler für einen bezahlbaren Rechenaufwand in Kauf. DNS verzichtet auf das Modell und berechnet jede Skala direkt. Der Preis sind sehr kleine Zellen und sehr kurze Zeitschritte, sodass der Aufwand in Raum und Zeit wächst. Den Autoren zufolge hat ein Cluster, das die härteste Last der CFD bewältigt, bei Alltagsfällen reichlich Reserven.
Alle Läufe nutzten denselben klassischen Fall: eine turbulente Strömung, die in einem dreidimensionalen rechteckigen Raum mit der Zeit Energie verliert. Der Basisfall hatte rund 16,8 Millionen Zellen.
- Weak Scaling auf dem RTX PRO Server: 2 GPUs mit etwa 16,8 Mio. Zellen, 4 GPUs mit etwa 33,6 Mio. und 8 GPUs mit etwa 67,1 Mio.
- Strong Scaling auf dem RTX PRO Server: 2, 4 und 8 GPUs bei etwa 67,1 Mio. Zellen.
- Weak Scaling auf der HGX B200: 1 GPU mit etwa 33,6 Mio. Zellen, 2 GPUs mit etwa 67,1 Mio. und 4 GPUs mit etwa 134,2 Mio.
- Strong Scaling auf der HGX B200: 8, 12 und 16 GPUs bei etwa 268,4 Mio. Zellen.
Außerhalb der Testmatrix erweiterte das Team den 512³-Fall in einer Richtung um das Vierfache auf 536 Millionen Zellen und ließ ihn auf zwei HGX-B200-Instanzen laufen, also auf 16 Blackwell-GPUs. Dieser Lauf ist nicht Teil der Skalierungsstudie, da er zeigt, wie weit das System reicht, nicht aber, wie effizient es skaliert.
Strong und Weak Scaling, innerhalb und zwischen Servern
Der Artikel unterscheidet zwei Arten der Skalierung. Beim Strong Scaling bleibt der Fall gleich, und es kommen GPUs hinzu, um schneller fertig zu werden. Beim Weak Scaling wachsen Fall und GPU-Anzahl gemeinsam, sodass ein größerer Auftrag ungefähr so lange dauert wie der kleinere. Die Autoren stellen das Weak Scaling in den Vordergrund, weil OEMs größere, detailliertere Fälle wollen und nicht schnellere Versionen bestehender. Das Strong Scaling dient als Prüfung, wie viel Geschwindigkeit sich für einen bestehenden Fall erkaufen lässt. Sie weisen darauf hin, dass die reale Skalierung stets hinter dem Idealwert zurückbleibt.
Außerdem unterscheiden sie, wo die GPUs sitzen. Intranode bedeutet GPUs innerhalb eines Servers, verbunden per PCIe beim RTX PRO Server oder per NVIDIA NVLink bei der HGX B200, das deutlich schneller ist. Internode bedeutet GPUs über mehrere Server hinweg, hier verbunden über NVIDIA Quantum-2 InfiniBand mit 400 Gb/s. Die Autoren sehen darin den Grund, warum veröffentlichte Skalierungswerte so oft nicht vergleichbar sind: Das Ergebnis hängt vom GPU-Speicher, der Verbindung im Server oder dem Netzwerk zwischen den Servern ab.
Was das für die Dimensionierung von GPU-CFD-Aufträgen bedeutet
Der praktische Rat des Artikels an alle, die GPU-Kapazität für Simulationen einkaufen: Der Speicher entscheidet, ob ein Fall überhaupt läuft, die FLOPS nur, wie schnell. Die Zellzahl zeigt, wie groß ein Auftrag ist, aber nicht, wie viel Speicher er braucht. Das hängt von der aktivierten Physik ab, etwa von den verfolgten chemischen Spezies in einem Verbrennungsfall, und von der numerischen Genauigkeit, denn doppelte Genauigkeit verdoppelt die gespeicherten Werte. Auch die Solver-Methode spielt eine Rolle.
Die Autoren warnen, dass DNS weniger Gleichungen enthält als die RANS-Modelle des industriellen Alltags, ein Produktionsfall mit gleicher Zellzahl dürfte daher mehr Speicher benötigen. Der vorliegende Quelltext endet mitten in dieser Erörterung zur Dimensionierung.
CoreWeave: Convergent Science Advances Engineering Simulation on CoreWeave