CoreWeave nennt sich erster Cloud-Anbieter mit NVIDIA-H200-GPUs
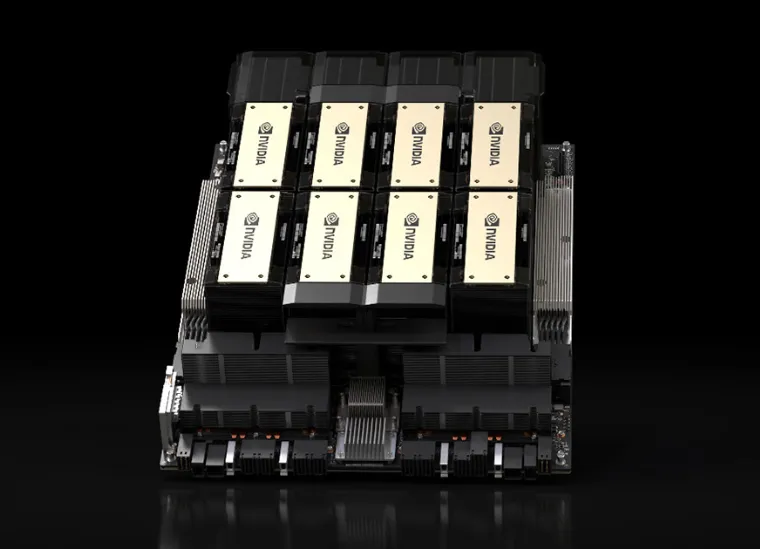
CoreWeave bringt nach eigenen Angaben als erster Cloud-Anbieter NVIDIA H200 Tensor Core GPUs auf den Markt. Die H200-Instanzen laufen laut Unternehmen in Clustern mit bis zu 42.000 GPUs und kommen mit verwalteten Werkzeugen für Zuverlässigkeit, Orchestrierung und Observability.
- CoreWeave bringt nach eigenen Angaben als erster Cloud-Anbieter NVIDIA H200 Tensor Core GPUs auf den Markt.
- Die H200 bietet laut Unternehmen 4,8 TB/s Speicherbandbreite und 141 GB HBM3e sowie bis zu 1,9-fache Leistung gegenüber der H100.
- Die Instanzen kombinieren Intel-Xeon-CPUs der fünften Generation, BlueField-3 DPUs und 3200Gbps Quantum-2 InfiniBand in Clustern mit bis zu 42.000 GPUs.
- Mission Control, CKS, SUNK und Observability Services übernehmen Zuverlässigkeit, Orchestrierung und Überwachung.
- CoreWeave will nach eigenen Angaben bald zu den Ersten gehören, die NVIDIA Blackwell anbieten.
H200-Instanzen: Hardware und angegebene Leistung
CoreWeave beschreibt den Start als Erweiterung seines Angebots an High-End-GPUs von NVIDIA und seines wachsenden Portfolios an verwalteten Cloud-Diensten für generative KI. Das Unternehmen bezeichnet sich selbst als AI Hyperscaler™.
Laut CoreWeave bietet die NVIDIA H200 Tensor Core GPU eine Speicherbandbreite von 4,8 TB/s und 141 GB HBM3e-GPU-Speicher. Das trage dazu bei, dass die Leistung bis zu 1,9-mal so hoch ausfalle wie bei H100-GPUs.
In den H200-Instanzen von CoreWeave sind die GPUs mit weiteren Komponenten kombiniert:
- Intels Xeon-CPUs der fünften Generation (Emerald Rapids)
- NVIDIA Bluefield-3 DPUs, die Netzwerk, Storage und andere Verwaltungsfunktionen der Knoten übernehmen
- 3200Gbps NVIDIA Quantum-2 InfiniBand-Netzwerk
Die Instanzen werden in Clustern mit bis zu 42.000 GPUs bereitgestellt. Das liefere die höchste Leistung der Branche und senke für Kunden Zeit und Kosten beim Training generativer KI-Modelle, so CoreWeave.
Das Unternehmen verweist auf seine Erfahrung mit der Vorgängergeneration. Es sei im November 2022 einer der ersten Cloud-Anbieter gewesen, die NVIDIA-HGX-H100-Instanzen in Betrieb genommen hätten. Im Benchmark MLPerf v3.0 habe CoreWeave nach eigenen Angaben den schnellsten Supercomputer der Welt gebaut: Er habe eine vollständige GPT-3-LLM-Workload mit 3.500 H100-GPUs in weniger als 11 Minuten trainiert, 4,4-mal schneller als der nächstbeste Wettbewerber.
Mission Control, CKS und SUNK
CoreWeave argumentiert, jede GPU-Generation bringe 2- bis 3-mal mehr Rechenleistung als die vorherige, erhöhe aber auch die Komplexität, wenn Knoten und Systeme ausfallen. Die Plattform Mission Control soll hier ansetzen. Laut Unternehmen prüft sie, ob die Hardware korrekt verbunden, auf dem neuesten Stand und getestet ist. Proaktive Gesundheitschecks liefen automatisch auf inaktiven Knoten und tauschten problematische aus, bevor sie Ausfälle verursachten. Umfassendes Monitoring erkenne Hardwarefehler schneller, sodass Unterbrechungen von Trainingsjobs kürzer und günstiger ausfielen. Zwei Komponenten, der Fleet LifeCycle Controller (FLCC) und der Node LifeCycle Controller (NLCC), arbeiten dafür zusammen.
Für den Aufbau der Cluster bietet CoreWeave den CoreWeave Kubernetes Service (CKS) an, ein verwaltetes Kubernetes-Produkt für KI-Anwendungen. Laut Unternehmen nutzen CKS-Cluster Bare-Metal-Knoten ohne Hypervisor sowie eine Architektur auf Basis von NVIDIA BlueField DPUs mit clusterprivaten VPCs für Isolation und Beschleunigung.
Außerdem bietet CoreWeave Slurm on Kubernetes (SUNK) an. Es integriert Slurm als Kubernetes-Scheduler, sodass Slurm-Jobs innerhalb von Kubernetes laufen. Burst- und Batch-Workloads könnten damit eine gemeinsame Plattform und einen gemeinsamen Rechenpool nutzen, und Kunden könnten sowohl die Kubernetes- als auch die Slurm-Seite parallel verwenden, so das Unternehmen.
Observability und der Blick nach vorn
Die CoreWeave Observability Services liefern Kunden Metriken auf Knoten- und Systemebene als Ergänzung zu Mission Control. Fehler können laut Unternehmen von falscher Konfiguration durch Nutzer, etwa bei der Speicherzuweisung, über fehlerhafte Software-Updates und defekte Serverkomponenten bis hin zu Problemen im schnellen Netzwerk zwischen den Knoten reichen. Kunden können Alarme und Dashboards für einen ganzen Cluster oder für einzelne Jobs einrichten und laut CoreWeave die Ursachen binnen Minuten ermitteln.
Für die Zukunft kündigt CoreWeave an, bald zu den Ersten zu gehören, die die NVIDIA-Blackwell-Plattform anbieten. Zudem habe das Unternehmen seit Beginn des Jahres 2024 weltweit neun neue Rechenzentren eingerichtet, 11 weitere seien in Arbeit, und für 2025 rechne es mit dem Start von 10 weiteren.
Für KI-Teams bedeutet die Ankündigung Zugang zu H200-Kapazitäten, gebündelt mit verwalteter Orchestrierung und Überwachung aus einer Hand. Angaben zu Preisen oder Verfügbarkeit enthält die Quelle nicht, und die Leistungszahlen stammen vom Unternehmen selbst.