CoreWeave meldet erste MLPerf-Ergebnisse mit NVIDIA Vera Rubin über mehrere Racks
CoreWeave eigenen Angaben zufolge hat der Anbieter als erster Cloud-Anbieter Ergebnisse mit NVIDIA Vera Rubin über mehrere Racks in MLPerf Training v6.1 vorgelegt, darunter einen Lauf für DeepSeek-V3 671B über 256 GPUs in 17,65 Minuten. Zudem meldet das Unternehmen das schnellste Ergebnis der Runde für Llama 3.1 8B auf 72 GPUs.
- CoreWeave hat Ergebnisse mit NVIDIA Vera Rubin über mehrere Racks in MLPerf Training v6.1 eingereicht.
- DeepSeek-V3 671B erreichte auf 256 Vera-Rubin-GPUs in 17,65 Minuten die Zielqualität.
- Llama 3.1 8B benötigte auf einem einzelnen Vera-Rubin-Rack mit 72 GPUs 7,16 Minuten.
- Reinforcement Learning für Qwen3.5 397B dauerte auf 256 GB200-GPUs 22,78 Minuten.
- CoreWeave zufolge laufen die Vera-Rubin-NVL72-Systeme bereits im Produktivbetrieb.
Vera Rubin erreicht die Zielqualität schneller
MLPerf Training v6.1 misst, wie lange ein KI-System benötigt, um ein definiertes Modell auf eine festgelegte Zielqualität zu trainieren. CoreWeave reichte Ergebnisse in der Kategorie Available der Closed Division für NVIDIA Vera Rubin NVL72- und NVIDIA GB200 NVL72-Systeme ein.
Die Einreichungen deckten Modelle mit 8 Milliarden bis 671 Milliarden Parametern ab. Die Konfigurationen reichten dabei von einem einzelnen Rack mit 72 GPUs bis zu 256 GPUs über vier Racks.
Nach Angaben von CoreWeave trainierte das NVIDIA-Vera-Rubin-NVL72-System mit vier Racks DeepSeek-V3 671B, ein Mixture-of-Experts-Modell, in 17,65 Minuten auf die Zielqualität. Die Einreichung mit NVIDIA GB200 NVL72 benötigte bei derselben GPU-Anzahl 48,40 Minuten. CoreWeave berechnete daraus eine Verbesserung um den Faktor 2,7, wies jedoch darauf hin, dass der Geschwindigkeitsvorteil aus veröffentlichten Ergebnissen von MLCommons abgeleitet und nicht von der MLCommons Association überprüft wurde.
Schnelles Ergebnis für Llama 3.1 8B mit einem Rack
CoreWeave meldete außerdem eine Zeit von 7,16 Minuten bis zur Zielqualität für Llama 3.1 8B auf einem einzelnen Rack mit Vera Rubin NVL72. Das Unternehmen bezeichnete dies auf Grundlage seiner Analyse der veröffentlichten MLPerf-Training-v6.1-Ergebnisse von MLCommons als schnellste Einreichung der Runde mit 72 GPUs.
CoreWeave verglich das Ergebnis mit seiner 13,70-minütigen Einreichung auf GB200 NVL72 mit derselben GPU-Anzahl und berechnete eine Verbesserung um den Faktor 1,9. Nach Angaben des Unternehmens kamen auf beiden Plattformen NVFP4-GEMMs, FP8-Attention und vollständige NVIDIA-CUDA-Graphen zum Einsatz.
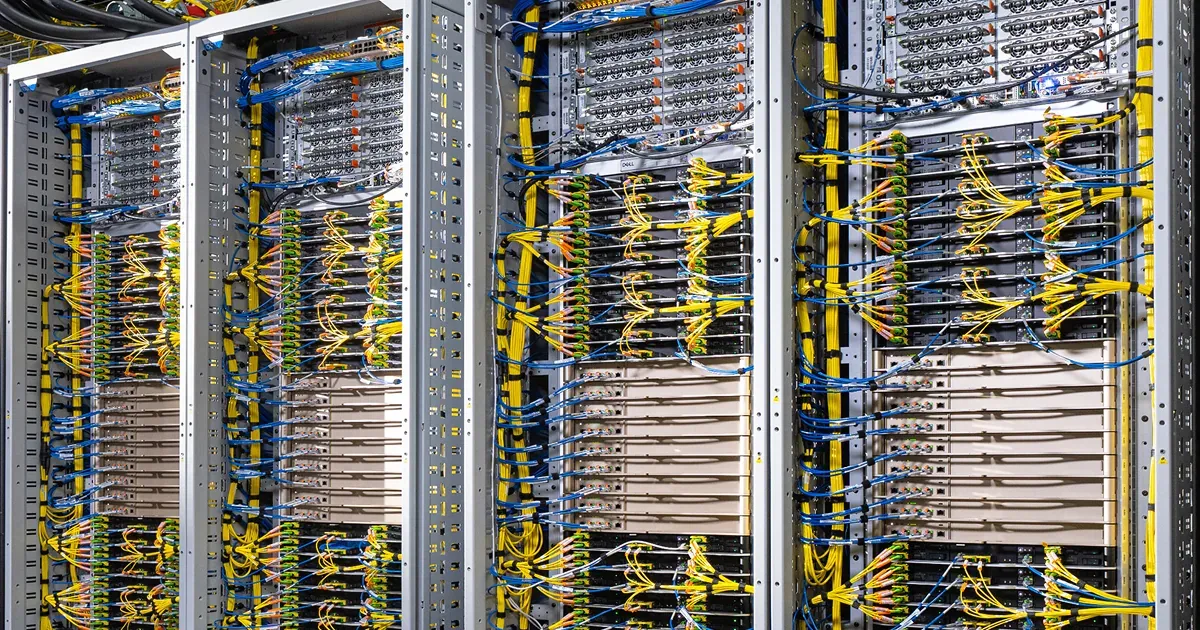
CoreWeave verband seine Systeme über mehrere Racks mit einer RoCE-basierten NVIDIA-Spectrum-X-Ethernet-KI-Fabric, die auf 102,4 Tb/s Spectrum-6-Netzwerktechnik und NVIDIA ConnectX-9 SuperNICs setzt. Diese Infrastruktur soll laut Unternehmen die Kommunikationsverzögerungen zwischen den Racks beim verteilten Training reduzieren.
Das breitere Bild der Workloads
Zu den Benchmark-Einreichungen gehörten außerdem das Pretraining des Reasoning-Modells GPT-OSS 20B sowie Reinforcement Learning für Qwen3.5 397B auf NVIDIA GB200 NVL72. CoreWeave schloss den Qwen3.5-Workload auf 256 GPUs über vier Racks in 22,78 Minuten ab. Dabei kamen 128 GPUs für das Training und 128 für die Generierung zum Einsatz.
Nach Angaben von CoreWeave ist die Qwen3.5-Einreichung der erste Benchmark für das Post-Training eines Large Language Models in MLPerf Training. Das Unternehmen erklärte, der Workload teste die Koordination von Modellerzeugung, Evaluierung und Optimierung über viele GPUs hinweg und nicht das Workload-Muster eines herkömmlichen Pretrainings.
CoreWeave erklärte, seine Vera-Rubin-NVL72-Systeme liefen bereits im Produktivbetrieb. Kunden könnten daher die Full-Stack-Entwicklung des Unternehmens für Trainings-Workloads über mehrere Racks nutzen. Dieser Ansatz kombiniert Rechenleistung, Netzwerk, Orchestrierung, Software und den Flottenbetrieb. Mission Control koordiniert dabei die Platzierung und den Betrieb von Workloads über mehrere Cluster hinweg.