CoreWeave und NVIDIA: KI-Fabriken müssen sich vor dem Produktivbetrieb bewähren
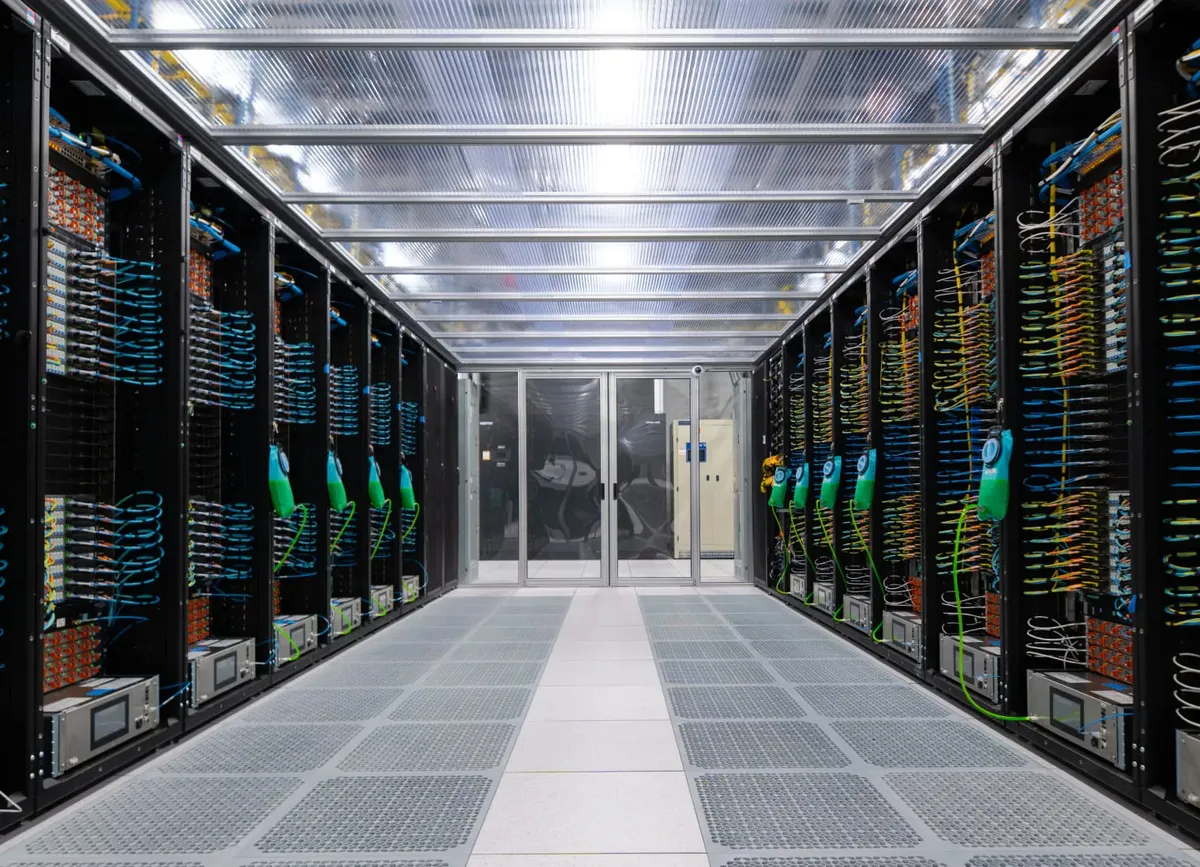
CoreWeave argumentiert, dass der Besitz von GPUs allein nicht mehr genügt, um für KI-Workloads gerüstet zu sein. Der gesamte Stack müsse gemeinsam entworfen und validiert werden, bevor Kunden sich darauf verlassen. In einem Blogbeitrag beschreibt das Unternehmen seine Zusammenarbeit mit NVIDIA, sein Validierungslabor ARENA und eine Reihe von Benchmark-Ergebnissen.
- Laut CoreWeave bedeutet KI-Einsatzbereitschaft heute, dass der gesamte Stack wochenlang zusammenhält, nicht nur dass GPUs im Rack stehen.
- CoreWeave meldet, dass Vera Rubin NVL72 bei derselben DeepSeek-R1-Last pro Megawatt zehnmal so viele Tokens pro Sekunde lieferte wie GB200 NVL72.
- Im MLPerf Training v6.0 absolvierte CoreWeave DeepSeek-V3 671B in 2,02 Minuten auf 8.192 Blackwell-Ultra-GPUs.
- Mit CoreWeave ARENA können Kunden Training, Inferenz und Agenten-Pipelines vor dem Einsatz auf Infrastruktur in Produktionsqualität testen.
Warum GPUs allein keine Einsatzbereitschaft mehr belegen
Laut CoreWeave war der alte Test simpel: GPUs ins Rack einbauen, mit Strom versorgen, kühlen und warten, bis die Dashboards auf Grün springen. Echte KI-Workloads stellen jedoch andere Anforderungen. Rechenleistung, Netzwerk, Storage, Scheduling und Wiederherstellung müssen zwei Wochen am Stück zusammenhalten, ohne an den Nahtstellen ins Stocken zu geraten.
Als Treiber der steigenden Anforderungen nennt das Unternehmen agentische Workloads. Nutzer wollen nicht auf Ergebnisse warten, und ein Agent, der Tools aufruft oder eine mehrstufige Reasoning-Schleife durchläuft, kann zu jeder Tageszeit Lastspitzen auslösen. Teams müssten ihre Infrastruktur daher auf schwankende Nachfrage vorbereiten, und KI-Clouds dürften Zuverlässigkeit nicht der Geschwindigkeit opfern, so CoreWeave.
Die Kosten eines Ausfalls sind dem Beitrag zufolge konkret. Ein hängender Job kann GPU-Ressourcen binden und Projektzeitpläne verzögern. Ein verlorener Checkpoint bedeutet, Arbeit auf derselben wertvollen Hardware noch einmal zu erledigen. Und ungenutzte Ressourcen verursachen trotzdem Kosten.
Co-Design mit NVIDIA, von der Planung bis zum Netzwerk
CoreWeave zufolge entwerfen das Unternehmen und NVIDIA gemeinsam eine Full-Stack-Plattform für Modellentwickler, Unternehmen und KI-native Firmen. NVIDIA liefert die Plattform für beschleunigtes Computing, CoreWeave die KI-native Cloud-Software und die Betriebsebene. Im Januar 2026 wurde die Zusammenarbeit ausgeweitet, um die Vera-Rubin-Plattform auf CoreWeave mit der NVIDIA-DSX-Plattform bereitzustellen. Der Beitrag beschreibt DSX als NVIDIAs Referenzdesign für Planung, Bau und Betrieb von KI-Fabriken.
CoreWeave nach eigenen Angaben kürzlich erste Benchmarks veröffentlicht, laut denen Vera Rubin NVL72 bei derselben DeepSeek-R1-Last pro Megawatt zehnmal so viele Tokens pro Sekunde erzeugte wie NVIDIA GB200 NVL72.
Netzwerk, Kühlung, Storage und Software würden gemeinsam geplant, bevor der Spatenstich für ein Rechenzentrum erfolgt, so das Unternehmen. Beim Netzwerk setzt es sowohl auf NVIDIA Spectrum-X Ethernet als auch auf NVIDIA Quantum InfiniBand, dazu auf CoreWeave AI Object Storage mit LOTA für die Datenbereitstellung. Nach eigenen Angaben gehörte CoreWeave zu den ersten Cloud-Anbietern, die den NVIDIA Spectrum-X Ethernet SN6600-LD einsetzten, den laut Beitrag branchenweit ersten vollständig flüssigkeitsgekühlten Ethernet-Switch mit 102,4 Tb/s. Zudem gehört es zu den frühen Anwendern des Co-packaged-Optics-Netzwerks NVIDIA Photonics.
Exemplar Cloud, MLPerf und das ARENA-Labor
NVIDIA Exemplar Cloud ist eine Validierungsinitiative, die die Leistung pro TCO an realen statt an synthetischen Workloads misst. CoreWeave gibt an, zu den Ersten gehört zu haben, die den Exemplar-Cloud-Status für Training auf NVIDIA GB200 NVL72 erreichten. Die Validierung lief auf einem Cluster aus 576 Blackwell-GPUs, verbunden über NVIDIA Quantum-2 InfiniBand und optimiert durch CoreWeave Mission Control; dabei wurden NVIDIAs Leistungsreferenzwerte für großskaliges Training erreicht. Außerdem meldet CoreWeave eine Exemplar-Cloud-Validierung für Inferenz auf Blackwell-GPUs mit DeepSeek-R1, Llama 3.3 und GPT-OSS.
CoreWeave zufolge war es im vergangenen Jahr der erste KI-Cloud-Anbieter, der NVIDIA GB300 NVL72 bereitstellte, und habe diese Systeme mit CKS, SUNK, Observability und dem Rack LifeCycle Controller innerhalb weniger Wochen in Betrieb genommen.
Im MLPerf Training v6.0 hat das Unternehmen nach eigenen Angaben den Benchmark DeepSeek-V3 671B auf 8.192 Blackwell-Ultra-GPUs in 2,02 Minuten abgeschlossen. Das war der größte GB300-NVL72-Cluster der Runde, und die Laufzeit sank beim Verdoppeln des Clusters nahezu linear. Im MLPerf Training v5.0 reichten CoreWeave, NVIDIA und IBM den damals größten gebenchmarkten GB200-NVL72-Cluster ein und absolvierten Llama 3.1 405B in 27,3 Minuten. Das ist laut Beitrag mehr als doppelt so schnell wie Hopper-basierte Systeme bei gleicher Clustergröße.
Für Kunden bietet CoreWeave ARENA an, ein Validierungslabor im Produktionsmaßstab. Teams führen dort Trainingsjobs, Inferenz-Workloads und Agenten-Pipelines auf Infrastruktur in Produktionsqualität aus, um Engpässe aufzudecken sowie Skalierungs- und Kostenverhalten vor dem Einsatz zu prüfen, mit reproduzierbaren Ergebnissen. Das Labor betreibt denselben Stack wie beim Kunden, darunter GPU-Compute, CKS, Slurm und SUNK, AI Object Storage mit LOTA, Netzwerk und Mission Control.
Was das für Kunden bedeutet
CoreWeaves Botschaft lautet, dass Käufer von KI-Infrastruktur Belege dafür erwarten sollten, wie sich ein Stack unter realer Last verhält, bevor sie Produktiv-Workloads darauf verlagern. Mit ARENA könnten Kunden Skalierungseigenschaften und Kostentreiber vorab kennenlernen, statt sie erst im Produktivbetrieb zu entdecken, so das Unternehmen. Der Beitrag ist der erste Teil einer Serie; ein zweiter Teil soll behandeln, wie der Stack im großen Maßstab läuft und in die nächste Hardwaregeneration übergeht.
CoreWeave: Why AI Factories Need Proof Before Production