CoreWeave zeigt, wie das Unternehmen Multi-Rack-Cluster mit NVIDIA Vera Rubin NVL72 in Betrieb nimmt
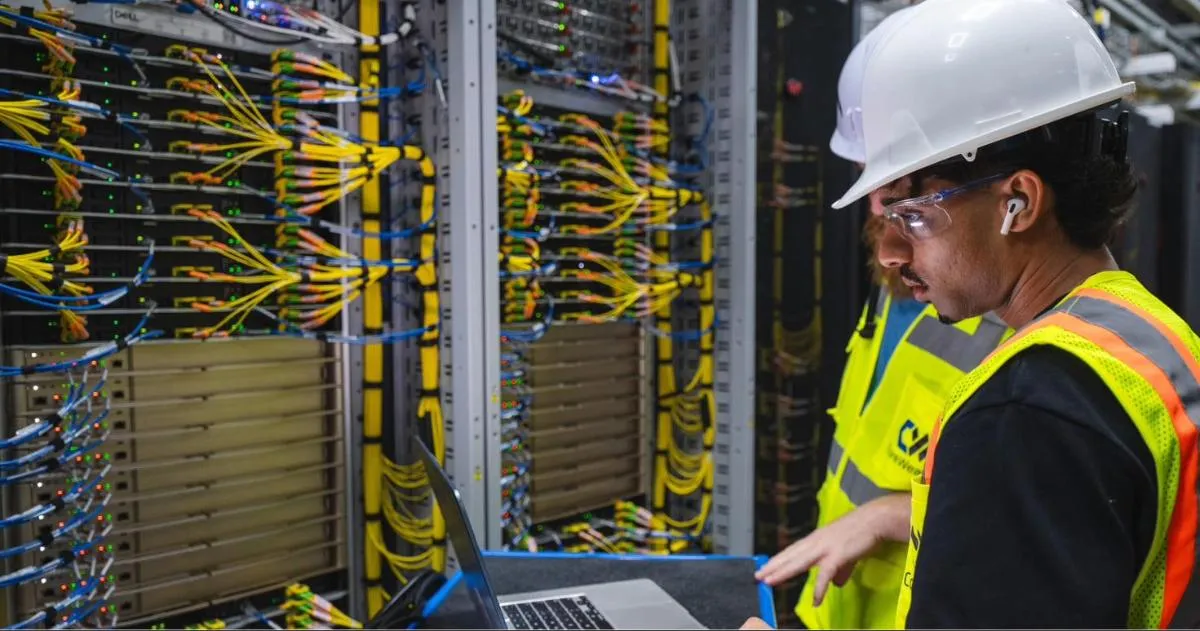
CoreWeave hat Einblicke veröffentlicht, wie es Multi-Rack-Cluster aus NVIDIA Vera Rubin NVL72 Systemen in Betrieb nimmt. In dieser Größenordnung seien Rechenleistung, Netzwerk, Stromversorgung und Flüssigkühlung voneinander abhängig und müssten gemeinsam getestet werden. Nach eigenen Angaben war CoreWeave der erste Cloud-Anbieter, der ein Vera Rubin NVL72 in Betrieb genommen und validiert hat.
- CoreWeave sagt, es sei der erste Cloud-Anbieter gewesen, der ein NVIDIA Vera Rubin NVL72 in Betrieb genommen und validiert hat.
- Das Unternehmen erweiterte Mission Control um Racky für das Rack-Management und Valvey für die programmierbare Steuerung der Flüssigkühlung.
- Die Validierung reicht von der Knoten- über die Rack- bis zur Multi-Rack-Fabric-Ebene, leistungsschwache Racks gehen in die Fehlersuche.
- Das RoCE-Fabric ist zweistufig und blockierungsfrei, mit bis zu 1,6 Tb/s Backend-Anbindung pro GPU.
- Laut CoreWeave lässt sich das Design auf rund 128.000 GPUs ausdehnen.
Vom einzelnen Rack zum verteilten System
CoreWeave beschreibt ein einzelnes NVIDIA Vera Rubin NVL72 Rack als gemeinsam entworfenes System mit 72 NVIDIA Rubin GPUs, 36 Vera CPUs, dem NVIDIA NVLink 6 Scale-up-Fabric, ConnectX-9 SuperNICs, BlueField-4 DPUs, schnellem Speicher, Stromversorgung und einer Flüssigkühlung mit 45 °C.
Wer mehrere Racks verbindet, steht laut dem Unternehmen vor einer anderen technischen Aufgabe. Hunderte Rubin GPUs, mehrere NVLink-Domänen, Tausende Netzwerkverbindungen, Kühlung, Strom, Firmware und Software müssten sich wie ein System verhalten. CoreWeave nennt die Risiken: Eine langsame GPU kann zum Nachzügler für den gesamten Cluster werden, eine grenzwertige Netzwerkverbindung kann die Leistung bei kollektiven Operationen beeinträchtigen, eine Kühlungsanomalie kann zu Drosselung oder zum kompletten Ausfall führen, und eine inkonsistente Konfiguration lässt sich kaum diagnostizieren, sobald Hunderte GPUs gleichzeitig kommunizieren.
Als Erfahrungsbasis für Vera Rubin verweist das Unternehmen auf frühere Installationen mit NVIDIA L40S, H200, GB200 NVL72, GB300 NVL72 und RTX PRO 6000.
Automatisierung und Validierung vor dem Produktivbetrieb
Neue Infrastruktur durchläuft bei CoreWeave einen automatisierten Lebenszyklus. Sobald die Hardware angeschlossen und der Flüssigkühlkreislauf bereitgestellt ist, erkennt die Automatisierung neue Baseboard Management Controller der Knoten, prüft Seriennummern, richtet Zugangsdaten ein und überführt die Knoten in eine Staging-Umgebung. Dort verifiziert das Unternehmen die Hardware, aktualisiert Firmware, hinterlegt Metadaten und validiert die Systeme, bevor sie in Richtung Produktion weiterlaufen.
Für Vera Rubin hat CoreWeave seine Mission-Control-Software um Racky, eine Steuerungsebene für das Rack-Management, und Valvey, den programmierbaren Ansatz zur Steuerung der Flüssigkühlung, erweitert. Beide arbeiten mit dem Rack LifeCycle Controller zusammen und stellen Stromversorgung, Kühlkreislauf und Umgebungssensorik auf denselben softwaredefinierten Lebenszyklus wie die Rechenknoten.
Die Validierung ist mehrstufig. Auf Knotenebene führt CoreWeave stundenlang wiederholte GPU-Diagnosen durch, testet den Datentransfer zwischen CPU und GPU, prüft GPU-zu-GPU-Verbindungen und lässt rechenintensive sowie realistische Trainings-Workloads laufen. Auf Rack-Ebene kommen Standard- und eigene Benchmarks zum Einsatz, die NVLink-Kommunikation wird getestet, und eng synchronisierte Jobs laufen über alle 72 GPUs. Racks, die unter dem erwarteten Bereich liegen, gehen in die Fehlersuche statt in die Produktion. In der letzten Stufe laufen verteilte Workloads über mehrere Racks, wobei der Datenverkehr gezielt über das Backend-Netzwerk geleitet wird.
Zweistufiges, blockierungsfreies RoCE-Fabric
Zwischen den Racks sind verteilte Workloads auf das Backend-Netzwerk angewiesen. Wächst die Netzwerkkapazität nicht mit der GPU-Kapazität, kann das Hinzufügen von Racks laut CoreWeave das System sogar ineffizienter machen, weil mehr Rechenleistung mehr Kommunikation erzeugt.
Die RoCE-Architektur für Vera Rubin ist als zweistufiges, blockierungsfreies Fabric mit mehreren Rails und mehreren Planes ausgelegt. Jede Rubin GPU wird von zwei ConnectX-9 SuperNICs bedient, die nach Angaben des Unternehmens bis zu 1,6 Tb/s Backend-Anbindung pro GPU liefern. Laut CoreWeave erhöht das modulare Design die Spine-Kapazität innerhalb jeder Plane und kann die zweistufige Architektur auf rund 128.000 GPUs ausdehnen, ohne zusätzliche Netzwerkebenen, die die Latenz erhöhen würden.
Bei den Scale-out-Tests werden die schnellen GPU-zu-GPU-Verbindungen bewusst abgeschaltet, sodass der Datenverkehr über das Backend-Netzwerk läuft. CoreWeave misst dann Geschwindigkeit und Konsistenz zwischen jeder Karte und prüft die durchschnittliche sowie die schlechteste Latenz unter Last. Zudem wird auf instabile Verbindungen, steigende Fehlerraten, überhitzende Hardware, ungleichmäßigen Datenverkehr und Verkabelung geachtet, die nicht zum Verkabelungsplan passt.
Belastungstests, die reale Workloads abbilden
In der letzten Phase der Inbetriebnahme laufen Workloads, die das gesamte System gleichzeitig belasten. Dazu gehören synchronisierte GPU-Kommunikation, trainingsähnliche Jobs, intensive Berechnungen, eigene Benchmarks und Datenverkehr über das Netzwerk-Fabric. CoreWeave testet außerdem Muster, die agentische Anwendungen widerspiegeln, etwa plötzliche Nachfragespitzen, wechselnde Parallelität und Kommunikationsschübe.
Fehler träten oft erst auf, wenn Rechenleistung, Netzwerk, Strom, Kühlung und GPU-zu-GPU-Kommunikation zusammen belastet werden, so das Unternehmen. Der genannte Nutzen für Kunden: Wenn ein Rack in die Produktion geht, hat es die Belastung einer Kundenanwendung bereits bewältigt, Probleme fallen also im Test auf und nicht während eines laufenden Jobs.
Was das für Kunden bedeutet
Der Beitrag beschreibt CoreWeaves eigenes Vorgehen, die Aussagen zu Leistung und Einsatzbereitschaft stammen vom Unternehmen selbst. Für Kunden, die Training, Post-Training oder Inferenz auf Vera-Rubin-NVL72-Kapazität betreiben, lautet das erklärte Ziel: schneller zu einem stabilen Cluster kommen und weniger Überraschungen durch Nachzügler, Netzwerkprobleme oder Kühlungsfehler im Produktivbetrieb erleben.