CoreWeave meldet zehnmal mehr Tokens pro Megawatt mit Vera Rubin NVL72
CoreWeave zufolge erzeugte NVIDIA Vera Rubin NVL72 in einer DeepSeek-R1-Evaluierung zehnmal mehr Tokens pro Sekunde und Megawatt als NVIDIA GB200 NVL72. Verglichen wurde der Durchsatz bei einem identischen Interaktivitätsziel, das Energieeffizienz mit der von Nutzern und KI-Agenten wahrgenommenen Reaktionsfähigkeit verknüpft.
- CoreWeave verglich Vera Rubin NVL72 mit NVIDIA GB200 NVL72 anhand von DeepSeek R1.
- Vera Rubin NVL72 lieferte bei ähnlicher TPS/User bis zu zehnmal mehr Tokens pro Megawatt.
- Die Evaluierung nutzte TensorRT-LLM, NVIDIA Dynamo und mehrere Inferenzoptimierungen.
- Das Rack umfasst 72 NVIDIA Rubin GPUs und 36 NVIDIA Vera CPUs.
- Laut CoreWeave könnten weitere Optimierungen von Software und Systemen die Ergebnisse verbessern.
Vera-Rubin-Leistung im Produktionsmaßstab gemessen
CoreWeave teilte mit, dass das Unternehmen Anfang Juni den branchenweit ersten Aufbau und die Validierung von NVIDIA Vera Rubin NVL72 abgeschlossen hat. Das Unternehmen nahm das Rack-System vollständig in Betrieb und überprüfte Stromversorgung, Kühlung, Netzwerk und Rechenleistung. Die Plattform laufe damit im Produktionsmaßstab.
Für die ersten gemessenen Ergebnisse der Siliziumleistung führte CoreWeave DeepSeek R1 auf Vera Rubin NVL72 und NVIDIA Blackwell NVL72 aus. Die Evaluierung verglich den Token-Durchsatz pro Megawatt mit der Interaktivität, gemessen als TPS/User. Laut CoreWeave lieferte Vera Rubin NVL72 beim gleichen Workload bis zu zehnmal mehr Tokens pro Megawatt als NVIDIA GB200 NVL72 und bot dabei eine ähnliche Interaktivität pro Nutzer.
Effizienzarbeit zielt auf rechenintensive KI-Workloads
CoreWeave zufolge nutzte die Evaluierung auf beiden Plattformen wichtige Inferenzoptimierungen. Dazu gehörten groß angelegte Expertenparallelisierung, NVFP4-Präzision, Multi-Token-Vorhersage sowie die Entkopplung von Prefill und Decode. Ermöglicht wurde dies durch NVIDIA TensorRT-LLM und NVIDIA Dynamo.
Das Ergebnis könne es Kunden ermöglichen, mehr Datenverkehr von Reasoning-Modellen im gleichen Energiebudget auszuführen oder denselben Datenverkehr mit weniger Energie zu verarbeiten, erklärte das Unternehmen. CoreWeave verwies außerdem auf niedrigere Kosten pro Token und zusätzlichen Spielraum für eine Skalierung bei gleichen Infrastrukturinvestitionen.
Das ist für agentische Workloads relevant, weil Reasoning-Modelle planen, ihre Arbeit überprüfen und Antworten überarbeiten können. Dadurch erzeugen sie pro Anfrage mehr Tokens als eine typische Antwort. CoreWeave erklärte, dass jeder Token durch den Speicher und über die NVLink-Domäne bewegt werden müsse. Daher sei die Interaktivität ein entscheidendes Maß dafür, ob sich ein Agent reaktionsfähig anfühlt.
Ein Rack für Inferenz mit hohem Durchsatz
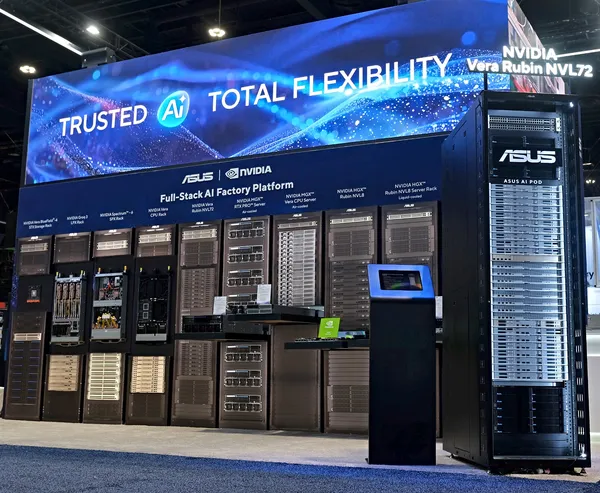
NVIDIA Vera Rubin NVL72 kombiniert 72 NVIDIA Rubin GPUs und 36 NVIDIA Vera CPUs in einem Rack. Die Komponenten sind laut CoreWeave über ein 260 TB/s schnelles All-to-All-NVLink-6-Netzwerk verbunden. Native NVFP4-Unterstützung ist in die Transformer Engine integriert.
CoreWeave beschrieb außerdem die Betriebssysteme, die die Rack-Plattform als Cloud-Dienst unterstützen. Dazu gehören die zum Patent angemeldete Flüssigkeitskühlung in Valvey, die einheitliche Rack-Steuerung in Racky sowie die Koordination über den Rack LifeCycle Controller.
CoreWeave erwartet weitere Fortschritte durch Optimierung
CoreWeave bezeichnete die erste Messung mit Vera Rubin NVL72 als Ausgangspunkt. Als das Unternehmen GB200 NVL72 in Betrieb nahm, verbesserten sich die Inferenzwerte in den folgenden Monaten deutlich, da es Scheduling, Netzwerk und Software-Stack optimierte. Für Vera Rubin NVL72 erwartet CoreWeave eine ähnliche Entwicklung und will aktualisierte Zahlen veröffentlichen, sobald die Optimierungsarbeiten fortschreiten.
Für Kunden, die agentische Workloads in den Bereichen Sicherheit, Programmierung oder Suche betreiben, könnte die gemeldete Effizienz mehr Inferenz innerhalb bestehender Strom- oder Infrastrukturgrenzen ermöglichen. CoreWeave nannte ein globales Cybersicherheitsunternehmen, ein Unternehmen für autonome Programmieragenten und eine KI-native Suchmaschine als Beispiele für Organisationen, die von der Plattform eine höhere Leistung pro Watt oder einen höheren Durchsatz pro GPU erwarten.