d-Matrix öffnet Demo-Cloud für Corsair-Inferenztests
d-Matrix hat seine gehostete Demo-Cloud für ausgewählte Kunden, Partner und Evaluatoren geöffnet. Damit lässt sich Corsair-basierte Inferenz mit produktionsreifen Modellen innerhalb weniger Minuten testen. Der Dienst bietet OpenAI-kompatiblen Zugang zu echter Corsair-Hardware sowie GPU-gestützten, heterogenen Inferenz-Endpunkten, vorbehaltlich verfügbarer Kapazitäten.
- Die d-Matrix Demo-Cloud ist jetzt für ausgewählte Evaluatoren verfügbar.
- Nutzer können Corsair-basierte Inferenz über ein OpenAI-kompatibles Gateway testen.
- Speculative Decoding ist bereits verfügbar, AFD- und Corsair-Endpunkte sollen folgen.
- Das Unternehmen nennt für eine SpecDec-Konfiguration 476.4 Tokens pro Sekunde und Nutzer.
- Der Zugang ist beschränkt und die Kapazität begrenzt.
Self-Service-Zugang für Inferenztests
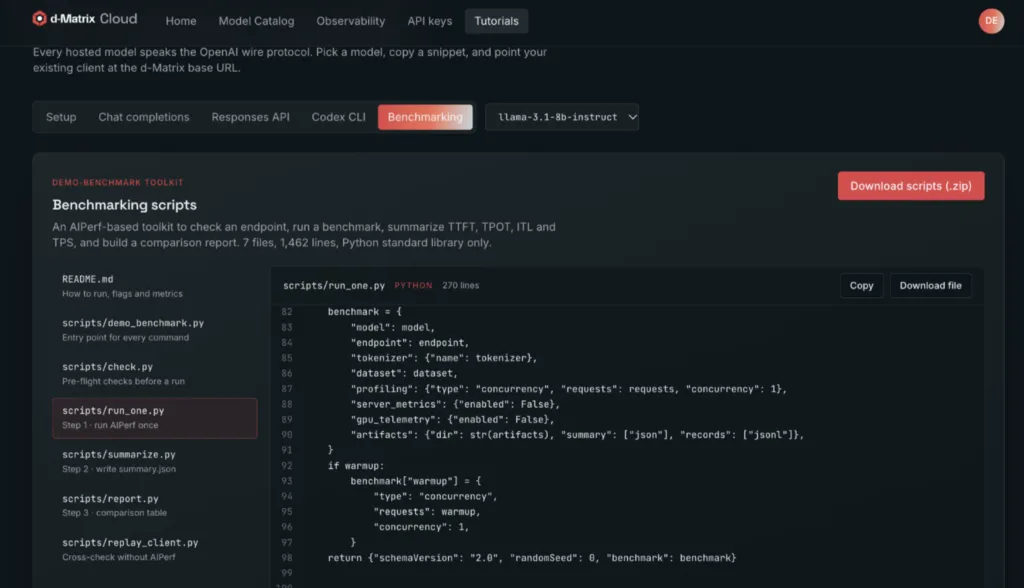
Die d-Matrix Demo-Cloud stellt Evaluatoren einen vorkonfigurierten Arbeitsbereich bereit. Ein Dashboard zeigt bereitgestellte Endpunkte, aktive API-Schlüssel und eine Basis-URL. Nutzer können eingeschränkte Inferenz-API-Schlüssel erstellen und sich mit einem standardmäßigen Bearer-Token authentifizieren. Dabei kommt dasselbe Verfahren wie beim SDK von OpenAI zum Einsatz.
Die gehosteten Modelle verwenden das OpenAI-Wire-Protokoll. Vorhandene Clients lassen sich daher durch Konfigurationsänderungen an d-Matrix weiterleiten, ohne dass eine Neuentwicklung erforderlich ist. Nach Angaben des Unternehmens unterstützt der Dienst Chat Completions, die Responses API und agentische Programmiertools wie Codex CLI. Zu den Beispielen gehört die Ausführung von Programmieraufgaben mit einem gehosteten Modell wie Qwen3 235B.
Ein Tab mit dem Titel Tutorials enthält direkt nutzbare Beispiele für die Responses API, Codex CLI und AIPerf. Mit AIPerf lassen sich laut d-Matrix die Zeit bis zum ersten Token, die Latenz zwischen Tokens und der Durchsatz pro Nutzer messen.
Corsair und GPU-Ressourcen teilen sich die Arbeit
Ein heute verfügbarer Endpunkt ist Speculative Decoding, kurz SpecDec. Bei dieser Konfiguration schlägt ein diskretes Entwurfsmodell auf Corsair Tokens vor, die ein größeres Zielmodell auf einer GPU überprüft. Laut d-Matrix kann die GPU dadurch eine stärker parallelisierte Arbeitslast übernehmen, während Corsair den Entwurfsschritt ausführt.
Die Demo-Cloud bietet außerdem geprüfte Bereitstellungskonfigurationen für verschiedene Bereitstellungsmodi, Rechen- und Speicherzuweisungen sowie die Kompatibilität mit Chat Completions und der Responses API. Ein Beispiel aus dem Modellkatalog zeigt ein Qwen3.5-27B-Zielmodell auf 1 H200 GPU mit einem kleinen Entwurfsmodell auf 2 Corsair-Karten.
d-Matrix berichtet, dass eine Konfiguration mit Qwen3-1.7B als Entwurfsmodell und Qwen 235B als Zielmodell 476.4 Tokens pro Sekunde und Nutzer erreichen kann. Dies ist das vom Unternehmen angegebene Ergebnis für diese Konfiguration.
Von der Bewertung bis zur Bereitstellung
Der Dienst verwendet ein einzelnes Inferenz-Gateway vor einer Kubernetes-basierten Serving-Flotte, die auf d-Matrix Squadron aufbaut. Das Gateway verwaltet API-Schlüssel, Nutzer und Organisationen, das Modell-Routing sowie Telemetriedaten wie Durchsatz, Zeit bis zum ersten Token, Latenz zwischen Tokens und Tokens pro Sekunde und Nutzer.
Ein Kubernetes-Bereitstellungsoperator übersetzt Routing- und Bereitstellungsabsichten in laufende Endpunkte. Eine Provisioning-Ebene verwaltet die Lebenszyklen der Endpunkte, Node-Pools und die Modellregistrierung. Laut d-Matrix ermöglicht diese Trennung, Modelle hinzuzufügen, zu verschieben oder zu skalieren, ohne Änderungen auf Client-Seite.
Endpunkte für die heterogene Attention-FFN-Disaggregation und Corsair-Endpunkte sind als demnächst verfügbar aufgeführt. Das Unternehmen erklärt, dass AFD Attention- und Feed-forward-Stufen auf Hardware trennt, die für die jeweilige Aufgabe geeignet ist. Corsair-Endpunkte sollen ganze Modelle direkt auf dedizierten Node-Pools bereitstellen, die aus Corsair-, JetStream- und NVIDIA-Hardware bestehen.
Die Demo-Cloud integriert Technologie von Wallaroo.ai. Dessen Software und Engineering-Team für die Bereitstellung und Orchestrierung von KI-Inferenz sind im August zu d-Matrix gestoßen. d-Matrix zufolge richtet sich der Dienst an Unternehmen, Neoclouds, Inferenzplattformen und Partner, die heterogene Rechenleistung mit bestehender Infrastruktur vergleichen. Der Zugang wird über das d-Matrix-Team freigeschaltet und ist kapazitätsbeschränkt. Evaluatoren erhalten dedizierte Corsair- und GPU-Ressourcen.