Databricks erweitert Agent Bricks um Agent Memory, jetzt in der Beta
Databricks hat auf Agent Bricks, seiner Entwicklerplattform für KI-Agenten, ein Gedächtnis für Agenten eingeführt und als Beta verfügbar gemacht. Laut Unternehmen speichert die Funktion Fakten, Präferenzen und Workflows, an die sich ein Agent erinnern soll. Das verbessere die Qualität und senke zugleich Kosten und Latenz.
- Databricks hat Agent Memory auf Agent Bricks eingeführt, als Beta verfügbar und auf Lakebase betrieben.
- Die Basis ist MemCurrent, das Plugins, Tools auf Abruf und eine Offline-Pipeline namens Dreaming kombiniert.
- In internen Benchmarks verdreifachte sich laut Databricks die Erfolgsquote der Agenten bei 31 % weniger Tokens.
- Erinnerungen liegen im Lakebase-Projekt des Kunden, Entwickler können sie lesen, exportieren und löschen.
- Mit der Agent Bricks CLI lässt sich laut Databricks ein Agent mit Gedächtnis und Sitzungen bereitstellen.
Was Agent Memory leistet
Agenten ohne Gedächtnis neigen laut Databricks dazu, wichtige Fakten immer wieder neu herauszufinden, Nutzerpräferenzen zu vergessen und Fehler zu wiederholen, für die sie bereits korrigiert wurden. Viele Entwickler bauen deshalb eigene Gedächtnislösungen, stehen dabei aber vor Designfragen: Wo werden Erinnerungen gespeichert, wie werden sie zusammengeführt und wie werden sie abgerufen?
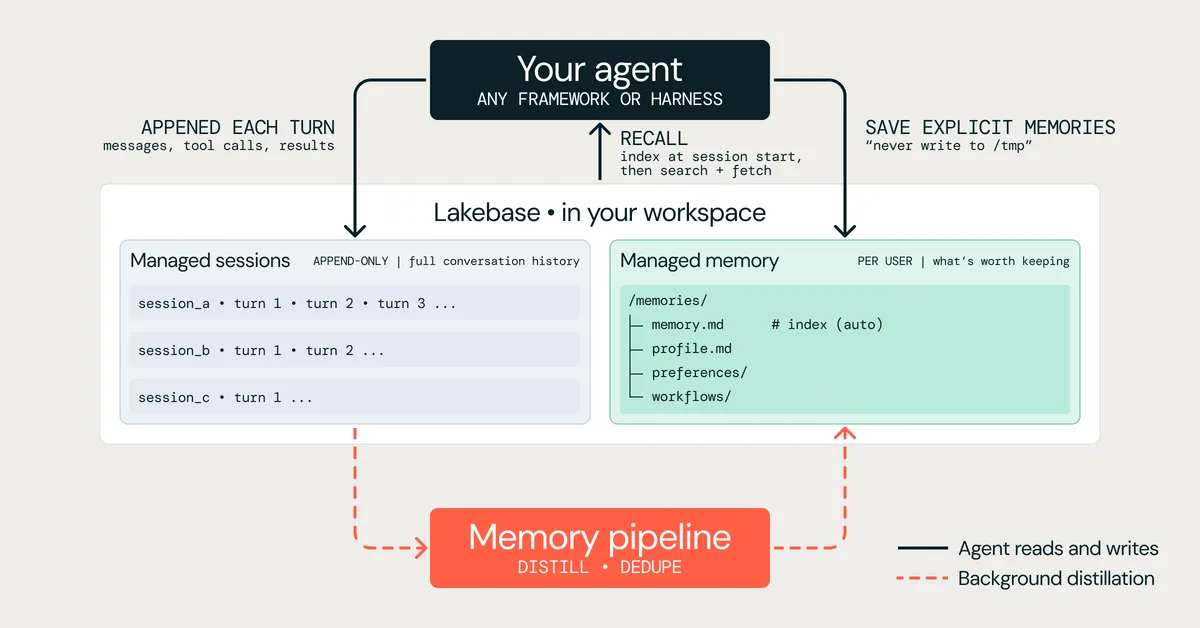
Databricks Agent Memory basiert auf der MemCurrent-Architektur, die nach Angaben des Unternehmens von Databricks Research entwickelt wurde. MemCurrent kombiniert drei Zugriffsmuster: Plugins, die Kontext automatisch protokollieren und laden, Tools, die der Agent bei Bedarf aufruft, und eine Offline-Pipeline namens Dreaming, die das Gedächtnis im Hintergrund konsolidiert. Der Dienst läuft auf Lakebase, dem serverlosen Postgres von Databricks, was laut Unternehmen die Latenz niedrig hält.
In internen Benchmarks verdreifachte diese Architektur nach Angaben von Databricks die Erfolgsquote von Agenten bei realen Unternehmensaufgaben, bei 31 % weniger Tokens.
Das Problem zustandsloser Agenten
Databricks beschreibt zwei Probleme, die auftreten, sobald ein Agent von der Demo in den Alltag wechselt. Das erste sind die Kosten: Ein zustandsloser Agent leitet erneut her, was er am Vortag herausgefunden hat, etwa welche Tabelle Nutzungsdaten enthält oder welcher Join funktioniert. In einer realen Sitzung aus der Forschung des Unternehmens brauchte ein Agent 11 Tool-Aufrufe, 8 Subagenten und knapp sechs Minuten, um eine Frage zu den wichtigsten Kunden eines Produkts zu beantworten, und hätte all das am nächsten Tag wiederholt.
Das zweite Problem ist fehlende Personalisierung. Wenn ein Nutzer eine Präferenz äußert oder einen Fehler korrigiert, vergisst der Agent das mit dem Ende der Sitzung.
Databricks verweist außerdem auf die Schwächen zweier verbreiteter Behelfslösungen:
- Den gesamten Verlauf erneut in den Kontext laden. Bei Open-Source-Gedächtnis-Benchmarks benötigte der volle Kontext laut Databricks bei gleicher Genauigkeit etwa 12-mal mehr Eingabe-Tokens pro Frage als ein gut gestaltetes Gedächtnis. Bei den längsten Verläufen schnitt er schlechter ab, weil irrelevante Beiträge den Agenten verwirrten.
- Ein Gedächtnis auf Objektspeicher oder einer Vektordatenbank aufbauen. Dann müssen die Teams Extraktion, Deduplizierung, Abruf und Zugriffskontrolle selbst verantworten, und Erinnerungen können veralten oder sich widersprechen.
Drei Bausteine und eine Forschungsgrundlage
Agent Memory besteht aus drei Komponenten. Managed Sessions zeichnen jede Unterhaltung als geordneten Verlauf aus Nachrichten, Tool-Aufrufen und Ergebnissen auf, und zwar im nativen Format des Frameworks der Entwickler. Managed Memory speichert Profil, Präferenzen, Domänenwissen und Workflows. Zu Beginn einer Sitzung lädt der Agent einen Index des bekannten Wissens, während der Sitzung findet er Details über eine hybride Suche aus Stichwort- und semantischer Suche. Memory Pipelines destillieren Sitzungen im Hintergrund zu Erinnerungen, entweder auf Abruf oder regelmäßig. Sie extrahieren dauerhafte Fakten und Präferenzen, entfernen Duplikate und ersetzen Fakten, denen neuere Unterhaltungen widersprechen.
Das System ist die Produktivumsetzung des Forschungspapiers „MemCurrent: Designing Memory for Enterprise Agents“. Dessen zentrale Erkenntnis lautet laut Databricks, dass ein Gedächtnis in zwei Schichten am besten funktioniert: einem Rohprotokoll dessen, was geschehen ist, und einem destillierten Protokoll dessen, was erinnerungswürdig ist. Dieses wird von einem Hintergrundprozess aktuell gehalten, statt vom Agenten mitten in der Aufgabe ad hoc geschrieben zu werden. Databricks zufolge treibt dieselbe Infrastruktur bereits das Gedächtnis in Genie an, der Natural-Language-Oberfläche für Fachanwender.
Was das für Entwickler bedeutet
Databricks nennt mehrere praktische Effekte. Im oben genannten Beispiel beantwortete der Agent eine verwandte Folgefrage mit 2 Tool-Aufrufen in 41 Sekunden, nachdem der Workflow im Gedächtnis gespeichert war, statt mit 11 Tool-Aufrufen und knapp sechs Minuten. Präferenzen, Korrekturen und teamspezifische Definitionen bleiben über Sitzungen hinweg erhalten, jeweils auf den einzelnen Nutzer begrenzt.
Sitzungen und Erinnerungen liegen im Lakebase-Projekt des Kunden, unabhängig von einem einzelnen Agenten-Framework. Entwickler können die Einträge, die ein Agent zu jedem Nutzer führt, lesen, exportieren und löschen. Außerdem können sie einer Memory Pipeline Anweisungen geben, zum Beispiel „dauerhafte Kundenpräferenzen behalten, einmalige Debugging-Notizen ignorieren“.
Laut Databricks ist keine neue Infrastruktur nötig, und mit der Agent Bricks CLI lässt sich ein Agent mit Gedächtnis und Sitzungen in wenigen Minuten bereitstellen. Agent Memory reiht sich in Agent Bricks neben Agent-Hosting, Databricks Sandbox, Unity Gateway, vorgefertigte MCP-Server sowie Tracing und Evaluation ein. Das Unternehmen hat eine Kurzanleitung und ein Tutorial veröffentlicht, wie sich einem bestehenden Agenten ein Gedächtnis hinzufügen lässt. Da die Funktion in der Beta ist und die Leistungswerte aus eigenen Benchmarks von Databricks stammen, sollten Teams sie mit den eigenen Workloads testen.
Databricks: Introducing Agent Memory on Databricks