Databricks startet AI Index zur Erfassung von Modellkosten und -nutzung in Unternehmen
Databricks hat den Databricks AI Index gestartet, eine öffentliche Ressource zur Erfassung der Nutzung von KI-Modellen, der Leistung von Coding-Agenten und der Ausgaben in Unternehmen. Das Unternehmen will den Index wöchentlich aktualisieren, während es neue proprietäre und Open-Weight-Modelle bewertet.
- Databricks hat seinen AI Index öffentlich zugänglich gemacht und will ihn wöchentlich aktualisieren.
- Der Anteil von Open-Weight-Modellen am Token-Verkehr von Unternehmen stieg von 7.3% auf 30.9%.
- Im July nutzten 64% der Unternehmen mit Unity Gateway einen Anbieter, bis November 2 sank der Anteil auf 28%.
- GPT-6 Luna und Claude Opus 5.5 erreichten dieselbe Erfolgsquote von 89.1%, verursachten aber unterschiedliche Kosten.
- Der Median-Nutzer gab $2.49 für KI aus, verglichen mit $699.74 beim Nutzer am 99. Perzentil.
Öffentlicher Einblick in die KI-Nutzung von Unternehmen
Der Index kombiniert aggregierte und anonymisierte Daten von mehr als 10.000 Unternehmen, die Unity Gateway nutzen. Dazu gehören Digitalunternehmen, Fortune-500- und Global-2000-Konzerne. Die Daten erfassen den Datenverkehr zu externen Anbietern wie Anthropic und OpenAI sowie zu proprietären und Open-Weight-Modellen.
Databricks zufolge misst die Ressource die Nutzung von Modellen anhand der Anteile an Tokens und Ausgaben. Außerdem erfasst sie die wöchentlichen KI-Ausgaben einzelner Nutzer. Das Unternehmen veröffentlicht die interne Evaluierungssuite dauerhaft, nachdem Kunden wiederholt gefragt hatten, wie sich neue Modelle vergleichen lassen und wie sich ihre Nutzung in Unternehmen verändert.
Nach Angaben des Unternehmens wurde seit May 2026 ungefähr jede Woche ein neues proprietäres oder Open-Weight-Flaggschiffmodell veröffentlicht. Unter Einbeziehung regionaler Labore war es sogar alle 3.7 Tage. Dieses Tempo erschwert die Auswahl von Modellen, Kostenvergleiche und Entscheidungen darüber, wann ein Wechsel sinnvoll ist.
Die Auswahl von Modellen wird zunehmend fragmentiert
Databricks berichtete von einer deutlichen Verschiebung bei den Modellpräferenzen von Unternehmen. Im July nutzten etwa 64% der Unternehmen mit Unity Gateway einen einzigen Modellanbieter. Bis November 2 war dieser Anteil auf 28% gesunken, da immer mehr Organisationen Modelle von zwei oder mehr Anbietern einsetzten.
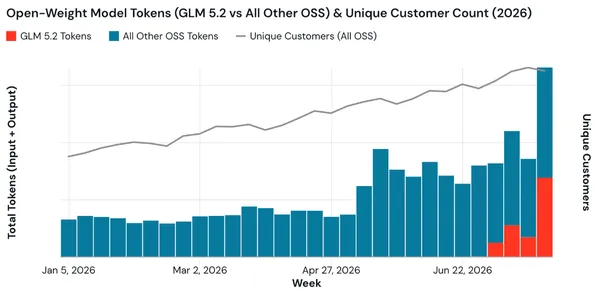
Auch Open-Weight-Modelle steigerten ihren Anteil am Token-Verkehr von Unternehmen: von 7.3% im July auf 30.9% im November. Drei Open-Weight-Modelle schafften es in Databricks' Benchmark für Codequalität unter die Top 10. DeepSeek V4.1 und GLM 5.3 belegten mit einer Erfolgsquote von 93.1% jeweils den dritten Platz.
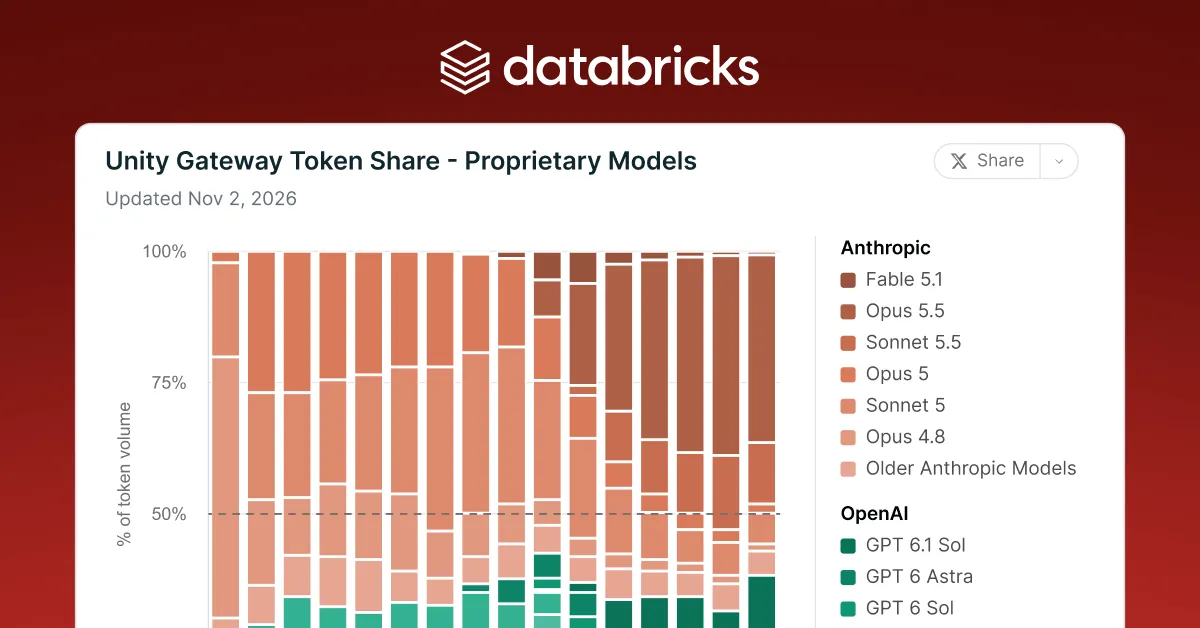
Auch die Dynamik bei den Anbietern veränderte sich schnell. Laut Databricks stieg Claude Opus 5.5 innerhalb von sechs Wochen von 7.2% auf 37.9% der Tokens proprietärer Modelle. Der Gesamtanteil von Anthropic wuchs unterdessen von 57.6% auf 68.8%.
Kosten hängen von mehr als den Token-Preisen ab
Für die Evaluierung von Coding-Agenten nutzt Databricks reale Arbeitsabläufe seiner Ingenieure. Dazu gehören das Erstellen und Prüfen von Pull Requests, die Untersuchung von Problemen und die Bearbeitung komplexer Entwicklungsaufgaben. Der Benchmark testet Modelle aus neun KI-Laboren mit Claude Code und Codex. Dabei vergleicht er Kombinationen aus Modellen und Arbeitsumgebungen anhand der Erfolgsquote bei Aufgaben und der Kosten pro abgeschlossener Aufgabe.
Databricks stellte fest, dass GPT-6 Luna und Claude Opus 5.5 jeweils eine Erfolgsquote von 89.1% bei den Aufgaben erreichten. Die durchschnittlichen Kosten lagen jedoch bei $0.05 beziehungsweise $1.62 pro Aufgabe. Gemini 3.8 Flash hatte zwar einen niedrigen Token-Preis, benötigte aber durchschnittlich 140 Interaktionen pro Aufgabe und kam auf $11.97 pro Aufgabe.
Die Ergebnisse zeigen, dass Unternehmen ihre eigenen Arbeitslasten bewerten müssen, statt sich allein auf Modellrankings oder Token-Preise zu verlassen. Databricks zufolge kann intelligentes Routing, darunter Smart Routing in Unity Gateway, dabei helfen, Aufgaben je nach Qualität und Kosten passenden Modellen zuzuweisen. Die Daten des Unternehmens zeigten außerdem eine große Ausgabenlücke zwischen Nutzern: Der Median-Nutzer gab $2.49 für KI aus, während der Nutzer am 99. Perzentil $699.74 ausgab.