Databricks: KI-Forschungsteam startet dank AI Runtime achtmal mehr Trainingsjobs
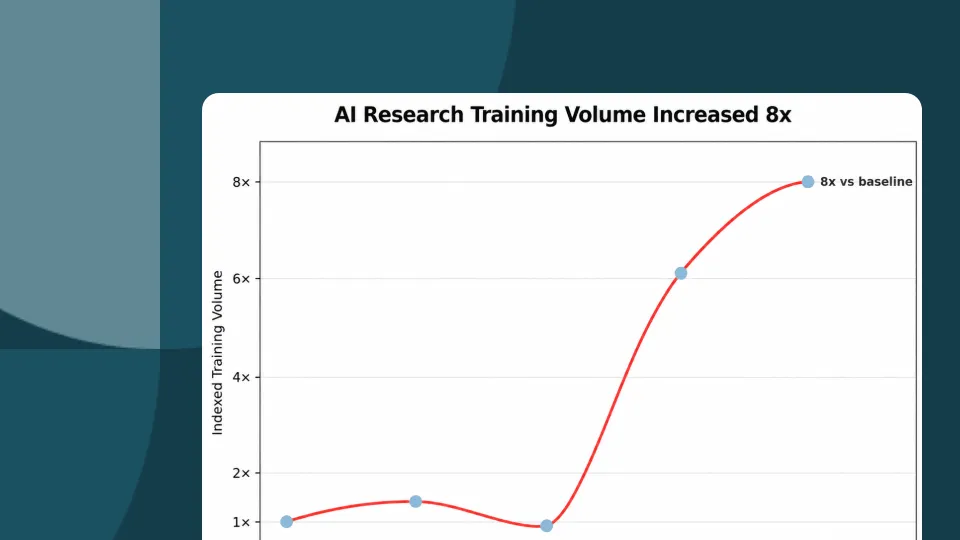
Das hauseigene KI-Forschungsteam von Databricks hat nach eigenen Angaben die Zahl der Trainingsjobs in seinen AI-Functions-Workloads um das Achtfache gesteigert, seit es Agenten Experimente auf AI Runtime (AIR) ausführen lässt. In einem Unternehmensblogbeitrag beschreibt das Team, wie AIR die Zuverlässigkeit der GPUs, schnelle Jobstarts und den Datenzugriff für Workloads sicherstellt, die von kleinen Tests bis zu Hunderten GPUs reichen.
- Databricks zufolge ist sein AI-Research-Team seit der Einführung des Produkts im vergangenen Jahr der „Customer Zero“ von AI Runtime (AIR).
- Laut Databricks hat agentengetriebene Forschung die Zahl der Trainingsjobs in den Forschungs-Workloads zu AI Functions um das Achtfache erhöht.
- AIR führt vorab GPU-Gesundheitschecks durch, überwacht Knoten während der Jobs und sperrt fehlerhafte Knoten ab.
- Das Team trainiert Modelle mit einigen Milliarden bis fast einer Billion Parametern auf NVIDIA-H100- oder B300-GPUs.
- AIR ist mit MLflow und Unity Catalog integriert, und Agenten können die Databricks-CLI und databricks-air-skills nutzen.
Viele Experimente, sehr unterschiedlicher Rechenbedarf
Laut Databricks entwickelt sein Forschungsteam die Modelle hinter Databricks AI Functions, darunter ai_parse_document und ai_extract. Das Unternehmen gibt an, dass für die erreichte Qualität beim Parsen von Dokumenten Forschung an unterschiedlichen Architekturen, Datensätzen, Trainingsverfahren und Hyperparametern nötig war, verteilt auf Zehntausende Trainings- und Evaluierungsläufe.
Das Team nutzt Supervised Fine-Tuning (SFT), Offline Reinforcement Learning (RL) und Online-RL, um Modelle mit einigen Milliarden bis hin zu fast einer Billion Parametern zu trainieren. Je nach Workload laufen die Jobs auf NVIDIA-H100- oder B300-GPUs, die beide über AIR verfügbar sind. Die größten Läufe können Hunderte GPUs benötigen, die tage- oder wochenlang mit Hochgeschwindigkeitsnetzwerk zusammenarbeiten.
Databricks nennt drei Herausforderungen:
- Ausfallsicherheit: Der Ausfall eines einzelnen Knotens oder des RDMA-Netzwerks kann Hunderte GPUs lahmlegen und einen Neustart ab einem früheren Checkpoint erzwingen, wodurch Stunden an Fortschritt verloren gehen.
- Schnelles Experimentieren: Um Tausende Ansätze zu testen, müssen sich Experimente starten lassen, ohne wiederholt Infrastruktur bereitzustellen oder Umgebungen neu aufzubauen.
- Verwaltung der GPU-Flotte: Mehrere Projekte konkurrieren mit unterschiedlichen Anforderungen, Prioritäten und Fristen.
Wie AI Runtime diese Probleme angeht
Das Forschungsteam sagt, es sei seit der Einführung des Produkts im vergangenen Jahr der „Customer Zero“ von AI Runtime. Databricks beschreibt mehrere Funktionen, auf die es sich stützt.
GPU-Ausfallsicherheit. AIR führt auf den zugewiesenen GPU-Knoten Preflight-Checks durch, um vor Trainingsbeginn zu bestätigen, dass sie funktionsfähig sind und miteinander kommunizieren können. Zudem überwacht es die Knoten während der Ausführung auf Probleme wie NCCL-Kommunikationsfehler, thermische oder leistungsbedingte Drosselung und GPU-Treiberprobleme. Wenn ein fehlerhafter Knoten einen Job scheitern lässt, sperrt AIR ihn ab, sodass spätere Jobs dort nicht eingeplant werden. Databricks zufolge ist das wichtig für Projekte wie KARL, bei denen die Rollout-Generierung und das Post-Training von Modellen mit mehr als 100 Milliarden Parametern Tausende GPU-Stunden erfordern können.
Schnelle Iteration. Mit der AIR-CLI starten Forschende Workloads programmatisch und legen fest, welche GPUs sie brauchen, während AIR Bereitstellung und Scheduling übernimmt, einschließlich Hochgeschwindigkeitsnetzwerk für verteiltes Training über Clouds hinweg. Das Team nutzt eigene Docker-Container für die lokale Entwicklung und dieselben Images für das Training und teilt sie über die Databricks Artifact Registry. Laut Beitrag helfen AIRs Arbeiten an Startlatenz und Container-Optimierung dabei, Trainingsjobs in Sekunden zu starten.
Tracking und Daten. AIR legt für Trainingsjobs automatisch MLflow-Experimente an und verwaltet sie. Die Forschungsdaten liegen im Unity Catalog, und per Unity Catalog FUSE Mounting kann das Team darauf wie auf ein lokales Dateisystem zugreifen, auch über verschiedene Databricks-Workspaces hinweg.
Kapazitätsmanagement. Mit Workload-Priorisierung und Preemption kann das Team Ressourcen auf Projekte verteilen und zeitkritische Experimente bevorzugen. Databricks nennt als Beispiel freie Kapazitäten, die über ein Wochenende zusätzliche explorative Experimente ermöglichen, ohne höher priorisierte Arbeit zu stören.
Agentengeführtes Training erhöht die Last
Der Beitrag beschreibt den zunehmenden Einsatz von Agenten in einem von Andrej Karpathy bekannt gemachten Workflow namens Autoresearch. Statt dass Forschende jedes Experiment von Hand starten und auswerten, schlagen Agenten Änderungen vor, führen Experimente durch, werten Ergebnisse aus und entscheiden, was als Nächstes ausprobiert wird. Databricks zufolge ist die Zahl der Trainingsjobs in den Forschungs-Workloads zu AI Functions dadurch um das Achtfache gestiegen.
Das Unternehmen argumentiert, dass sich dadurch die Anforderungen an die Infrastruktur ändern. Ein langsamer Start oder ein verwirrender Konfigurationsfehler mag verkraftbar sein, wenn ein Forschender eine Handvoll Experimente startet, wird aber zum Engpass, wenn Agenten Hunderte starten. Agentengetriebene Forschung brauche schnelle Jobstarts, programmatische Schnittstellen, klare und umsetzbare Fehlermeldungen, zuverlässige Ausführung und zugängliche Ergebnisse.
Der Autoresearch-Zyklus besteht aus vier Schritten: Agenten schlagen Verbesserungen vor, starten mehrere Versuche parallel auf AIR, werten Trainingsmetriken aus und aktualisieren den Plan mit neuen Experimenten. Über die Databricks-CLI und databricks-air-skills können Agenten parallele Workloads starten, den Jobstatus überwachen, MLflow-Metriken abrufen und anhand der Ergebnisse iterieren.
Was das für Teams bedeutet, die Modelle trainieren
Der Beitrag ist ein Unternehmensbericht über die eigene interne Nutzung, daher stammen die Zahl von achtmal mehr Jobs und die Geschwindigkeitsangaben von Databricks und sind nicht unabhängig überprüft. Er zeigt aber, wie das Unternehmen AI Runtime positioniert: als GPU-Infrastruktur für Teams, die eigene Modelle trainieren oder feinabstimmen, mit Zuverlässigkeit, kontrolliertem Datenzugriff und programmatischen Schnittstellen, die zu agentengetriebenem Experimentieren passen.
Databricks sagt, AIR ermögliche es seinen Forschenden, weniger Zeit mit der Verwaltung von Infrastruktur und mehr Zeit mit der Entwicklung besserer Modelle zu verbringen. Wer selbst Modelle trainiert oder feinabstimmt, verweist das Unternehmen für den Einstieg auf die Dokumentation von AI Runtime.
Databricks: How our AI Research team uses AI Runtime