Databricks zeigt, wie Lakebase-Branching jedem Coding-Agenten eine eigene Datenbank gibt
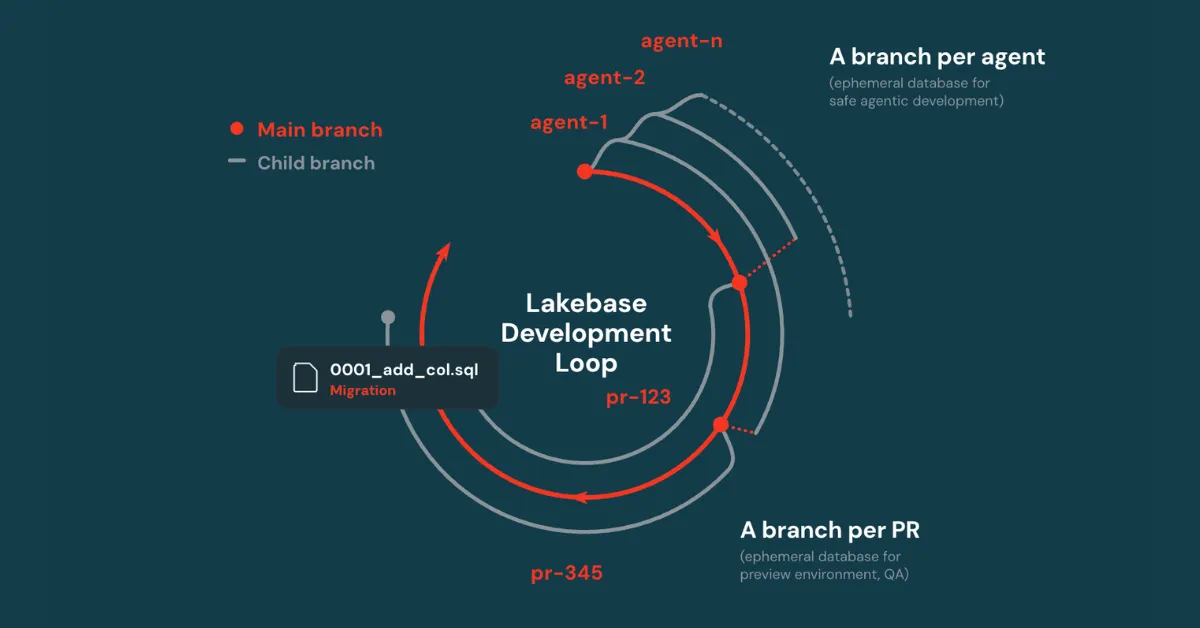
Databricks zufolge ist die Datenbank der übersehene Engpass, wenn mehrere Coding-Agenten parallel arbeiten, und schlägt Lakebase-Branching als Lösung vor. In einem Blogbeitrag beschreibt das Unternehmen einen Entwicklungszyklus, der jedem Agenten und jedem Pull Request einen eigenen, isolierten Datenbank-Branch zuweist.
- Databricks zufolge ist die Datenbank ein übersehener Engpass, wenn Coding-Agenten parallel arbeiten.
- Lakebase verzweigt eine komplette Datenbank per Copy-on-Write in unter einer Sekunde und kann auf null herunterskalieren.
- Git Worktrees plus ein Post-Checkout-Hook erzeugen pro Agent einen Datenbank-Branch.
- GitHub Actions erstellt pro PR einen kurzlebigen Branch, führt Migrationen aus, stellt eine Vorschau-App bereit und postet einen Schema-Diff.
- Lakebase-Branches werden nicht zurückgemergt; Schemaänderungen gelangen über Migrationen wie Drizzle, Flyway, Liquibase oder Alembic in den Eltern-Branch.
Das Problem der gemeinsamen Datenbank
Laut Databricks wird der gleichzeitige Einsatz mehrerer Coding-Agenten zunehmend zur Norm, und rund um diesen Ansatz sind Werkzeuge wie Skills, Hooks, MCPs und Subagenten entstanden. Die Datenbank bleibt dabei jedoch oft außen vor. Jeder parallel arbeitende Agent muss Code schreiben, Schemaänderungen anwenden und Tests gegen eine Datenbank ausführen.
In einem geteilten Setup, etwa mit einer einzigen Entwicklungs- oder Staging-Datenbank, können Agenten bei Schemaänderungen in Konflikt geraten, sich gegenseitig stören oder auf Mocks ausweichen, die reale Daten nicht abbilden. Databricks erklärt, dies seien bereits zuvor Schwachstellen für Entwickler gewesen, Coding-Agenten verschärften sie aber, weil sie schneller arbeiten, parallel agieren und eine sichere Umgebung brauchen, die weder Produktionsdaten gefährdet noch sensible Daten preisgibt.
So funktioniert Lakebase-Branching
Databricks zufolge löst die Lakebase-Postgres-Architektur das Problem mit Datenbank-Branching. So wie Git Code verzweigt, kann Lakebase eine komplette Datenbank unabhängig von ihrer Größe in weniger als einer Sekunde verzweigen. Die Branches nutzen Copy-on-Write: Sie teilen sich die Daten des übergeordneten Branches und belegen nur dann zusätzlichen Speicherplatz, wenn sie sich davon entfernen. Sie lassen sich außerdem auf null herunterskalieren, sodass inaktive Branches keine Rechenkosten verursachen, was wichtig ist, wenn mehrere Agenten gleichzeitig laufen.
Jeder Branch ist vollständig isoliert. Ein Agent kann Migrationen anwenden, Tests ausführen und den Branch nach Abschluss wieder entfernen. Ein Unterschied zu Git: Lakebase-Branches werden nicht in den Hauptbranch zurückgeführt. Databricks begründet das damit, dass sich Eltern- und Kind-Branch unabhängig voneinander verändern können und der Abgleich ihrer Daten schnell unpraktikabel würde. Schemaänderungen werden stattdessen im Code verfolgt und über Migrationswerkzeuge wie Drizzle, Flyway, Liquibase oder Alembic in den übergeordneten Branch überführt. Im Beispiel kommt Drizzle zum Einsatz.
Der Zyklus aus Agent und Pull Request
Für die lokale Arbeit empfiehlt Databricks Git Worktrees, die jedem Agenten ein eigenes Verzeichnis mit eigenem ausgecheckten Branch geben und so Konflikte auf Dateiebene vermeiden. Ein Post-Checkout-Hook im Repository erstellt dann für jeden neuen Worktree einen Datenbank-Branch. Im Beispiel führt ein Agent claude -worktree feature-123 aus, Git legt den Worktree an, der Hook wird ausgelöst, und der Agent verfügt über ein eigenes Code-Verzeichnis und eine eigene Datenbank. Das Verhalten der Agenten lässt sich über Anweisungsdateien wie AGENTS.md oder CLAUDE.md steuern, einschließlich des Schritts, nach getaner Arbeit einen PR zu öffnen. Sobald der PR existiert, können Worktree und Datenbank-Branch entfernt werden.
Nach dem Öffnen eines PR erstellt GitHub Actions einen kurzlebigen Lakebase-Branch als Kind des Produktions-Branches. Der beschriebene Ablauf sieht so aus:
- Ein PR wird gegen main geöffnet.
- Die CI ruft die Lakebase-CLI auf, um einen Branch wie pr-123 zu erstellen.
- Das Migrationswerkzeug läuft gegen den neuen Branch.
- Eine Vorschau-App wird bereitgestellt, die auf den Connection String des Branches zeigt.
- Ein Schema-Diff wird erzeugt und als PR-Kommentar gepostet, der zeigt, welche Tabellen, Spalten oder Indizes sich geändert haben.
- Der Reviewer prüft sowohl Code- als auch Datenbankänderungen.
- Wird der PR geschlossen oder gemergt, löscht die CI den Branch.
Im Beispiel wird die App mit Databricks Apps bereitgestellt, laut Databricks lässt sich das Konzept aber auf Hosting-Plattformen wie Vercel, Netlify und Cloudflare übertragen. Ein Beispiel-Repository mit GitHub-Actions-Workflows steht bereit.
Weitere Einsatzmöglichkeiten und Bedeutung
Databricks nennt weitere Workflows, die im Beispiel-Repository nicht umgesetzt sind. Ein Branch kann zu einem bestimmten Zeitpunkt aus der Produktion erstellt werden, typischerweise kurz bevor ein Fehler auftrat, sodass Entwickler das Problem mit echten Daten reproduzieren und den Branch nach der Validierung des Fixes wieder entfernen können. Branching kann auch Schemamigrationen sicherer machen: Man erstellt einen Branch, wendet die Migration an, führt Tests aus und überführt die Änderung erst dann in die Produktion. Teams können mit produktionsnahen Daten arbeiten, etwa mithilfe von Unity-Catalog-Maskierung, ohne die Live-Datenbank zu gefährden.
Databricks weist zudem darauf hin, dass viele Teams pro Umgebung einen eigenen Workspace nutzen, etwa für Dev, Staging und Prod, und häufig von einer vorbefüllten Datenbank statt von der Produktion verzweigen, um die Offenlegung personenbezogener Daten (PII) zu vermeiden. Der Beitrag verwendet der Einfachheit halber einen einzigen Workspace.
Das Unternehmen fasst den Ansatz als Lakebase-Entwicklungszyklus zusammen: ein Branch pro Agent, ein Branch pro PR und isolierte Branches für die Validierung in der Produktion. Für Teams, die Coding-Agenten einführen, bietet das laut Databricks ein sicheres und flexibles Datenbankfundament für den agentischen Softwareentwicklungszyklus.
Databricks: Lakebase and Agentic SDLC: Branching Databases for Coding Agents