Databricks Lakebase Postgres stellt 100-TB-Datenbank per Branch in Sekunden wieder her
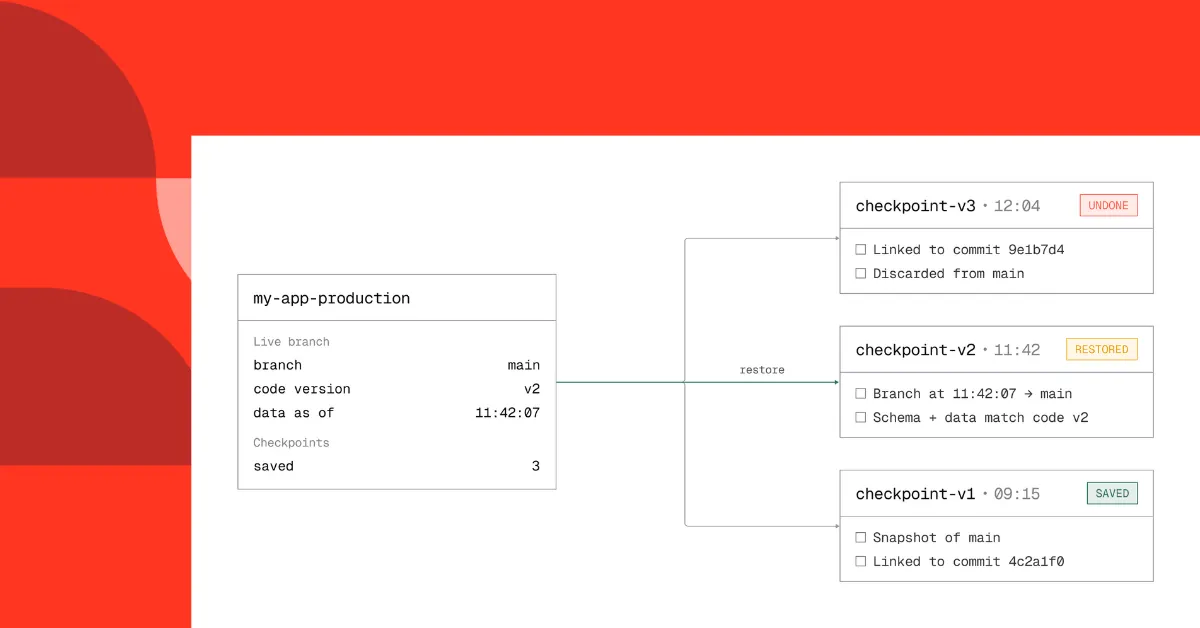
Databricks zufolge kann Lakebase Postgres eine Datenbank selbst bei 100 TB in Sekunden wiederherstellen. Statt Daten in eine neue Instanz zu kopieren, legt das System einen Branch zu einem frei gewählten Zeitpunkt an. Laut dem Unternehmen wird aus einem mehrstündigen Restore so eine reine Metadatenoperation.
- Databricks zufolge stellt Lakebase Postgres eine 100-TB-Datenbank per Branch-basiertem Restore in Sekunden wieder her.
- Ein Restore legt als Metadatenoperation einen Branch zu einem Zeitstempel an, ohne Daten zu kopieren oder WAL abzuspielen.
- Klassische PITR erfordert eine neue Instanz, die Wiederherstellung eines Snapshots und WAL-Replay, was laut Databricks bei größeren Datenbanken meist mehrere Stunden dauert.
- In der Databricks-Umfrage unter 50 Entwicklern mit Postgres ab 1 TB waren 30 % mindestens 3 Stunden offline, nur 21 % stellten in unter 60 Minuten wieder her.
- Laut Databricks ist der Vorgang einfach genug, dass KI-Agenten Branching- und Undo-Workflows übernehmen können.
Warum klassische Restores langsam sind
Databricks argumentiert, dass Wiederherstellungen in verwalteten OLTP-Systemen schon immer langsam waren und mit wachsenden Datenbanken noch langsamer werden. Nach Angaben des Unternehmens müssen gerade große Produktivdatenbanken, bei denen Ausfallzeiten am teuersten sind, am längsten auf ihre Wiederherstellung warten.
Die Ursache liegt laut Databricks in der Architektur. Rechenleistung und Speicher werden als eine Maschine bereitgestellt. Eine Point-in-Time-Recovery (PITR) in einem Dienst wie Amazon RDS umfasst deshalb drei Schritte:
- Neue Instanz bereitstellen: mit Compute- und Storage-Volumes, die mindestens so groß sind wie die der Primärinstanz. Große Instanzen mit großen EBS-Volumes brauchen in der Regel länger, bis sie laufen.
- Letzten brauchbaren Snapshot wiederherstellen: aus dem Objektspeicher. RDS stellt die Instanz bereit, bevor die Daten lokal vorliegen. Greift eine Abfrage auf einen Block zu, der noch nicht auf dem Volume liegt, wird er unmittelbar aus S3 geholt. Databricks sagt, diese Latenz sei für eine interne Prüfung in Ordnung, für den Produktivbetrieb aber nicht.
- WAL abspielen: vom Snapshot bis zum Zielzeitpunkt. Der Umfang des Replays hängt davon ab, wie viel zwischen Snapshot und diesem Moment passiert ist.
Databricks erklärt, dass PITR bei allem außer kleinen Datenbanken fast immer eine Operation von mehreren Stunden sei. Ein Hochverfügbarkeits-Replikat helfe, wenn eine Maschine ausfällt, nicht aber, wenn eine gelöschte Tabelle oder ein fehlerhafter Schreibvorgang bereits beim Standby angekommen ist.
Was eine Umfrage unter Postgres-Nutzern ergab
Databricks verweist auf eine Umfrage unter 50 Entwicklern, die produktive Postgres-Datenbanken ab 1 TB betreiben. Laut den berichteten Ergebnissen gilt:
- 59 % hatten in den vergangenen 12 Monaten einen kritischen Produktionsausfall.
- 30 % waren 3 Stunden oder länger offline, manche sogar mehr als einen halben Tag.
- Nur 21 % stellten die Datenbank in unter 60 Minuten wieder her.
Bei den geschäftlichen Folgen berichteten 40 % von erheblichen Betriebsunterbrechungen, 52 % verzeichneten negatives Kundenfeedback. Etwa 72 % fühlten sich nur „einigermaßen sicher“, bei einem erneuten Ausfall schnell wiederherstellen zu können.
So funktionieren Branch-basierte Restores in Lakebase
In Lakebase sind Compute und dauerhafter Speicher getrennt und über das WAL verbunden. Compute führt Postgres-Aufgaben wie SQL, Query Planning, MVCC, Locking und die WAL-Erzeugung aus, besitzt aber keine dauerhafte Kopie der Daten. Der Speicher besteht aus drei Komponenten:
- Safekeeper empfangen das WAL vom Compute. Eine Transaktion gilt als dauerhaft, sobald ein Quorum der Safekeeper ihren WAL-Eintrag bestätigt hat.
- Der Pageserver wandelt WAL in die Seiten um, die Postgres liest, und kann jede Seite zu einer bestimmten LSN rekonstruieren.
- Der Objektspeicher hält die unveränderliche Langzeithistorie vor.
Weil alte Seitenversionen nie überschrieben werden, entsteht aus der Datenbankhistorie eine adressierbare Zeitleiste. Ein Restore ist dann ein Branch an einem Punkt dieser Historie. Der Branch hat eigene, unabhängige Rechenleistung und einen eigenen Connection String und lässt sich unabhängig von der Produktion abfragen.
Databricks beschreibt den Ablauf so: Fällt auf dem Hauptbranch etwas aus, wählt der Nutzer einen Zeitpunkt in der Vergangenheit und kann ihn per Abfragen prüfen, bevor er ihn übernimmt. Die Control Plane ordnet den Zeitstempel dann der exakten LSN zu, legt den Branch an und hängt Compute an. Der wiederhergestellte Branch verweist auf bereits vorhandene Image- und Delta-Layer, es werden also keine Daten kopiert.
Was das für Anwender bedeutet
Databricks zufolge hängt die Dauer eines Restores nicht von der Datenbankgröße ab, weil es sich um Metadatenarbeit handelt. 100 TB seien daher so schnell wiederhergestellt wie 10 GB. Das Unternehmen sagt außerdem, der Vorgang sei einfach genug, dass ihn ein KI-Agent ausführen könne, was Branching- und Undo-Workflows unterstütze. Für Teams mit großen Postgres-Datenbanken lautet das Versprechen, dass die Wiederherstellung künftig weder zusätzliche Replikate noch zusätzliche Umgebungen oder stundenlange Ausfallzeiten erfordert. Diese Leistungsangaben stammen von Databricks und sind in der Quelle nicht unabhängig überprüft.
Databricks: Lakebase Postgres branch-based restores for fast recovery at scale