Databricks erweitert Lakeflow Connect um verwaltete Konnektoren für Jira, SharePoint, OpenAI und mehr
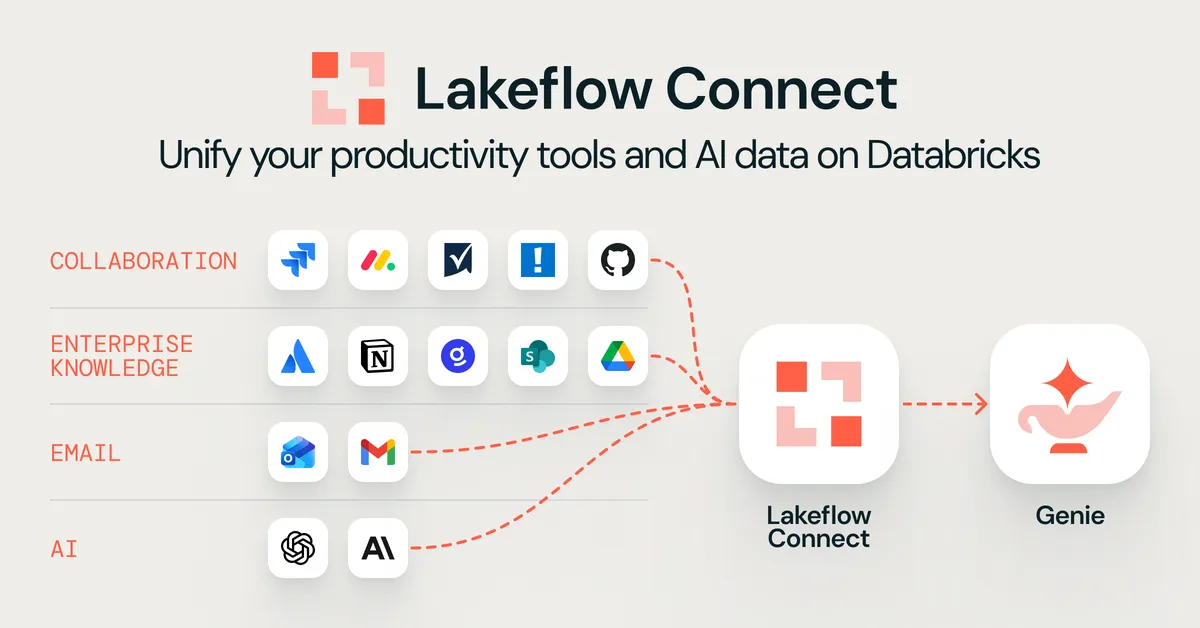
Databricks bietet mit seinem Dienst Lakeflow Connect nach eigenen Angaben vollständig verwaltete Konnektoren für Produktivitätswerkzeuge wie Jira, Confluence, SharePoint, Google Drive, Outlook, Gmail und GitHub sowie für die KI-Anbieter OpenAI und Anthropic an. Die Daten landen laut Unternehmen als kontrollierte Tabellen im Unity Catalog, sodass Teams KI-Agenten und Dashboards speisen können, ohne eigene Pipelines zu bauen.
- Lakeflow Connect bietet verwaltete Konnektoren für Jira, Confluence, SharePoint, Google Drive, Outlook, Gmail, GitHub, OpenAI und Anthropic.
- Die Daten landen als kontrollierte Tabellen im Unity Catalog und lassen sich per Point-and-Click-Oberfläche oder API einrichten.
- Rohe Dokumentdateien werden vor der Indexierung für die Suche mit ai_parse_document in Text umgewandelt.
- Die Konnektoren für OpenAI und Anthropic liefern Nutzungs-, Audit- und Nutzerdaten, um KI-Ausgaben und Akzeptanz zu steuern.
- Als Kunden werden Toyota Finance Australia, VaxCare und M3 Accounting genannt.
Eine Ingestion-Schicht für den gesamten Produktivitäts-Stack
In einem Blogbeitrag beschreibt Databricks, dass das Wissen in Unternehmen über Projektverwaltung, Wikis, Dokumentenablagen, Postfächer und KI-Werkzeuge verstreut ist und jedes System nur einen Ausschnitt davon enthält, wie Arbeit tatsächlich abläuft. Diese Daten herauszuholen, erforderte laut dem Unternehmen bislang eigene Pipelines, die langsam zu entwickeln und aufwendig zu warten sind.
Lakeflow Connect soll diesen Engpass beseitigen. Jeder Konnektor lässt sich per Point-and-Click-Oberfläche oder über eine einfache API einrichten. Die Daten werden inkrementell als verwaltete Tabellen im Unity Catalog übernommen, ohne dass Infrastruktur bereitgestellt oder skaliert werden muss. Der Beitrag ist der zweite einer Serie darüber, wie verwaltete Datenaufnahme in jeden Geschäftsbereich kommt, und folgt auf einen Beitrag zu Marketingdaten.
Databricks ordnet die Produktivitäts-Konnektoren vier Bereichen zu:
- Zusammenarbeit: Jira, Monday.com, Smartsheet, Aha! und GitHub
- Unternehmenswissen: Confluence, Notion, Glean, SharePoint und Google Drive
- E-Mail: Outlook und Gmail
- KI: OpenAI und Anthropic
Unstrukturierte Inhalte für KI-Agenten aufbereitet
Databricks argumentiert, ein KI-Agent sei nur so gut wie die Daten dahinter, und die meisten dieser Daten seien unstrukturiert. Die Konnektoren legen Dateien, Seiten und Nachrichten als kontrollierte Tabellen ab, wobei das Format von der Quelle abhängt.
- SharePoint und Google Drive: Jede unstrukturierte Datei, etwa PDFs, Word-Dokumente, Präsentationen und Bilder, landet als eine Zeile mit ihren Rohbytes in einer Content-Spalte. Strukturierte Dateien wie Excel-Dateien, CSVs oder Google Sheets können direkt als Delta-Tabellen abgelegt werden.
- Confluence: Der Inhalt jeder Seite und jedes Blogbeitrags kommt als Typ STRUCT in einem Body-Feld der Tabellen pages und blogposts an.
- Outlook: Der E-Mail-Text wird in einer Spalte full_body_content gespeichert, Anhänge in einer Spalte attachments als Typ BINARY, jeweils in der Tabelle email_messages.
- Gmail: Der vollständige Nachrichtentext liegt als Textstring in der Tabelle messages vor, zusammen mit einem Verweis auf jeden Anhang als attachmentId.
- GitHub: Textdateien aus Repositories, darunter Quellcode, Markdown und Konfigurationen, werden in der Spalte content der Tabelle repo_contents gespeichert.
Textinhalte wie Confluence-Seiten, E-Mail-Texte und Quelldateien sind laut Databricks nach leichter Bereinigung bereit für Chunking und Embedding. Dokumentdateien, die als Rohbytes ankommen, werden zunächst mit ai_parse_document in Text umgewandelt, was das Unternehmen als seine integrierte Dokumentenintelligenz bezeichnet. Das Ergebnis ist Text, der für die Suche indexiert und einem Agenten zur Verfügung gestellt werden kann.
KI-Ausgaben und Atlassian-Daten im Blick
Der Beitrag behandelt auch die Steuerung der KI-Nutzung. Der OpenAI-Konnektor liefert Nutzung, Kosten, API-Schlüssel, Projekte, Nutzer und Audit-Logs, sodass sich Ausgaben Teams zuordnen und die Akzeptanz verfolgen lassen. Der Anthropic-Konnektor liefert Audit-Logs, die Nutzer und Rollen der Organisation sowie die Inhalte von Chats und Nachrichten in claude.ai, damit Unternehmen steuern können, wie das Werkzeug genutzt wird. Databricks zufolge ergibt das einen einheitlichen Blick auf Trends der KI-Nutzung und hilft Teams, den ROI von KI-Investitionen gegenüber Stakeholdern darzulegen.
Bei Atlassian liefert der Jira-Konnektor Tickets, Kommentare, Sprints, Boards und benutzerdefinierte Felder, damit Teams den Projektfortschritt verfolgen und projektübergreifende Dashboards bauen können. Der Confluence-Konnektor deckt zudem Seiten und Blogbeiträge ab, wie oben beschrieben.
Kundenbeispiele und Einordnung
Databricks nennt mehrere Kunden. Toyota Finance Australia setzt den Jira-Konnektor als vollständig verwaltete, wartungsfreie Pipeline ein. Charbel Khoury, Head of Data Office des Unternehmens, sagte, er liefere "governed, analytics-ready Delta tables in the Databricks Lakehouse with minimal effort and maximum reliability."
VaxCare, das laut Beitrag das größte Impfnetzwerk der Primärversorgung in den USA betreibt, nutzt den Confluence-Konnektor, um einen Chatbot an seine interne Wissensdatenbank anzubinden. M3 Accounting verwendet die Konnektoren für GitHub und SharePoint. Ross Serven, VP of Data & AI des Unternehmens, sagte: "No custom crawlers, no file sync scripts, just a connector and a pipeline." Sein Unternehmen habe den internen Wissensassistenten innerhalb einer Woche mit Live-Inhalten betrieben.
Für Datenteams auf Databricks lautet das Versprechen: weniger individueller Integrationsaufwand für Wissensdatenbanken, Agenten und Dashboards zur Entwicklerproduktivität. Diese Ergebnisse sind Kundenaussagen, die von Databricks veröffentlicht wurden, unabhängige Benchmarks liefert der Beitrag nicht.
Databricks: Unify your productivity and AI data with Lakeflow Connect