Databricks stellt MemCurrent vor: Dauerhafter Speicher für Agenten im Produktivbetrieb
Databricks hat mit MemCurrent eine Architektur für dauerhaften Speicher von Agenten im Produktivbetrieb vorgestellt. Sie bildet nun die Grundlage des neuen Agent Bricks Memory und von Genie. Laut Unternehmen verdreifacht MemCurrent im internen Benchmark die Erfolgsquote des Agenten im Vergleich zu einem Agenten ohne Speicher, bei 31 % weniger Tokens und 26 % höherer Geschwindigkeit.
- Databricks hat MemCurrent vorgestellt, eine Architektur für dauerhaften Speicher, die nun Agent Bricks Memory und Genie antreibt.
- Sie kombiniert Speicher per Plugin, Werkzeug und Offline-Pipeline, wobei ein Offline-Schritt namens "Dreaming" den Speicher konsolidiert.
- Im internen Benchmark stieg die Erfolgsquote laut Databricks von 22,3 % auf 68,4 %, bei 1,35-mal schnelleren und 1,44-mal günstigeren Läufen.
- In den Open-Source-Benchmarks erreichte es im Schnitt 88,1 %, nahe am vollen Kontext (87,8 %), bei rund 12-mal weniger Eingabe-Tokens.
Warum Speicher schwer richtig umzusetzen ist
Databricks beschreibt das Problem als Zielkonflikt. Einen Unternehmensagenten aufzusetzen ist leicht, doch im Produktivbetrieb müssen Entwickler zwischen Qualität, also guten Antworten bei seltenen, speziellen Aufgaben, und Effizienz, also Kosten und Latenz im großen Maßstab, abwägen. Viele Techniken verbessern die eine Seite auf Kosten der anderen.
Speicher kann nach Darstellung des Unternehmens beides verbessern. Agenten können Nutzerpräferenzen, frühere Korrekturen, Metrikdefinitionen und erfolgreiche Arbeitsabläufe mitnehmen. Das erhöht im Prinzip die Genauigkeit, verringert wiederholte Fehler und erspart unnötiges erneutes Herausfinden. Databricks betont jedoch, dass mehr Verlauf nicht automatisch besserer Speicher ist. Jede frühere Interaktion einzuspeisen ist teuer und kann veralteten, widersprüchlichen oder irrelevanten Kontext einschleusen. Die zentralen Fragen lauten: Was wird behalten, wie wird es gepflegt, und wie lässt sich der Nutzen messen?
So funktioniert MemCurrent
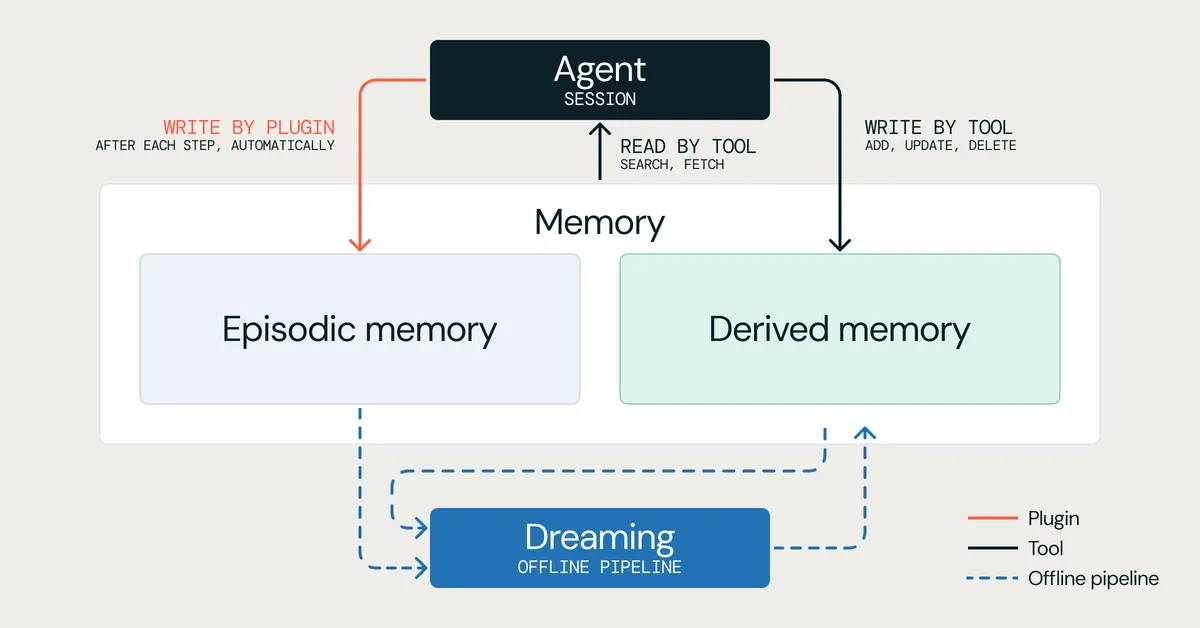
Databricks nennt drei Wege, Speicher an einen Agenten anzubinden: als Plugin, das an festen Stellen liest und schreibt, als Werkzeuge, die der Agent selbst aufruft, oder als Offline-Pipeline, die den Speicher im Hintergrund aktualisiert. Jeder Ansatz hat Nachteile. Plugins und Werkzeuge wirken sofort, verursachen aber Laufzeitkosten und Latenz, während eine Pipeline zur Laufzeit günstiger ist, Aktualisierungen aber verzögert ankommen. MemCurrent nutzt alle drei, jeweils dort, wo sie am besten passen.
Das System kennt zwei Arten von Speicher:
- Episodischer Speicher hält rohe Sitzungsprotokolle fest. Er wird nur fortgeschrieben (append-only), und ein Plugin protokolliert jeden Schritt, während eine Sitzung läuft.
- Abgeleiteter Speicher enthält verdichtete Erkenntnisse als Dateien in einer strukturierten Wissensbasis, an deren Spitze ein automatisch erzeugter Index namens memory.md die Dateistruktur beschreibt. Es handelt sich um eine veränderbare Tabelle, die ein hierarchisches Dateisystem nachbildet.
Beide liegen in einer produktionstauglichen Datenbank, die für viele Nutzer und Antworten mit geringer Latenz ausgelegt ist. Ausdrückliche Anweisungen wie "Never write scripts in the /tmp dir" verarbeiten die Agentenwerkzeuge add_memory, update_memory und delete_memory. Alles Übrige erfasst eine Offline-Pipeline, die als "Dreaming" bezeichnet wird und aus jeder neuen Sitzung implizite Erkenntnisse destilliert. Sie teilt außerdem zu große Dateien, führt Duplikate zusammen und löst Konflikte auf.
Das Lesen erfolgt in Schichten. Ein Plugin spielt zu Sitzungsbeginn den Speicherindex ein. Während der Sitzung kann der Agent search_memory aufrufen, um die besten Treffer zu erhalten, oder fetch_memory, um einen vollständigen Eintrag über Sitzungs-ID oder Dateipfad abzurufen.
Benchmarks und Ergebnisse
Databricks testete mit drei Open-Source-Benchmarks, LoCoMo, LongMemEval und ConvoMem, die prüfen, ob ein Agent Fakten aus synthetischen Gesprächen abrufen kann. Zusätzlich entstand ein Internal Memory Benchmark aus echten Genie-Gesprächen. Das Team ging von mehr als 12.000 Sitzungen aus, filterte 3.000 Kandidaten mit speicherrelevanten Signalen heraus und entwarf Folgefragen mit Bewertungsrastern. Ein adversarialer Prüfer kontrollierte jeden Fall anhand von 7 Kriterien. Nach manueller Prüfung umfasst der Benchmark 114 Testfälle, 29 Nutzer und 2.233 Verlaufssitzungen. Die Fälle decken 5 Speichertypen und 11 Szenarien ab. Laut Databricks unterscheidet er sich von bestehenden Benchmarks durch den Fokus auf Unternehmensarbeit, die Prüfung, ob Speicher Handlungen statt nur Antworten speist, sowie durch Vielfalt.
Bei den Open-Source-Benchmarks verglich das Unternehmen MemCurrent mit Mem0, PropMem und OpenClaw memory auf Basis desselben zugrunde liegenden LLM. Laut Databricks erzielte MemCurrent unter den Speicher-Backends in allen drei Tests den höchsten Wert. Im Durchschnitt kam es auf 88,1 % und lag damit gleichauf mit der Full-Context-Baseline (87,8 %), verbrauchte aber pro Frage rund 12-mal weniger Eingabe-Tokens (8,4K gegenüber 103K). In den beiden Benchmarks mit den längsten Verläufen schlug es den vollen Kontext.
Im internen Benchmark, der in Genie lief, erreichte MemCurrent eine Erfolgsquote von 68,4 %, die niedrigste Latenz (252 s) und den geringsten Token-Verbrauch (418K) unter den Backends. Damit schließt es über 80 % der Lücke zwischen dem Betrieb ohne Speicher (22,3 %) und der Gold-Injektion (78,6 %), bei der nur die richtigen Erinnerungen in den Kontext gelegt werden. Mem0 kam auf 43,9 % bei höherer Latenz und höheren Kosten. Gegenüber dem Betrieb ohne Speicher ist MemCurrent laut Databricks 1,35-mal schneller und 1,44-mal günstiger. Bei den internen Läufen diente Claude Opus 4.6 als Agentenmodell und GPT 5.6 sol als Speichermodell.
Was das für Nutzer bedeutet
Für Teams, die Agent Bricks Memory oder Genie einsetzen, ist MemCurrent die Schicht hinter den Speicherfunktionen. Die eigenen Zahlen von Databricks legen nahe, dass ein selektiver, gepflegter Speicher bessere Antworten zu geringeren Kosten liefern kann als gar kein Speicher oder ein mit dem gesamten Verlauf gefüllter Prompt. Die Ergebnisse stammen aus dem internen Benchmark des Unternehmens und seinem eigenen Testaufbau und wurden daher nicht unabhängig überprüft.
Databricks: MemCurrent: Designing Persistent Memory for Production Agents