Datadog Export Pipelines senden RUM- und Product-Analytics-Daten in die eigene Cloud
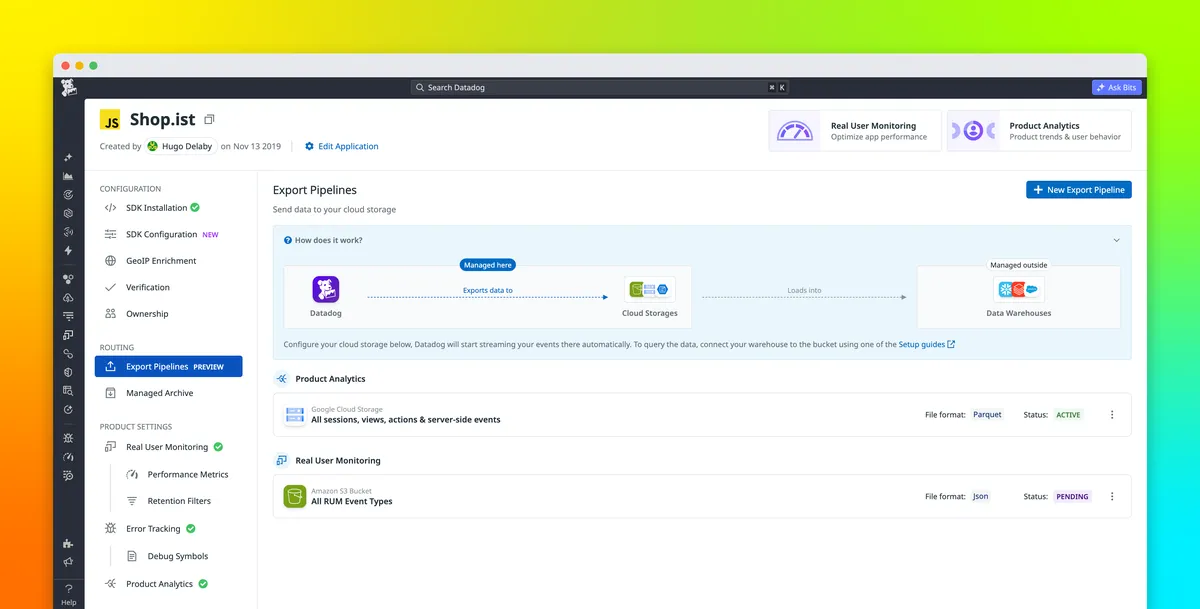
Datadog hat Export Pipelines vorgestellt, eine native Möglichkeit, Daten aus Real User Monitoring (RUM) und Product Analytics fortlaufend in den eigenen Cloud-Speicher eines Kunden zu übertragen. Als Ziel stehen laut Datadog Amazon S3, Azure Blob Storage oder Google Cloud Storage zur Auswahl.
- Export Pipelines senden RUM- und Product-Analytics-Daten von Datadog fortlaufend an Amazon S3, Azure Blob Storage oder Google Cloud Storage.
- Unterstützt werden die Formate Parquet und JSON, die Dateien sind nach Datum und Stunde organisiert.
- Pipelines werden in der Datadog-Oberfläche konfiguriert und zeigen den Status Active, Error, Pending oder Paused an.
- Als Anwendungsfälle nennt Datadog Warehouse-Analysen, das Training von ML-Modellen und die langfristige Aufbewahrung aus Compliance-Gründen.
- Laut Datadog beträgt die Standardaufbewahrung bei RUM 30 Tage und bei Product Analytics 15 Monate.
So funktionieren Export Pipelines
Datadog RUM und Product Analytics helfen Engineering- und Datenteams, anhand von Nutzersitzungsdaten die Verfügbarkeit und Performance von Anwendungen sowie das Nutzerverhalten zu verstehen. Teams können diese Daten zur Überwachung und Analyse in Datadog einspeisen. Laut Datadog benötigen sie die Ereignisdaten mitunter aber auch in einer Infrastruktur, die sie selbst kontrollieren, etwa für individuelle Analysen und Berichte, Workflows für maschinelles Lernen (ML) oder den langfristigen Datenzugriff.
Export Pipelines sollen genau diesen Bedarf abdecken. Nutzer konfigurieren die Pipeline in der Datadog-Oberfläche, wählen die zu exportierenden Performance- oder Verhaltensdaten aus und legen ein Ziel in Amazon S3, Azure Blob Storage oder Google Cloud Storage fest. Sobald die Pipeline eingerichtet ist, sendet Datadog passende Ereignisse fortlaufend an dieses Ziel. Damit entfällt laut Datadog die Notwendigkeit, eigene Export-Skripte oder geplante Jobs zu pflegen.
Dateiformate, Organisation und Pipeline-Status
Unterstützt werden zwei Dateiformate: Parquet und JSON. Laut Datadog lässt sich Parquet ohne Vorverarbeitung direkt in Snowflake, BigQuery und Databricks laden. JSON eignet sich für Teams mit eigenen Verarbeitungspipelines oder für alle, die eine flexiblere Darstellung der einzelnen Ereignisse brauchen.
Die Dateien werden am Speicherort nach Datum und Stunde organisiert. Nachgelagerte Prozesse können dadurch gezielt Dateien aus dem relevanten Zeitraum ansteuern, statt alle exportierten Dateien zu durchsuchen.
Export-Konfigurationen lassen sich aktivieren, deaktivieren oder aktualisieren, wenn sich die Anforderungen ändern. Die Seite „Export Pipelines“ zeigt den aktuellen Zustand jeder Pipeline an, nämlich Active, Error, Pending oder Paused. So können Nutzer prüfen, ob ihre Pipelines wie erwartet laufen.
Anwendungsfälle: Analytics, ML und Aufbewahrung
Datadog nennt drei Hauptanwendungen für die exportierten Daten:
- Analysen im Data Warehouse: Ein Analytics-Team könnte Product-Analytics-Ereignisse in einen Google-Cloud-Storage-Bucket exportieren und die Parquet-Dateien in BigQuery laden. Analysten könnten dann Anwendungsaktionen und Nutzerverhalten mit Datensätzen wie Abonnements, Kontoattributen oder Finanzdaten verknüpfen, ohne eine zweite Anwendungsinstrumentierung einzuführen.
- Maschinelles Lernen: Data-Science-Teams können RUM- und Product-Analytics-Ereignisse an einen Cloud-Speicher senden und mit eigenen Transformations- und Modellierungspipelines Modelle für Personalisierung, Abwanderungsprognosen, Empfehlungen oder Anomalieerkennung trainieren.
- Compliance-bedingte Aufbewahrung: Export Pipelines können Organisationen helfen, die langfristigen Zugriff auf Ereignisdaten in einer von ihnen kontrollierten Infrastruktur sicherstellen müssen.
Zur Aufbewahrung erklärt Datadog, RUM biete eine Standardaufbewahrung von 30 Tagen und mit RUM Managed Archive eine Speicherung über 6 Monate, während Product Analytics die Daten 15 Monate lang vorhalte. Organisationen, die darüber hinaus Zugriff benötigen, können die relevanten Ereignisse in einen Cloud-Speicher exportieren und dort ihre eigenen Richtlinien für Speicherung, Zugriff und Lebenszyklus anwenden.
Was das für Nutzer bedeutet
Für Teams, die bereits Datadog RUM oder Product Analytics einsetzen, bieten Export Pipelines einen integrierten Weg, Sitzungs- und Verhaltensdaten in die eigenen Data Warehouses und ML-Werkzeuge zu überführen, statt eigenen Export-Code zu entwickeln und zu betreiben. Laut Datadog bleiben die Daten in dem Format und an dem Ziel verfügbar, das für den jeweiligen Workflow am besten passt.
Für Details verweist das Unternehmen auf die Dokumentation zu Export Pipelines. Neukunden können sich für eine 14-tägige kostenlose Testphase anmelden, um den Export von RUM- und Product-Analytics-Daten in ihren Cloud-Speicher auszuprobieren.
Datadog: Export RUM and Product Analytics data with Export Pipelines