Datadog ergänzt Kubernetes-Monitoring für Inferenz-Workloads in Preview
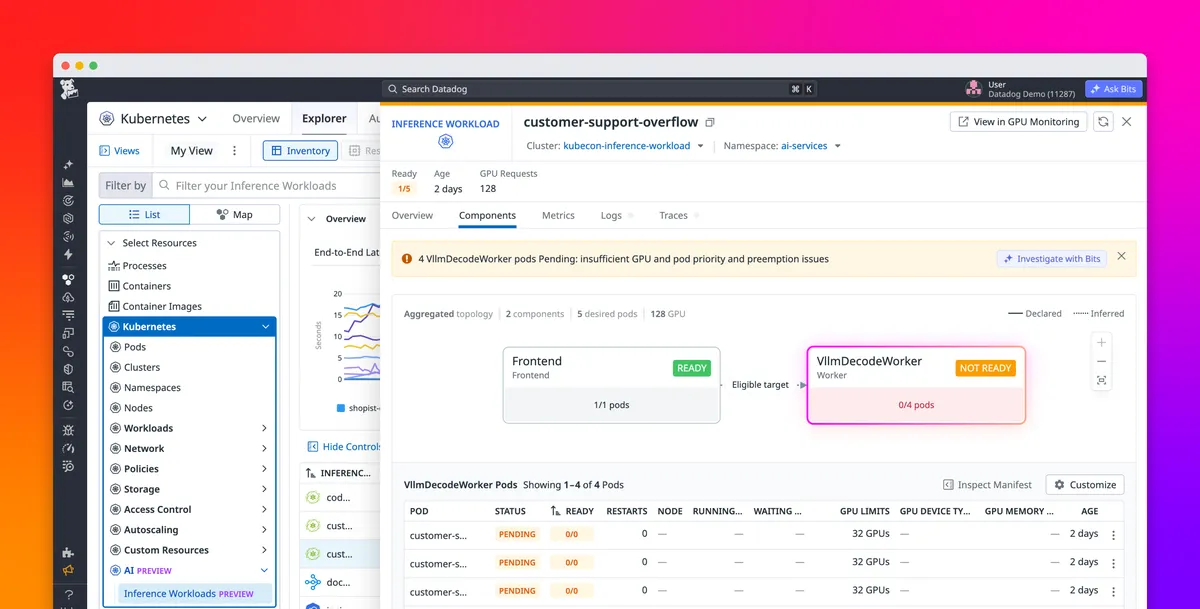
Datadog hat seine Funktion für Kubernetes-Inferenz-Workloads als Preview vorgestellt. Sie bietet Ingenieurinnen und Ingenieuren eine konsolidierte Ansicht der Modellkonfiguration, Serving-Komponenten, Pod-Zustände und Laufzeitmetriken. Die Funktion soll Teams dabei helfen, Inferenzfehler, Lücken bei der Bereitschaft und Kapazitätsengpässe über Kubernetes-Ressourcen hinweg nachzuverfolgen.
- Datadogs Funktion für Kubernetes-Inferenz-Workloads ist als Preview verfügbar.
- Sie verknüpft benutzerdefinierte Inferenzressourcen mit zugehörigen Kubernetes-Objekten und Serving-Engines.
- Unterstützte vLLM-basierte Workloads verwenden KubeRay, NVIDIA Dynamo oder KServe.
- Die Registerkarten Components und Metrics helfen bei der Untersuchung von Bereitschaft, Ressourcennutzung und GPU-Zustand.
- Kubernetes-MCP-Tools können über Bits Workload-Kontext liefern und Untersuchungsschritte empfehlen.
Eine Ansicht für verteilte Inferenzressourcen
Inferenz-Frameworks verteilen Serving-Aufgaben auf Kubernetes-Ressourcen. Dadurch müssen Ingenieurinnen und Ingenieure Modellkonfiguration, Pod-Status und Scheduling-Ereignisse möglicherweise über separate Befehle und Dashboards hinweg vergleichen. Datadogs Inferenz-Workload ist eine virtuelle Ressource, die die Kubernetes-Ressourcen gruppiert, welche ein Serving-Modell unterstützen.
Im Kubernetes Explorer können Ingenieurinnen und Ingenieure anhand von Modell-, Framework- und Clusterkontext einen Workload identifizieren und zugehörige Pods, Deployments, ReplicaSets und benutzerdefinierte Ressourcen untersuchen. Datadog zufolge verknüpft die Funktion die benutzerdefinierte Ressource mit den von ihr verwalteten Kubernetes-Objekten und der Inferenz-Engine, etwa vLLM, das innerhalb von Serving-Containern ausgeführt wird.
Die Funktion unterstützt vLLM-basierte Workloads mit KubeRay, NVIDIA Dynamo und KServe. Datadog zufolge gaben 66 % der Unternehmen, die generative KI-Modelle hosten, in der CNCF-Umfrage von 2025 an, Kubernetes für einige oder alle ihrer Inferenz-Workloads einzusetzen.
Bereitschaft, Telemetrie und Scheduling korrelieren
Datadog erkennt automatisch Pods, auf denen unterstützte Inferenz-Frameworks laufen, und weist ihnen die Tags inference_workload und inference_workload_component zu. Metriken, Traces und Logs übernehmen diese Tags, wenn sie den relevanten Pods zugeordnet werden können. Dadurch können Ingenieurinnen und Ingenieure Telemetriedaten für einen Workload oder eine Komponente über verschiedene Datadog-Produkte hinweg korrelieren.
Die Registerkarte Components zeigt den Pod-Zustand innerhalb der Serving-Struktur eines Frameworks, darunter Ray-Head- und Worker-Komponenten oder Dynamo-Frontend- und Worker-Komponenten. Ingenieurinnen und Ingenieure können Bereitschaft und Pod-Anzahl prüfen und anschließend Pod-Status, Neustarts, Knotenplatzierung und Scheduling-Details untersuchen. So lässt sich unterscheiden, ob Pods auf Ressourcen warten oder laufende Pods fehlerhaft sind.
Die Registerkarte Metrics liefert Informationen zur Laufzeitleistung und Ressourcennutzung. Für Dynamo-Workloads mit kostenpflichtigem GPU-Monitoring-Zugang und entsprechend konfigurierter Datensammlung stehen unter anderem Metriken zu GPU-Speicher, Aktivität und Auslastung sowie zur CPU- und Speichernutzung der Container zur Verfügung. Über View in GPU Monitoring können Ingenieurinnen und Ingenieure den Zustand der Geräte untersuchen.
Kapazitätsengpässe bei GPUs erkennen
Datadog veranschaulicht die Funktion anhand eines Dynamo-Modells mit getrennten Prefill- und Decode-Komponenten. Wenn ein Decode-Worker-Pod im Status Pending feststeckt, können seine Scheduling-Details eine unzureichende Kapazität für den erforderlichen GPU-Typ melden. Diese Information kann erklären, warum die angeforderte Serving-Kapazität nicht verfügbar geworden ist.
Auf der Seite Inference Workloads können Ingenieurinnen und Ingenieure nach GPU-Typ filtern und andere Workloads untersuchen, die diese Kapazität nutzen. Im Beispiel belegt ein Dynamo-Modell mit niedrigerer Priorität Kapazität, die ein kritischer Workload benötigt. Die Prüfung seines Modellbedarfs und seiner Ressourcenkonfiguration kann Teams dabei helfen zu beurteilen, ob eine Verkleinerung angemessen ist.
Datadog zufolge nutzt Investigate with Bits außerdem Kubernetes-MCP-Tools, um Kontext zu ausstehenden Pods zu sammeln und nächste Schritte zu empfehlen. Im Beispiel könnte eine Verringerung der Replikate des Modells mit niedrigerer Priorität GPU-Kapazität für den Decode-Worker des kritischen Modells freigeben, sofern die freigegebenen Ressourcen dessen Scheduling-Anforderungen erfüllen.
Was die Preview für Kubernetes-Teams bedeutet
Die Funktion führt Orchestrierungskonfiguration, Serving-Bereitschaft, Pod-Status, Scheduling-Hinweise und, sofern konfiguriert, GPU-Telemetrie in einem verknüpften Untersuchungsprozess zusammen. Datadog zufolge kann dieser Kontext Teams dabei helfen, von einem Symptom auf Modellebene zu den dahinterliegenden Pods und Kapazitätsengpässen vorzudringen und anschließend mögliche Workload-Anpassungen oder eine Neuzuweisung von GPUs zu bewerten.
Inferenz-Workloads sind auch über Datadogs Kubernetes-MCP-Tools verfügbar. Über einen MCP-kompatiblen Assistenten können Nutzerinnen und Nutzer Inferenz-Workloads ermitteln, ihr Modell und Framework identifizieren und zugrunde liegende Ressourcendetails, übergeordnete Beziehungen und Manifeste untersuchen, während sie Pod-Status und Konfiguration analysieren.
Die Funktion für Kubernetes-Inferenz-Workloads ist als Preview verfügbar. Datadog verweist für weitere Informationen auf seine Produkte Container Monitoring und GPU Monitoring und bietet Menschen, die Datadog noch nicht nutzen, eine kostenlose 14-Tage-Testversion an.
Datadog: Troubleshoot Kubernetes inference workloads with Datadog