Datadog führt Online Experiments ein, um Änderungen an KI-Agenten im Live-Betrieb zu vergleichen
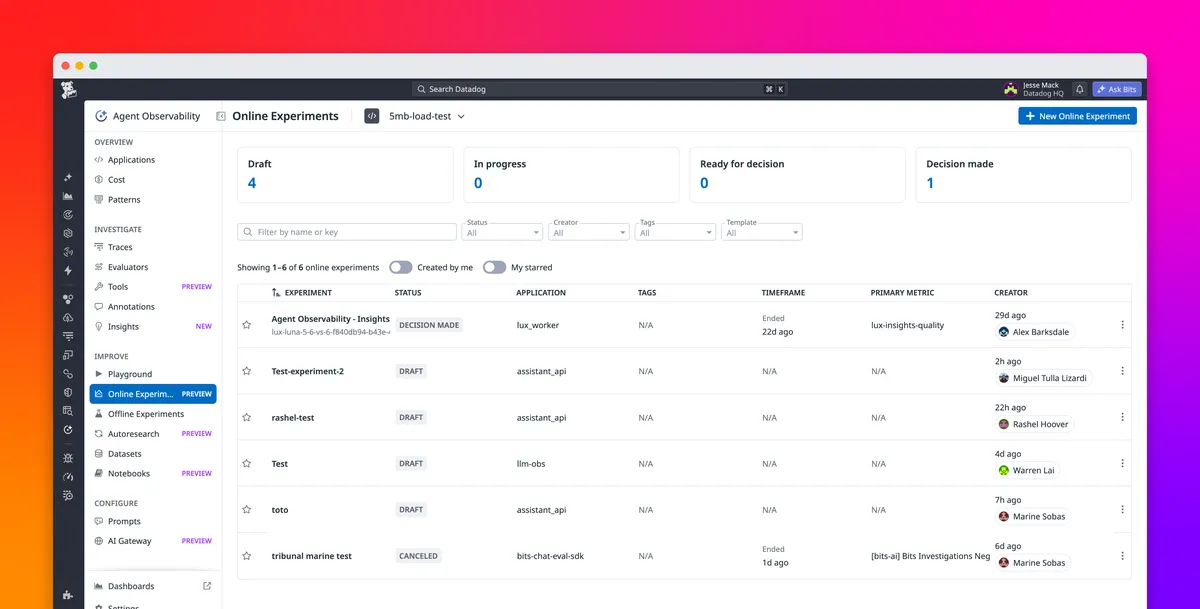
Datadog hat in seinem Produkt Agent Observability die Funktion Online Experiments eingeführt, mit der Teams Varianten eines KI-Agenten auf echtem Produktionsverkehr vergleichen können. Das Tool misst die Antwortqualität neben operativen Kennzahlen wie Latenz, Kosten, Token-Verbrauch und Fehlern.
- Datadog hat Online Experiments in Agent Observability eingeführt, um KI-Agenten-Varianten auf Live-Produktionsverkehr zu vergleichen.
- Die Funktion kombiniert Agent-Evaluierungen mit Datadog Experiments und deckt Qualität, Latenz, Kosten, Token-Verbrauch und Fehler ab.
- Datadog Feature Flags können die Traffic-Aufteilung und Reichweite steuern, ohne neu auszurollen.
- In Datadogs internem Test lagen die geschätzten Kosten von GPT-6 Luna um 44,3 % unter denen von GPT-5.6 Luna.
- Die Qualitätswerte lagen mit 3,84 für Luna 5.6 und 3,86 für Luna 6 dicht beieinander.
Warum sich Änderungen an Agenten schwer bewerten lassen
Laut Datadog bedeutet die Verbesserung eines KI-Agenten oft, Prompts, Modelle, Retrieval-Methoden oder Tools zu ändern. Ob eine Änderung tatsächlich hilft, ist schwer zu beurteilen. Ein überarbeiteter Prompt liefert bei einer Handvoll Testfälle womöglich bessere Antworten, geht aber mit unerwarteten Nutzeranfragen schlechter um. Ein günstigeres Modell kann die Token-Kosten senken, dafür aber Fehler bei Tool-Aufrufen oder längere Ausführungszeiten mit sich bringen.
Datadog zufolge müssen Teams vor einem Rollout verstehen, wie sich eine Änderung unter realer Nutzung auf Qualität, Zuverlässigkeit und Kosten auswirkt. Genau dafür ist Online Experiments in Agent Observability gedacht. Die Funktion kombiniert Agent-Evaluierungen mit Datadog Experiments, und Nutzer können zusätzlich die zugrunde liegenden Traces einsehen, um zu erkennen, warum sich das Verhalten geändert hat.
Offline- und Online-Experimente im Vergleich
Datadog beschreibt Offline-Experimente als festen Bestandteil der Agentenentwicklung. Teams lassen Agentenversionen gegen vordefinierte Datensätze laufen, vergleichen die Ausgaben und fangen bekannte Regressionen vor dem Deployment ab. In Agent Observability decken Offline-Experimente sowohl einzelne Komponenten als auch vollständige Agenten-Workflows ab.
Das Unternehmen weist auf die Grenzen dieses Ansatzes hin. Umfassende Offline-Datensätze aufzubauen kostet Zeit und erfordert Produktkenntnis. Teams müssen repräsentative Anfragen auswählen, sich darauf einigen, wie gutes Verhalten aussieht, und festlegen, welche Prüfungen eine Regression sichtbar machen. Ein modellbasierter Judge braucht eine Bewertungsrubrik, die das Team versteht, sowie einen Menschen, der seine Einschätzungen überprüft. Diese Arbeit hört nicht auf, solange sich das Produkt weiterentwickelt.
Online-Experimente stützen sich stattdessen auf Online-Evaluierungen, die das Agentenverhalten in der Produktion bewerten. Datadog zufolge erkennen Teams so Muster, die in Offline-Datensätzen fehlen, und die Erkenntnisse können später helfen, bessere Offline-Datensätze zu bauen.
Als Beispiel nennt das Unternehmen einen Support-Agenten, dessen Suchtool lange Textpassagen zurückgibt und damit wiederholte Suchen auslöst. Ein Offline-Test könnte prüfen, ob kürzere Auszüge weiterhin relevante Quellenangaben liefern, würde aber womöglich das gesamte Spektrum der Nutzeranfragen verfehlen oder die Frage offenlassen, ob Nutzer ihre Probleme tatsächlich lösen.
So funktioniert Online Experiments
Teams behalten die bestehende Agentenversion als Kontrollgruppe und testen eine geänderte Version im selben Zeitraum bei zufälliger Zuweisung. Datadog zufolge trennt dies den Effekt der Änderung von bereits bestehenden Unterschieden in der Nutzung, etwa wenn ein neues Suchtool nur deshalb besser wirkt, weil es leichtere Fragen erhält.
Nutzer können in Agent Observability erstellte Evaluatoren mit Experiment-Metriken verknüpfen, zusammen mit operativen Kennzahlen, die sie selbst erfassen. Experiments berechnet daraus relative Veränderungen und Konfidenzintervalle. Datadog Feature Flags können die Aufteilung des Traffics steuern und die Reichweite anpassen, ohne die Anwendung neu auszurollen. So kann ein Team mit einem kleinen Nutzeranteil beginnen und dabei eine Kontrollgruppe behalten.
Datadog betont, dass die Messgrößen zur jeweiligen Entscheidung passen sollten. Ein überarbeitetes Tool könnte die Qualität der Belege verbessern, aber zusätzliche Suchen verursachen, und ein günstigeres Modell braucht womöglich mehr Versuche, um eine Aufgabe abzuschließen. Wer Evaluierungswerte mit Dauer, Kosten und Fehlern vergleicht, macht solche Zielkonflikte sichtbar.
Datadogs eigener Test eines Modellwechsels
Datadog hat die Funktion an seinem Insights-Agenten erprobt, der anhand von Trace-Belegen das Verhalten von Agenten untersucht. Verglichen wurden OpenAIs GPT-5.6 Luna und GPT-6 Luna. Die Frage lautete, ob die niedrigeren Modellpreise von Luna 6 günstigere Untersuchungen bedeuten und was der Wechsel für Qualität und Tool-Verhalten heißt.
Der Traffic wurde gleichmäßig aufgeteilt, wobei Luna 5.6 als Referenz diente. Die primäre Messgröße war die Untersuchungsqualität, die ein LLM-Judge auf einer Skala von 1 bis 5 bewertete, basierend auf der Anfrage, den Ein- und Ausgaben der Tools und den Schlussfolgerungen des Agenten. Die Rubrik umfasste Genauigkeit, Vollständigkeit und die Frage, wie gut die Schlussfolgerungen aus den Belegen folgten, einschließlich der Angabe von Unsicherheit oder fehlenden Daten. Dauer, geschätzte Kosten, geschätzter Token-Verbrauch und Workflow-Fehler wurden als separate Messgrößen aus den Traces erfasst.
Die geschätzten Kosten von Luna 6 lagen um 44,3 % niedriger, bei einem Konfidenzintervall von 37,5 % bis 51,2 % weniger. Datadog sieht darin die Hypothese bestätigt, dass der Modellwechsel die Kosten der Untersuchungen senken könnte. Die Qualitätswerte lagen mit 3,84 für Luna 5.6 und 3,86 für Luna 6 dicht beieinander, wobei Datadog anmerkt, dass ähnliche Durchschnittswerte allein keine Gleichwertigkeit belegen.
Was das für Teams bedeutet
Für Teams, die KI-Agenten betreiben, bietet die Funktion die Möglichkeit, Änderungen an Prompts, Modellen, Retrieval oder Tools vor dem vollständigen Rollout an echtem Traffic zu testen, mit Qualität und Betriebskosten in einer Ansicht. Datadogs eigenes Beispiel zeigt eine Kostensenkung, die zusammen mit der Qualität gemessen statt bloß angenommen wurde.