Dharma Field Extractor wandelt Dokumente in strukturierte JSON-Felder um
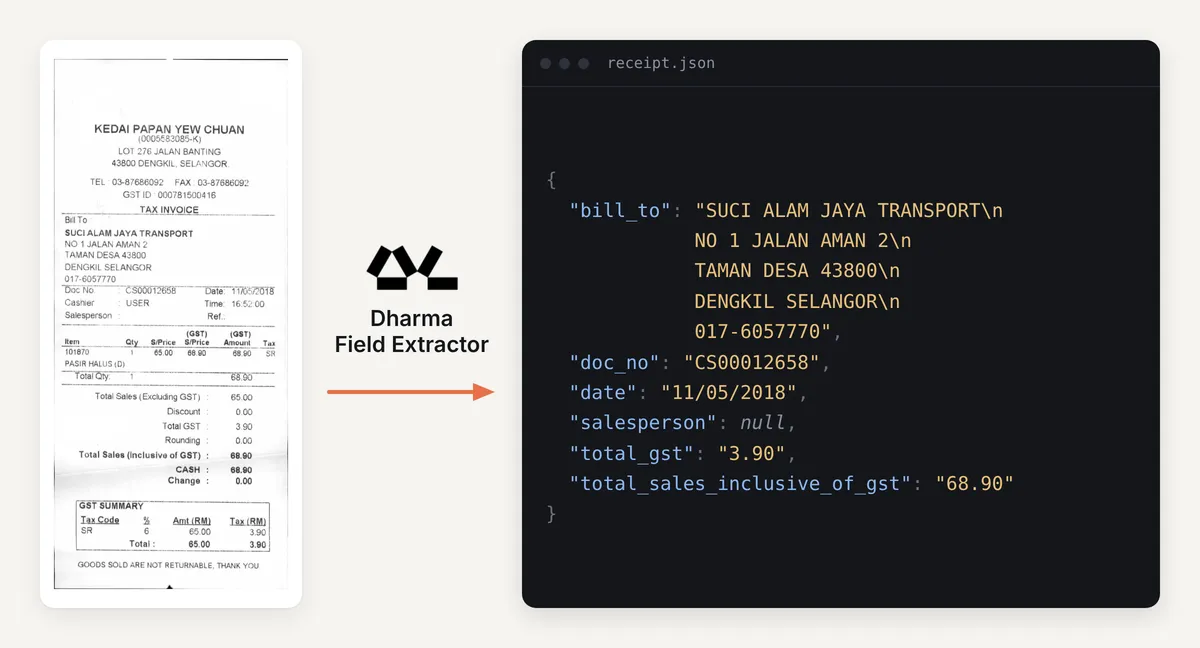
Dharma-AI hat auf Hugging Face einen Beitrag zum Dharma Field Extractor veröffentlicht. Das Werkzeug soll beliebige Dokumente entgegennehmen und strukturierte Felder im JSON-Format zurückgeben. Auf der Seite sind ein Modell, acht Datensätze und ein Demo-Space verlinkt.
- Dharma-AI hat auf Hugging Face einen Beitrag mit dem Titel "Dharma Field Extractor: Any Document In, Structured Fields in JSON Out" veröffentlicht.
- Das verlinkte Modell ist mit dem Tag Image-Text-to-Text versehen und als 4B gekennzeichnet.
- Der Beitrag erwähnt ein Modell, acht Datensätze und einen Space.
- Der Space DharmaOCR Lite Demo wird als Werkzeug zum Extrahieren von Text und Tabellen aus Dokumentbildern beschrieben.
- Die Quelle enthält keine Benchmarks, Lizenzangaben oder Details zum Schema.
Was der Beitrag vorstellt
Der Beitrag trägt den Titel "Dharma Field Extractor: Any Document In, Structured Fields in JSON Out" und erscheint auf Hugging Face unter dem Autorennamen Dharma-AI. Der Titel benennt das Ziel: Nutzer geben ein Dokument ein und erhalten dessen Inhalte als strukturierte Felder in JSON, einem Format, das sich von anderer Software direkt weiterverarbeiten lässt.
Das verlinkte Modell ist mit dem Tag Image-Text-to-Text versehen und als 4B gekennzeichnet. Das bedeutet, dass es aus einem Bild und einer Texteingabe einen Text erzeugt. Das passt zu einer Aufgabe, bei der ein gescanntes oder fotografiertes Dokument die Eingabe und die extrahierten Felder die Ausgabe sind. Der Eintrag des Modells trägt eine Aktualisierungsmarkierung vom 17. April.
Modelle, Datensätze und die Demo
Laut der Seite werden in dem Artikel ein Modell, acht Datensätze und ein Space erwähnt. Der Space heißt DharmaOCR Lite Demo und wird als Werkzeug beschrieben, um "Extract text and tables from document images", also Text und Tabellen aus Dokumentbildern zu extrahieren. So können Leser die Dokumentextraktion direkt im Browser ausprobieren, statt nur darüber zu lesen.
Der für diesen Bericht verfügbare Quelltext ist dünn. Er besteht überwiegend aus Seitennavigation und Metadaten und enthält daher keine Angaben etwa zu Benchmark-Ergebnissen, unterstützten Dokumenttypen, dem vom Modell verwendeten JSON-Schema, der Lizenzierung oder der Entstehung der acht Datensätze. Diese Punkte werden hier nicht behandelt, weil die Quelle sie nicht nennt.
Weitere Arbeiten desselben Autors
Auf der Seite sind außerdem zwei weitere Beiträge desselben Autors aufgeführt. Einer trägt den Titel "How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications" und ist auf den 21. Oktober 2026 datiert. Der andere heißt "Same Cluster, 33 Points More Utilization: What Changed Was the Order" und stammt vom 17. August 2026.
Die Titel deuten darauf hin, dass sich der Autor mit praktischen Effizienzfragen rund um kleine Sprachmodelle und die Auslastung von Rechenressourcen beschäftigt. Die Quelle erklärt jedoch nicht, wie oder ob diese Beiträge mit dem Field Extractor zusammenhängen. Die Angaben von 77 Prozent und 33 Punkten stehen nur in diesen Titeln und sind Behauptungen des Autors.
Was das für Nutzer bedeutet
Für Entwickler, die mit Dokumenten wie Formularen oder Scans arbeiten, zielt ein Modell, das direkt strukturiertes JSON ausgibt, darauf ab, einen separaten Parsing-Schritt überflüssig zu machen. Der öffentliche Demo-Space und die verlinkten Datensätze bieten eine Möglichkeit, den Ansatz zu testen. Da die Quelle keine Leistungsdaten nennt, müssen Interessenten Genauigkeit und Eignung selbst an ihren eigenen Dokumenten prüfen.
Hugging Face: Dharma Field Extractor: Any Document In, Structured Fields in JSON Out