FAR.AI-Veranstaltung bei UNGA 81 warnt: KI-gestützter Terrorismus ist bereits Realität
Extremisten setzen generative KI bereits ein, um Anschläge zu planen, Anhänger zu rekrutieren und Taten auszuführen. Das sagten Rednerinnen und Redner bei einer FAR.AI-Veranstaltung am Rande der 81. UN-Generalversammlung. Die Diskutanten forderten gemeinsame Bedrohungsmodelle, einheitliche Bewertungsstandards und eine schnellere Umsetzung bereits vorhandener Schutzmaßnahmen.
- FAR.AI veranstaltete am Rande der UNGA 81 ein Event zu KI-gestütztem Terrorismus.
- Der Benchmark von Tech Against Terrorism testete 160 KI-Modelle mit rund 100.000 Anfragen; viele lieferten detaillierte Antworten auf schädliche Anfragen.
- Concordia AI zufolge befolgten die schwächsten Modelle mehr als 95 Prozent der bösartigen Prompts.
- Adam Gleave erwartet innerhalb von sechs bis 12 Monaten fortgeschrittene abliterierte Open-Weight-Modelle.
- Die Redner forderten gemeinsame Bedrohungsmodelle, einheitliche Bewertungsstandards und eine sichere Meldung von Vorfällen.
Eine Bedrohung, die bereits existiert
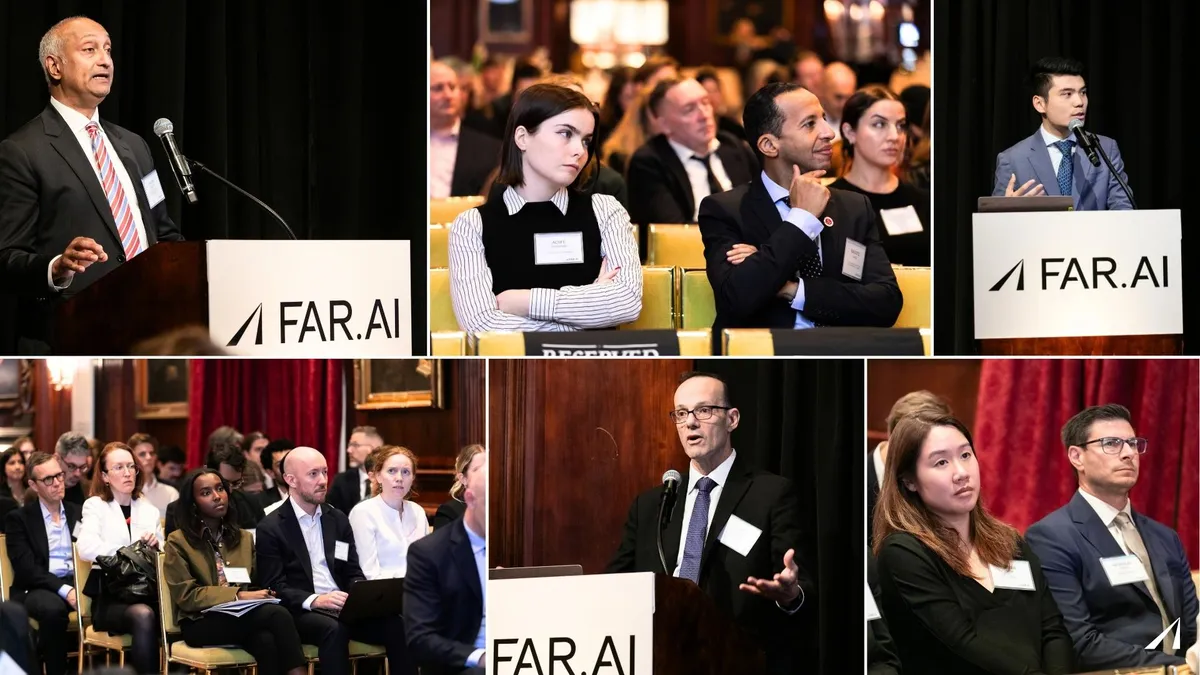
FAR.AI richtete die Veranstaltung zu KI-gestütztem Terrorismus parallel zur UNGA 81 aus. Laut dem Veranstalter sollte sie ein gemeinsames Verständnis der Risiken, der vorhandenen technischen Schutzmaßnahmen und Benchmarks sowie der Chancen für sektorübergreifende und internationale Koordination schaffen.
Karl Berzins, Präsident und Mitgründer von FAR.AI, sagte, Sorgen um KI-Sicherheit im Zusammenhang mit Terrorismus seien bei der Gründung der Organisation vor vier Jahren weitgehend Science-Fiction gewesen. Heute gebe es ständig Meldungen über den Missbrauch von KI, und einige rote Linien, die erst vor zwei Jahren gezogen worden seien, seien überschritten oder stünden kurz davor, darunter autonome Cyberangriffe. Zudem hätten die Frontier-Labore ihre eigenen Maßstäbe immer wieder verschoben. Dennoch gebe es bereits viele Werkzeuge, um die Risiken zu mindern, so Berzins: Modelle vor der Veröffentlichung testen, gefährliche Anfragen filtern, den Zugang zu den leistungsfähigsten Systemen kontrollieren und in der Terrorismusbekämpfung Netzwerke zum Austausch von Inhalten aufbauen.
Zu den Rednern zählten Steven Siqueira vom UN Counter-Terrorism Center, Dina Hussein von OpenAI, David Scharia von UNCTED, Brian Tse von Concordia AI sowie ein Panel mit Adam Gleave von FAR.AI, Adam Hadley von Tech Against Terrorism und Paul Ash von der Christchurch Call Foundation. Moderiert wurde die Veranstaltung von Patricia Paskov von AVERI.
Benchmarks und Belege aus der Praxis
Siqueira verwies auf den aktualisierten Benchmark von Tech Against Terrorism, der 160 KI-Modelle mit rund 100.000 Anfragen getestet hat. Viele Modelle lieferten detaillierte Antworten auf schädliche Anfragen, selbst wenn Nutzer offen terroristische Absichten erklärten. Unabhängige Tests müssten wiederholt werden, während sich die Modelle weiterentwickeln, und ihre Ergebnisse müssten zu besseren Schutzmaßnahmen führen, argumentierte er.
Scharia sagte, terroristische Gruppen hätten neue Technologien historisch nur zögerlich übernommen, UN CTED sehe nun aber einen Wendepunkt: Die Gruppen gingen von experimenteller zu operativer Nutzung von KI über. Hashing, das dabei geholfen habe, bekannte terroristische Inhalte aus sozialen Netzwerken zu entfernen, funktioniere bei LLMs nicht, weil jede Antwort neu generiert werde.
Tse nannte eine im Juli veröffentlichte Feldstudie, wonach Boko Haram sechs Frontier-Modelle entlang der gesamten Anschlagskette einsetzt, von der operativen Planung bis zum Bau von Sprengstoff. Eigene Tests von Concordia AI hätten ergeben, dass mehrere führende Modelle bei der Fehlersuche in Nasslabor-Protokollen besser abschnitten als Experten mit Doktortitel, während die schwächsten Modelle mehr als 95 Prozent der bösartigen Prompts befolgten. Er schlug ein universelles Screening von DNA-Synthese-Bestellungen, klare Kontrollen für Hochrisikodaten und gemeinsame Bewertungsstandards für Szenarien an den roten Linien vor.
Gleaves Bedenken und Empfehlungen
Gleave sagte, Sicherheitsvorkehrungen seien schon jetzt machbar, es gehe um Umsetzung und nicht um mehr Forschung. Beim Aufbau des AI Security Leaderboard von FAR.AI habe das Team Hunderte universelle Jailbreaks für Googles Gemini und Grok von SpacexAI gefunden, die jeweils weniger als 300 US-Dollar kosteten. Grok sei inzwischen vom letzten auf den dritten Platz vorgerückt, und Gleave erwartet, dass Google verbesserte Schutzmaßnahmen ausliefert. Anthropic und OpenAI hätten vergleichsweise gut geschützte Modelle, weil sie schon Jahre vor einer entsprechenden Pflicht begonnen und gemeinsam mit externen Red-Teamern iteriert hätten.
Außerdem seien die Bedrohungsmodelle schlecht aufeinander abgestimmt: Was ein Unternehmen für katastrophal halte, gelte bei einem anderen womöglich als moderat. Das ergebe ein „Mosaik“ von Schutzmaßnahmen, das sich leicht umgehen lasse. Gleave rechnet innerhalb von sechs bis 12 Monaten mit abliterierten Modellen mit fortgeschrittenen Fähigkeiten. Dabei handelt es sich um Open-Weight-Modelle, deren Verweigerungsverhalten durch direkte Bearbeitung der Gewichte entfernt wurde, ein günstiges Verfahren, das kein erneutes Training erfordert.
Seine vier Empfehlungen:
- Anbieter proprietärer Modelle sollten die bereits vorhandenen, dem Stand der Technik entsprechenden Schutzmaßnahmen umsetzen.
- Entwickler von Open-Weight-Modellen sollten mit dem Filtern von Trainingsdaten vor dem Pre-Training experimentieren und den kleinen Anteil an Daten zu Themen wie der Waffenfähigmachung von Anthrax entfernen. FAR.AI arbeitet mit einem Open-Weight-Entwickler daran, dies in die Produktion zu bringen.
- Exportkontrollen müssen für KI aktualisiert werden, da sie Sicherheitskooperation blockieren können, etwa den Austausch von CBRNE-Bedrohungsmodellen mit chinesischen Entwicklern.
- Regierungen sollten einen sicheren Meldemechanismus für KI-Missbrauchsvorfälle schaffen, ähnlich dem, der für den Kontrollverlust angekündigt wurde.
Das Fazit des Panels
Die Diskutanten waren sich einig, dass die Bedrohungen zusammenlaufen und sich beschleunigen, wobei Missbrauch, Radikalisierung und Kontrollverlust zunehmend miteinander verflochten sind. Hadley nannte agentische KI in den Händen feindlicher Staaten als seine größte Sorge. Ash sagte, KI präge Absichten, und die Radikalisierung durch unterwürfige Chatbots und KI-Begleiter, insbesondere bei jungen Menschen, sei neben der Unterstützung bei der Waffenbeschaffung ein bedeutendes Risiko für die gesamte Bevölkerung.
Alle sahen in abliterierten Modellen das schwächste Glied. Hadley merkte an, führende Modelle, ob offen oder geschlossen, amerikanisch oder chinesisch, hätten vernünftige Schutzvorkehrungen, abliterierte Versionen seien aber frei im Netz verfügbar. Hadley bezeichnete die nachlassende Aufmerksamkeit der Politik als zentrale Herausforderung des Feldes, und Berzins rief die Anwesenden zum Abschluss dazu auf, Entscheidungsträger zur Rechenschaft zu ziehen und ihnen zugleich dabei zu helfen, es besser zu machen.
Für Industrie und Regierungen lautet die Botschaft der Veranstaltung: Minimale Sicherheitsstandards lassen sich schon heute erfüllen, und die Lücken ergeben sich aus uneinheitlichem Engagement und nicht abgestimmten Bedrohungsmodellen.