Fireworks AI trainiert Muse Glimmer darauf, Jev bei Prognosen zu Kalshi-Märkten zu schlagen
Fireworks AI zufolge hat eine auf historische Kalshi-Märkte feinabgestimmte Version von Muse Glimmer 30B Ergebnisse genauer vorhergesagt als Jev: Bei unbekannten Themen erreichte sie 58,3 Prozent gegenüber 47,1 Prozent. Zugleich bietet das Unternehmen bis zum 30. November kostenloses überwachtes Fine-Tuning auf dem Modell an, als Auftakt seines Free Weights Club.
- Muse Glimmer 30B lässt sich bei Fireworks bis zum 30. November kostenlos per SFT feinabstimmen.
- Bei unbekannten Themen erreichte das angepasste Glimmer 58,3 Prozent Genauigkeit gegenüber 47,1 Prozent bei Jev, ein Abstand von 11,2 Punkten.
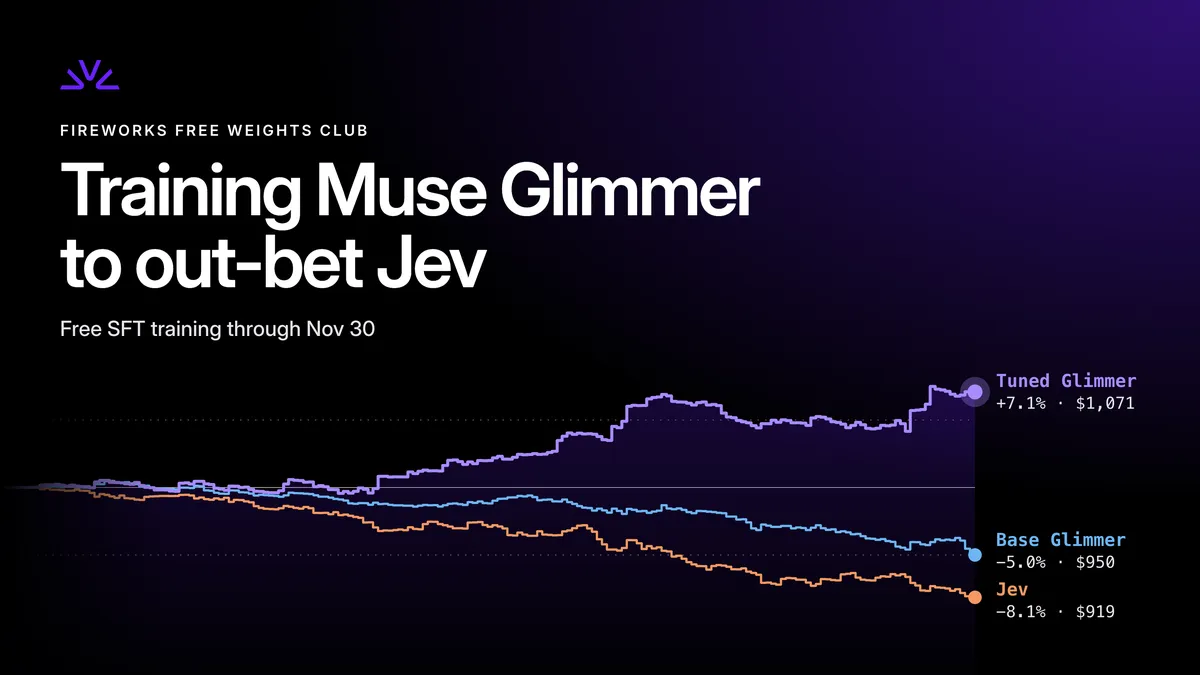
- Hypothetische 1.000 Dollar wuchsen beim angepassten Glimmer nach modellierten Gebühren auf 1.071 Dollar, während Basis-Glimmer und Jev Verluste machten.
- Laut Fireworks war System One in einem synthetischen Benchmark bei der medianen Server-Verarbeitung 2- bis 3-mal schneller als BF16-Chat-Completions.
- Der Backtest ignoriert Liquidität und Slippage, die Leistung mit echtem Geld ist ungetestet.
Kostenloses Training auf Muse Glimmer 30B
Fireworks AI hat den Free Weights Club gestartet. In dem Programm verspricht das Unternehmen neue Post-Training-Forschung, ein Rezept zum Aufbauen und für begrenzte Zeit kostenloses Training auf einem ausgewählten Modell. Das erste Modell ist Muse Glimmer 30B, wobei überwachtes Fine-Tuning (SFT) bis zum 30. November kostenlos ist. Laut Fireworks ist das Modell multimodal, bietet für die Kosten eine starke Leistung und eignet sich gut als Ausgangspunkt für persönliche Agenten.
Für Entwickler, die eigene Experimente durchführen wollen, verweist das Unternehmen auf ein Kalshi-Cookbook. Managed Training führt den SFT-Job anhand der Beispiele eines Nutzers aus, während die Serverless Training API Kontrolle über die Trainingsschleife bietet.
So wurde das Experiment aufgebaut
Das erste Experiment ging der Frage nach, ob ein Training von Muse Glimmer auf abgerechneten Kalshi-Märkten dem Modell einen Vorteil bei der Vorhersage von Ergebnissen verschaffen kann. Jedes Beispiel enthielt Titel, Beschreibung, Regeln und Datum eines Marktes, das abgerechnete Ergebnis diente als Label. Marktpreise oder Nachrichten sah das Modell nicht.
Fireworks hielt drei Datensätze getrennt:
- Training: 20.051 Fragen aus 6.461 Ereignissen, die vor dem 4. Januar 2026 abgerechnet wurden.
- Kalibrierung: 6.232 Fragen aus 2.000 Ereignissen, die am 11. Januar oder später eröffnet und vor dem 1. April 2026 abgerechnet wurden.
- Evaluation: 33.712 Fragen aus 8.765 Ereignissen, die ab dem 8. April 2026 eröffnet wurden.
Im Evaluationsdatensatz stammten 3.567 Fragen aus 113 Themenfamilien, die sowohl vom Training als auch von der Kalibrierung ausgeschlossen waren. Das Unternehmen entfernte nahezu doppelte Eingaben, Regeländerungen nach Marktöffnung sowie nachträglich hinzugefügte Gewinneroptionen, die Ergebnisse verraten könnten.
Das Training nutzte die Fireworks Training API mit K-way-Kreuzentropie-Verlust, der nur die Antwortoptionen der jeweiligen Frage berücksichtigt. Fireworks trainierte einen LoRA-Adapter per SFT in einem Durchlauf durch die Daten.
Genauigkeit, Kalibrierung und Backtest
Auf dem gesamten Testdatensatz erreichte das angepasste Glimmer eine Genauigkeit von 64,8 Prozent, verglichen mit 56,4 Prozent beim Basis-Glimmer und 45,9 Prozent bei Jev. Bei unbekannten Themen kam es auf 58,3 Prozent und lag damit vor dem Basis-Glimmer mit 53,2 Prozent und Jev mit 47,1 Prozent.
Anschließend kalibrierte Fireworks die Konfidenz des angepassten Modells mit einer eigenen Temperatur je Fragetyp, ermittelt auf dem zurückgehaltenen Kalibrierungsdatensatz, ohne die Gewichte neu zu trainieren. Nur das angepasste Glimmer durchlief diesen Schritt. Wenn es einer Antwort eine Wahrscheinlichkeit von mindestens 80 Prozent gab, lag es in 86,8 Prozent der Fälle richtig. Diese selbstsicheren Prognosen deckten 14,4 Prozent der Fragen im gesamten Test und 6,1 Prozent der Fragen zu unbekannten Themen ab. Fireworks weist darauf hin, dass viele davon „Nein“-Antworten auf verwandte Schwellenfragen waren, die Treffer also nicht unabhängig voneinander waren.
In einem hypothetischen Backtest erhielt jedes Modell 1.000 US-Dollar, die auf Wetten verteilt werden sollten, deren Preis plus modellierte Gebühren mindestens 5 Cent unter der Schätzung des Modells lag. Das angepasste Glimmer endete bei 1.071 Dollar (+7,1 Prozent), das Basis-Glimmer bei 950 Dollar und Jev bei 919 Dollar. Das 90-Prozent-Event-Bootstrap-Intervall reichte von +1,6 bis +12,4 Prozent. Allein bei unbekannten Themen brachte eine separate Allokation 15,2 Prozent, mit einem Intervall von −2,9 bis +33,5 Prozent, das auch Verluste einschloss.
Das Unternehmen nennt Einschränkungen: Der Backtest verteilte ein festes Budget auf sich überschneidende historische Wetten, erlaubte Bruchteile von Kontrakten und modellierte weder Liquidität noch Slippage oder historische Gebührenänderungen. Ob das Ergebnis mit echtem Geld Bestand hat, sei laut Fireworks weiterhin offen.
System-One-Serving und was das bedeutet
Weil die Aufgabe Wahrscheinlichkeiten über eine feste Menge an Antworten erfordert, nutzte Fireworks seine System One API. Sie liest Optionswahrscheinlichkeiten direkt aus, ohne Text zu generieren, und bündelt mehrere Fragen zu einem gemeinsamen Kontext in einer Anfrage. In einem separaten synthetischen Benchmark lieferte sie eine 2- bis 3-mal schnellere mediane Server-Verarbeitung als Standard-Chat-Completions in BF16, mit demselben Adapter und einer einzelnen B200-GPU. Bei 16 bis 32 Fragen pro Anfrage schaffte sie bis zu 3,6-mal mehr Entscheidungen pro Sekunde. Fireworks betont, dass sich Präzision und Laufzeit unterschieden, die Zahlen also komplette Serving-Stacks vergleichen, und dass dieser Benchmark getrennt vom Vergleich mit Jev zu sehen ist.
Für Entwickler ist das Angebot bis zum 30. November eine kostengünstige Möglichkeit, aufgabenspezifisches Fine-Tuning auf einem multimodalen 30B-Modell zu testen, mit einem durchgespielten Beispiel und Serving-Anleitung über /inference/v1/systemone. Die Ergebnisse stammen aus eigenen Tests des Unternehmens und einem hypothetischen Backtest. Sie sind daher eher vielversprechend als ein Beleg für Handelsgewinne.
Fireworks AI: Training Muse Glimmer for free to out-bet Jev