Googles A2UI erhält austauschbare Inferenzformate, um die Latenz bei generativen Oberflächen zu senken
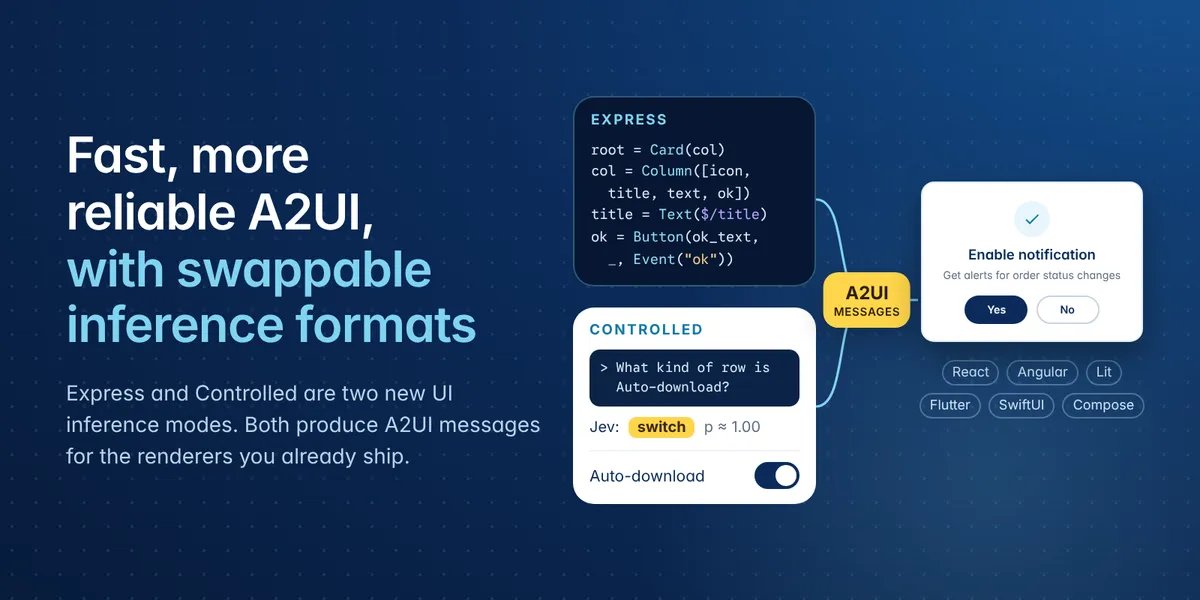
Google hat A2UI, sein Protokoll für generative Benutzeroberflächen, um austauschbare Inferenzformate erweitert und ein neues Format namens A2UI Express zum Standard gemacht. Laut Google kann Express die Latenz im Vergleich zur direkten Erzeugung von JSON um bis zu das Dreifache senken. Kombiniert man A2UI mit Entscheidungsmodellen wie Jev, sind demnach bis zu 80-fache Verbesserungen möglich.
- Googles A2UI unterstützt jetzt austauschbare Inferenzformate, die beim Erstellen des Generators mit einem Argument festgelegt werden.
- A2UI Express ist das neue Standardformat und senkt laut Google die Latenz um bis zu das Dreifache und braucht bis zu dreimal weniger Token als Direct JSON.
- Entscheidungsmodelle wie Jev von TypeSafe können die Beschleunigung bei Bildschirmen mit bekanntem Layout auf bis zu das 80-Fache steigern.
- Express ist in den Agent SDKs für Python, TypeScript und Dart verfügbar.
- Google hat vier Formate in einer Evaluation mit 51 Aufgaben auf gemini-3.5-flash getestet und sagt, Express funktioniere auch ohne Thinking gleich gut.
Warum Google die Bildschirmerzeugung von A2UI-Agenten umgebaut hat
A2UI ist ein Protokoll, bei dem ein Client einen Katalog vertrauenswürdiger Komponenten bekannt gibt, ein Agent Nachrichten sendet, die eine aus diesem Katalog aufgebaute individuelle Oberfläche beschreiben, und der Renderer des Clients sie darstellt. Dem A2UI-Team von Google zufolge hatten Entwickler Bedenken wegen der Geschwindigkeit geäußert, da Nutzer warten müssen, während das Modell jeden Bildschirm erzeugt.
Das Team sieht im ursprünglichen Ansatz einen Teil des Problems. Agenten erzeugten anfangs A2UI-JSON-Transportnachrichten direkt, und das Generieren von JSON-Bäumen unter den Vorgaben eines komplexen Schemas erwies sich für LLMs als langsam und fehleranfällig. Zudem band es A2UI an Modelle, die Text ausgeben, was die Integration schnellerer Entscheidungsmodelle erschwerte, die Google als System-One-Modelle bezeichnet.
Die neue Version trennt, was das Modell schreibt, von dem, was über die Leitung geht. Agenten können jetzt ein Zwischenformat erzeugen, und deterministischer Code in den A2UI Agent SDKs übersetzt es in das JSON-basierte Transportprotokoll. Für Sonderfälle können Entwickler auch eine andere DSL samt Compiler einbinden.
So funktionieren austauschbare Formate und A2UI Express
Das Format, das ein Modell erzeugt, heißt inference_format und wird beim Erstellen des Generators mit einem einzigen Argument festgelegt. Laut Google besteht jedes Format aus zwei Teilen, die beide das SDK aus dem JSON-Schema des Katalogs erzeugt: ein Prompt-Abschnitt, der dem Modell die Syntax beibringt, und ein Compiler, der die Antwort in validierte A2UI-Nachrichten umwandelt. Da beide aus dem Schema abgeleitet werden, kann ein Format keine Komponente und keine Eigenschaft beschreiben, die der Katalog nicht enthält.
A2UI Express schreibt pro Zeile eine Anweisung, in einem Stil, der Python nahekommt. Jede Zeile weist einer Variablen eine Komponente zu, und der Variablenname wird zur Komponenten-ID. Die Argumente sind positionsbasiert und werden in der Reihenfolge, die das Katalogschema vorgibt, den Eigenschaftsnamen zugeordnet. Google zufolge braucht Express für dieselben Arten von Oberflächen bis zu dreimal weniger Token als Direct JSON.
Google hat vier Formate getestet: Direct JSON, Express, Atom (Lisp-artige S-Ausdrücke) und Elemental (HTML mit benutzerdefinierten Elementen). Alle vier durchliefen dieselbe Evaluation mit 51 Aufgaben auf gemini-3.5-flash, jeweils mit und ohne Thinking-Modus. Google berichtet, dass Express auch ohne Thinking genauso gut funktioniert, was die schnellsten Inferenzzeiten ermöglicht.
Express ist im Python-Agent-SDK (a2ui-agent-sdk 0.9.0 auf PyPI), im TypeScript-Agent-SDK (@a2ui/agent auf npm) und im Dart-SDK (a2ui_agent 0.0.1-wip004 auf pub.dev) verfügbar. Die Python- und TypeScript-SDKs können Direct JSON Chunk für Chunk streamen, kompilieren Express aber aus der vollständigen Antwort. Im Python-SDK funktionieren Formate auch mit Makros: Das Modell schreibt einen Aufruf wie OrderStatus("ord_42"), und das Makro des Entwicklers ruft die Bestellung ab und füllt die Werte aus vorhandenen Daten.
Entscheidungsmodelle für Bildschirme mit bekannter Struktur
Für Bildschirme wie Einstellungsseiten, Kassenvorgänge oder Bestätigungen muss das Modell Google zufolge kein Layout entwerfen, sondern nur aus vorab definierten Layouts auswählen. Der Beitrag verweist dafür auf Jev von TypeSafe, ein System-One-Modell, das weder Text noch JSON erzeugt. Entwickler schicken ihm einen Zustand und eine Reihe typisierter Fragen, und es beantwortet jede mit kalibrierten Wahrscheinlichkeiten. Zu den Fragetypen gehören, ob eine Aussage zutrifft (Noul), welche Option passt (Choice) und wie etwas auf einer Bewertungsskala abschneidet (Score). Laut dem Beitrag beantwortet Jev viele Fragen in einer Anfrage in etwa 100 bis 300 ms.
Das Open-Source-Designtool Apparite (jev2ui) zeigt eine Möglichkeit, ein solches Modell mit A2UI zu verbinden. Jev entscheidet über die Struktur jedes Bildschirms, Code baut aus diesen Entscheidungen die A2UI-Komponenten, und gemini-3.5-flash-lite schreibt nur die Texte. Die Fragen stehen in einer vorab geschriebenen Markdown-Grammatik, in der ein Blockzitat eine Frage stellt und Aufzählungspunkte die Optionen samt Kriterien auflisten.
Apparite baut einen Bildschirm in mehreren Schritten auf. Eine Jev-Anfrage beantwortet die Layoutfragen der Grammatik, etwa 30 pro Bildschirm. Anschließend baut Code den Komponentenbaum aus dem Katalog und sendet nach etwa 200 ms createSurface und updateComponents, mit Platzhaltern für die späteren Texte. Danach streamt gemini-3.5-flash-lite den Text in updateDataModel, und kleine Folgeanfragen an Jev klären Details, die davon abhängen. Auf dem Einstellungsbildschirm einer Podcast-App stufte Jev „Skip forward“ als Wertzeile, „Auto-download“ als Schalter und „Log out“ als gefährliche Aktion ein, jeweils mit p ≈ 1,00.
Was das für Entwickler bedeutet
Google beschreibt die Veröffentlichung als eine Reihe von Stellschrauben, mit denen Teams für jeden Bildschirm den passenden Kompromiss wählen können. Offene Bildschirme können Express für schnellere und günstigere Erzeugung nutzen, während vorhersehbare Bildschirme auf ein Entscheidungsmodell setzen können, um die von Google genannten größten Beschleunigungen zu erreichen. Teams, die eine andere Syntax brauchen, können eine eigene DSL samt Compiler mitbringen, und die Agent SDKs sorgen für die Kompatibilität mit Transporten und Renderern.
Google for Developers: Fast, reliable A2UI, with swappable inference formats- Google Developers Blog