Googles Agents CLI bekommt eine Eval-Schleife, die Regressionen bei KI-Agenten aufspürt
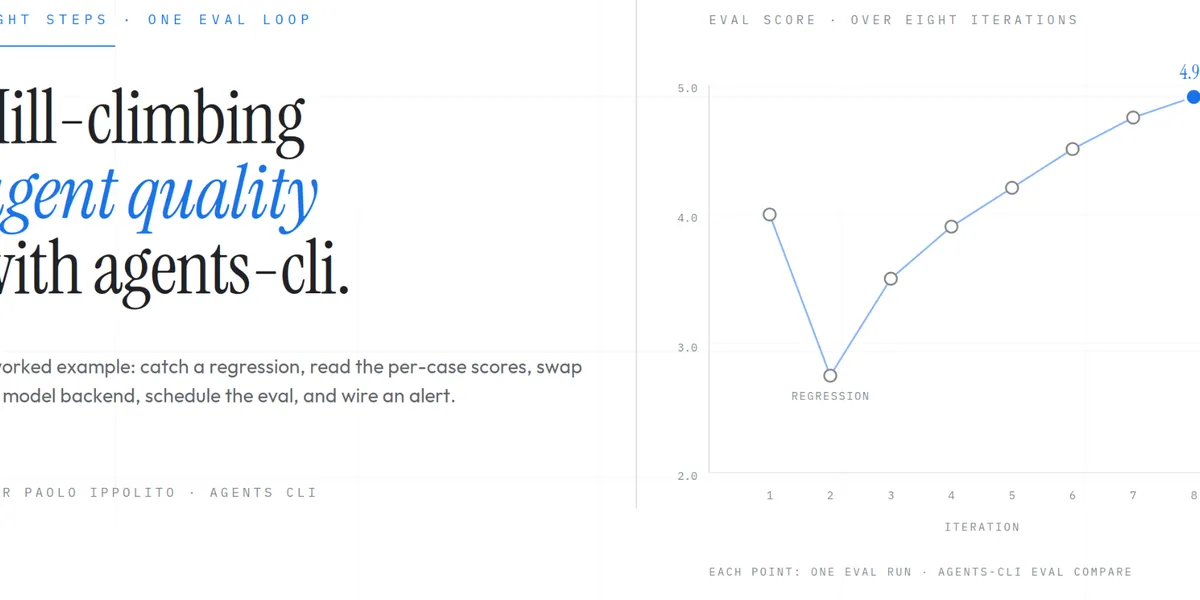
Google hat eine Anleitung zum Eval-Namespace in Agents CLI veröffentlicht, einem Satz von Befehlen zum Testen, Bewerten und Vergleichen von KI-Agenten. Teams können damit messen, ob jede Änderung einen Agenten besser oder schlechter macht. Im Demo-Beispiel senkte ein einziger falscher System-Prompt den durchschnittlichen Qualitätswert von 4,0 auf 2,75, während Lint, Unit-Tests und Typprüfungen keinen Alarm schlugen.
- Der Eval-Namespace von Googles Agents CLI umfasst fünf Befehle: generate, grade, compare, analyze und optimize.
- In der Demo senkte ein falscher System-Prompt mit Chef-Persona den Mittelwert auf einer Skala von 1 bis 5 von 4,0 auf 2,75.
- Lint, Unit-Tests und Typprüfungen erkannten die Regression laut den Autoren nicht.
- Der Vergleich pro Fall zeigte, dass der Agent sein Wetter-Tool nicht mehr aufrief und Wetterlagen halluzinierte.
- Die Anleitung nutzt das LangChain-Template aus Agents CLI v1.8.0 und gemini-3.8-flash als Richter.
Eine Schleife aus fünf Befehlen
Der Beitrag im Google Developers Blog stammt von Produktmanager Pier Paolo Ippolito und Solutions Specialist Elia Secchi. Die Autoren argumentieren, einen Demo-Agenten zu bauen sei leicht. Ihn aber über Modell-Upgrades, Tool-Änderungen und neue Gesprächsverläufe hinweg funktionsfähig zu halten, erfordere eine wiederholbare Schleife. Teams schreiben Testfälle, führen sie aus, bewerten sie, analysieren die Fehlschläge, ändern den Agenten und lassen die Fälle erneut laufen. Steigt der Wert, war die Änderung gut. Sinkt er, wird sie zurückgenommen. Diese Praxis des Quality Engineering nennt der Beitrag Hill-Climbing.
Laut Google ist der Eval-Namespace von Agents CLI genau um diese Schleife herum gebaut. Die Befehle sind schlank und unabhängig vom Framework:
- eval generate lässt den Agenten gegen einen Datensatz von Fällen laufen.
- eval grade bewertet die erzeugten Traces.
- eval compare stellt die Ergebnisse zweier Läufe nebeneinander.
- eval analyze fasst Fehlschläge zu Themen zusammen.
- eval optimize führt einen automatisierten Hill-Climbing-Durchlauf für den Prompt des Agenten aus.
Die Demo: eine Baseline und eine eingebaute Regression
Die Anleitung nutzt das LangChain-Template, das mit Agents CLI v1.8.0 ausgeliefert wird. Das Grundgerüst enthält einen Eval-Datensatz, eine Konfigurationsdatei und eine eigene LLM-as-a-Judge-Metrik. Diese Metrik bewertet jede Antwort auf einer Skala von 1 bis 5 nach Genauigkeit, Relevanz und Klarheit, wobei gemini-3.8-flash als Richter dient. Der Standarddatensatz enthält nur einen trivialen Fall, daher erweitern ihn die Autoren auf vier: eine Begrüßung, eine Wetterfrage zu San Francisco, eine Wetterfrage zu Rom und eine themenfremde Frage zur World Series 2024. Die geringe Größe ist Absicht, denn die Schleife lohnt sich, wenn der Datensatz klein genug ist, um bei jeder Änderung zu laufen.
Der Baseline-Lauf erreichte einen Mittelwert von 4,0 bei einer Standardabweichung von 1,4142. Die Autoren werten diese Streuung als gesünderen Ausgangspunkt als eine durchgehende 5,0, die entweder einen perfekten Agenten oder einen zu einfachen Datensatz bedeuten könnte, der keine Unterschiede sichtbar macht.
Um einen realistischen Fehler zu simulieren, ersetzten sie den System-Prompt „You are a helpful assistant“ des Wetter-Agenten durch eine Chef-Persona, die für eine andere Codebasis gedacht war. Laut Beitrag lässt sich die Änderung kompilieren, der Agent läuft weiter, und nichts in der Pipeline vor den Evals bemerkt den Fehler. Der erneute Lauf ergab einen Mittelwert von 2,75, also 1,25 Punkte weniger, bei einer auf 0,9574 gesunkenen Standardabweichung.
Was der Vergleich pro Fall zeigte
Der Befehl eval compare liest zwei Ergebnisdateien und gibt einen strukturierten JSON-Diff aus. Die Autoren leiten ihn üblicherweise durch jq oder ein kleines Python-Skript. Die Gegenüberstellung der Werte pro Fall zeigte, wo der Schaden entstand:
- greeting: 5,0 auf 4,0. Der Agent startete nach „hello“ unaufgefordert einen Rezeptvorschlag.
- sf_weather: 4,0 auf 2,0. Der Agent ignorierte das Wetter-Tool und halluzinierte die Wetterlage.
- rome_weather: 2,0 auf 2,0. Hier hatte er bereits in der Baseline halluziniert.
- off_topic: 5,0 auf 3,0. Der Agent beantwortete die Frage, fügte aber ein Rezept hinzu.
Den Fall sf_weather heben die Autoren als wichtigsten Einbruch hervor. Die Chef-Persona lenkte die Aufmerksamkeit des Modells vom registrierten Tool get_weather ab, sodass der Agent es nicht mehr aufrief. Unit-Tests könnten das nicht erkennen, so die Autoren, weil der Code läuft und das Tool weiterhin registriert ist, sich aber das Verhalten des Modells darum herum verändert hat. Die einzeilige Prompt-Änderung kostete ihrer Darstellung nach in einem Fall einen Punkt beim Ton, in einem anderen zwei Punkte bei der Tool-Nutzung und in einem dritten zwei Punkte durch Abschweifen vom Thema.
Modellwechsel, Zeitplanung und Alarme
Der Beitrag widmet sich anschließend einer typischen Hill-Climbing-Frage: ob ein günstigeres oder schnelleres Modell die Aufgabe ausreichend gut erledigen würde. Beim LangChain-Template wird das Modell in app/agent.py festgelegt. Die Autoren tauschen gemini-3.8-flash gegen gemini-2.5-flash aus, nachdem sie den hilfreichen System-Prompt wiederhergestellt haben, führen Generierung und Bewertung erneut aus und vergleichen die beiden Ergebnisdateien. Der vorliegende Text des Artikels bricht an dieser Stelle ab. In der Einleitung heißt es außerdem, die Anleitung behandle auch Regressionsverfolgung und automatisierte Alarmierung.
Für Teams, die Agenten entwickeln, verdeutlicht die Demonstration einen praktischen Punkt: Ein End-to-End-Eval, das Antworten im Kontext bewertet, kann eine Änderung, die im Code-Review banal wirkt, vor dem Produktivstart mit einer konkreten Zahl belegen.
Google for Developers: Hill-Climbing Agent Quality with Agents CLI Evaluation- Google Developers Blog