Google bringt Offline-Spracherkennung und Sprachsynthese in die AI Edge Gallery
Google integriert automatische Spracherkennung und Sprachsynthese direkt auf dem Gerät in die Google AI Edge Gallery. Entwickler können damit sprachgesteuerte KI-Erlebnisse erstellen, die lokal und offline funktionieren. Die Veröffentlichung kombiniert Googles Android-Sprachmodelle mit Modellen mit offenen Gewichten für plattformübergreifende Anwendungen.
- Die Google AI Edge Gallery unterstützt jetzt geräteinterne ASR und TTS.
- ML Kit unterstützt mehrsprachige Transkriptionen in mehr als 100 Sprachen.
- Googles Android-TTS-Modell beginnt nach ungefähr 100 ms mit der Sprachausgabe.
- XR Language Teacher kombiniert Kameraeingaben, lokale Modelle und zweisprachige Sprachausgabe.
- MediaPipe Tasks und LiteRT erweitern die Sprachunterstützung über Android hinaus.
Sprachmodelle für den lokalen Betrieb
Google zufolge ermöglichen kompakte Spracharchitekturen inzwischen mehrsprachige Spracherkennung und ausdrucksstarke Sprachsynthese vollständig auf Geräten, bei geringer Latenz und kleinem Speicherbedarf. In Kombination mit kleinen Sprachmodellen wie Gemini Nano und Gemma 4 können die Modelle Live-Transkriptionen und gesprochene Antworten ermöglichen, ohne Sprachdaten an einen Server zu senden.
Für Android stellt ML Kit systemintegrierte Sprachmodelle bereit, die laut Google mehr als 100 Sprachen mit 10-facher Echtzeitgeschwindigkeit transkribieren können. Das Text-to-Speech-Modell beginnt nach ungefähr 100 ms mit der Sprachausgabe, erzeugt Audio mit 24 kHz und kann mit bis zu 50-facher Echtzeitgeschwindigkeit arbeiten. Beide Modelle sind in das Betriebssystem integriert und erhöhen laut Google die Größe des APKs einer App um 0 MB.
Für das Web, Desktop-Systeme und andere Plattformen hebt Google Sprachpakete wie Parakeet-TDT 0.6B, PocketTTS 100M, Kokoro-82M und Phonon 31M hervor. Diese Modelle werden über MediaPipe Tasks und LiteRT unterstützt und sind für den gemeinsamen Betrieb mit kleinen Sprachmodellen auf dem Gerät ausgelegt.
XR Language Teacher demonstriert Offline-Sprach-KI
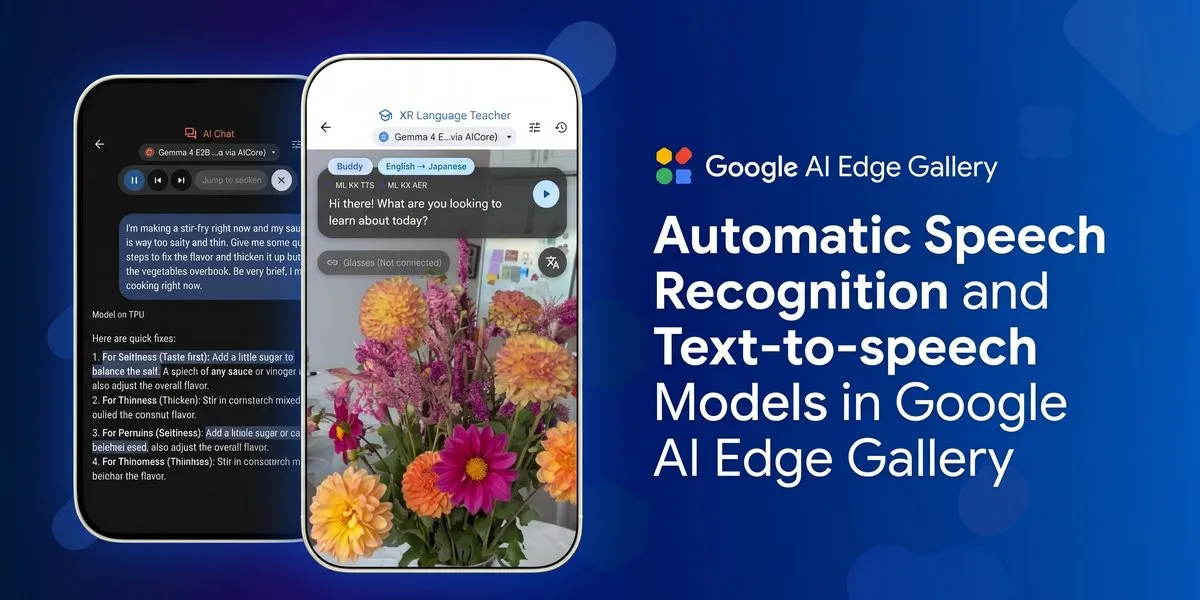
Googles Showcase XR Language Teacher kombiniert Kamera, Sprachmodelle und Sprachwerkzeuge in einem einzigen lokalen Erlebnis. Nutzer können die Kamera ihres Smartphones auf einen unbekannten Gegenstand oder ein Menü richten und laut eine Frage stellen. Die Anwendung erklärt die Szene anschließend in der Sprache des Nutzers und liefert die Aussprache in der jeweiligen Landessprache, ohne eine Netzwerkverbindung zu benötigen.
Unter Android übermittelt die geräteinterne Spracherkennung die gesprochene Frage zusammen mit dem Kamerabild per Streaming an Gemini Nano. Auf anderen Plattformen verwendet das Showcase Gemma 4. Strukturierte Ausgaben trennen fremdsprachige Ausdrücke vom restlichen Antworttext. Dadurch kann die Sprachsynthese mitten im Satz zwischen Stimmen und Akzenten wechseln. Laut Google lässt sich dasselbe Erlebnis auch für intelligente Brillen anpassen, wenn die Inferenz auf einem gekoppelten Smartphone läuft.
Auch AI Chat erhält Sprachsteuerung
Google hat die zentrale AI-Chat-Funktion in der Google AI Edge Gallery um Spracherkennung und Sprachsynthese erweitert. Nutzer können in der Modellverwaltung Sprachpipelines, voreingestellte Stimmen und heruntergeladene Sprachpakete auswählen. AI Chat unterstützt das Diktieren per Streaming sowie die Sprachausgabe von Antworten, einschließlich einer automatischen Wiedergabe oder einer Lautsprechersteuerung für einzelne Antworten.
Eine schwebende Text-to-Speech-Leiste hebt jeden gesprochenen Satz hervor und ermöglicht den direkten Sprung zu einem ausgewählten Satz. Die Open-Source-Referenzimplementierung von Google entfernt Markdown-Syntax, überspringt nicht gesprochene Bereiche wie Code und Tabellen und plant die Synthese auf Satzebene. So sollen Rechenleistung und Speicher weniger stark beansprucht werden, während das Sprachmodell Tokens erzeugt.
Für Entwickler bietet ML Kit Android-APIs, die über AICore und Googles geräteinterne Sprachdienste verwaltet werden. MediaPipe Tasks stellt einheitliche Schnittstellen für iOS, macOS, Windows, Linux und das Web bereit, während LiteRT eine direktere Kontrolle über die Sprachverarbeitung und benutzerdefinierte Modellarchitekturen ermöglicht. Die Veröffentlichung bietet Entwicklern eine lokale Sprachpipeline für Smartphones, Browser, Desktop-Systeme und tragbare Geräte. Als zentrale Vorteile stehen dabei der Offline-Betrieb und eine geringere Latenz im Mittelpunkt.
Google for Developers: On-Device Speech Recognition and Text-to-Speech in Google AI Edge Gallery- Google Developers Blog