Google erläutert Streaming DiLoCo für das LLM-Training über mehrere Rechenzentren
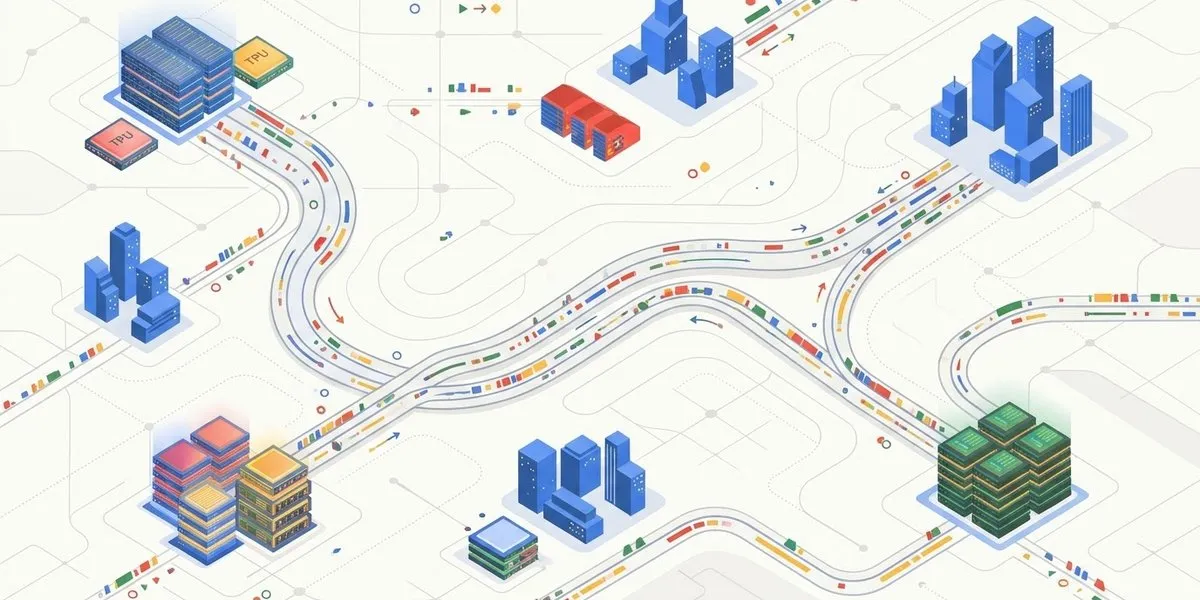
Google hat Streaming DiLoCo näher vorgestellt. Der Ansatz ist in das Open-Source-Framework MaxText integriert und soll das Training großer Sprachmodelle über geografisch verteilte Rechenkapazitäten ermöglichen. Statt das gesamte Modell auf einmal über langsamere Netzwerkverbindungen zu übertragen, verteilt die Methode die Modellsynchronisierung auf mehrere Trainingsschritte.
- Streaming DiLoCo ist in Googles Open-Source-Framework MaxText integriert.
- Die Methode synchronisiert Modellfragmente über mehrere Schritte, statt das gesamte Modell auf einmal zu übertragen.
- Googles Qwen3-32B-Beispiel verwendet 65 Fragmente und 65 lokale Schritte.
- Im Benchmark sank der Datenverkehr zwischen den Slices über 65 Schritte von 4,258.8 GB auf 67.0 GB.
- Die Tests verwendeten 2× TPU v5p-32-Slices sowie Begrenzungen auf 10 Gbit/s und 30 Gbit/s.
Ein anderer Ansatz für verteiltes Training
Das Training hochmoderner großer Sprachmodelle basiert traditionell auf einem einzigen, eng gekoppelten Beschleuniger-Cluster. Google zufolge erschweren physische und kostenseitige Einschränkungen die weitere Skalierung eines einzelnen Clusters zunehmend. Werden Rechenkapazitäten über mehrere Rechenzentren verbunden, entsteht ein anderes Problem: Weitverkehrsnetze haben eine höhere Latenz und eine geringere Bandbreite als lokale Verbindungen.
Beim standardmäßigen datenparallelen Training werden die Gradienten in jedem Schritt zwischen den Geräten synchronisiert. Findet diese Synchronisierung über ein ausgelastetes oder geografisch verteiltes Netzwerk statt, kann die Berechnung ins Stocken geraten, während das System auf die Kommunikation wartet. DiLoCo, kurz für Distributed Low-Communication, begegnet diesem Problem, indem das Training auf unabhängige Rechengruppen, sogenannte Learner, verteilt wird.
Jeder Learner führt H lokale Optimierungsschritte aus, bevor die Gruppen kommunizieren. Am Ende dieses Intervalls berechnen die Learner die Änderungen ihrer Gewichte, mitteln diese Änderungen über eine verteilte All-Reduce-Operation und wenden einen äußeren Optimierer an. Laut Google sinkt dadurch die Kommunikationshäufigkeit um den Faktor H, während Konvergenz und Modellqualität vergleichbar bleiben.
Streaming-Synchronisierung vermeidet Netzwerkspitzen
Vanilla DiLoCo reduziert zwar die gesamte Kommunikationsmenge, überträgt aber weiterhin alle Gewichtsänderungen des Modells alle H Schritte auf einmal. Laut Google kann dies bei einer begrenzten Netzwerkverbindung zu einem großen, regelmäßigen Stillstand führen.
Streaming DiLoCo begegnet diesem Problem, indem das Modell in P Fragmente aufgeteilt wird. In MaxText bestehen die Fragmente aus einer Gruppe für nicht gescannte Parameter und jeweils einer Gruppe für jede gescannte Transformer-Decoder-Schicht. Statt das gesamte Modell am Ende eines Intervalls auszutauschen, synchronisiert das System jeweils ein Fragment. Der Zeitpunkt wird durch Δh=max(1,round(H/P)) bestimmt.
Wenn H=P gilt, wird in jedem Schritt ein Fragment synchronisiert. Die gesamte Kommunikation über das Intervall bleibt damit genauso groß wie bei Vanilla DiLoCo, der Datenverkehr wird jedoch gleichmäßiger verteilt. MaxText verschachtelt außerdem Fragmente aus unterschiedlichen Tiefen des Netzwerks, sodass sich die Synchronisierung nicht auf benachbarte Schichten konzentriert, während ein anderer Modellbereich unverändert bleibt.
Für Embeddings beschreibt Google eine weitere Anpassung. Das Fragment mit Token-Embeddings, der Pre-Logits-Layer-Norm und dem Output-Head kann deutlich größer sein, da seine Größe von den Dimensionen des Vokabulars abhängt. Große Matrizen aus diesem Fragment werden daher aufgeteilt und mit Fragmenten anderer Schichten zusammengeführt, um Verkehrsspitzen zu reduzieren.
Beispiel mit Qwen3-32B und TPU-Slices
Googles Beispiel verwendet Qwen3-32B in bfloat16, mit einer Schrittzeit von ungefähr 6.2 Sekunden und P=H=65. Bei standardmäßigem datenparallelem Training werden in jedem Schritt etwa 65.5 GB an Gradienten übertragen. Um diese Datenübertragung innerhalb von ungefähr sechs Sekunden abzuschließen, sind laut der Berechnung des Unternehmens mindestens etwa 85 Gbit/s an dauerhaft verfügbarer Bandbreite zwischen den Slices erforderlich.
Über eine begrenzte Verbindung mit 10 Gbit/s würde dieselbe Übertragung laut Google mehr als 50 Sekunden dauern. Vanilla DiLoCo überträgt die gesamte Datenmenge in jedem 65. Schritt und reduziert den Gesamtdatenverkehr um den Faktor 65x, kann bei dieser Übertragung aber weiterhin ins Stocken geraten. Streaming DiLoCo überträgt ungefähr 1.0 GB pro Schritt, also ein 65stel des Modells, und hält dabei über 65 Schritte denselben Gesamtdatenverkehr aufrecht. Nach Googles Berechnung sind dafür etwa 1.3 Gbit/s Bandbreite erforderlich.
In einem Benchmark trainierten die Teams Qwen3-32B über 2× TPU v5p-32-Slices hinweg und verwendeten 64 Decoderschichten sowie 65 Fragmente. Sie testeten sowohl ungedrosselten Datenverkehr als auch eine aggregierte Bandbreite zwischen den Slices, die auf 30 Gbit/s beziehungsweise 10 Gbit/s begrenzt war. Google berichtet, dass Streaming DiLoCo den Datenverkehr zwischen den Slices über 65 Schritte von 4,258.8 GB bei der datenparallelen Referenz auf 67.0 GB senkte. Das entspricht einer Reduktion um das 64- bis 65-Fache.
Für Nutzer von MaxText und Teams, die ein verteiltes LLM-Training planen, beschreibt die Arbeit eine Möglichkeit, geografisch getrennte Rechenkapazitäten zu nutzen und gleichzeitig durch schmale Verbindungen verursachte Synchronisierungsstillstände zu begrenzen. Die von Google präsentierten Ergebnisse sprechen dafür, dass Streaming DiLoCo Training über mehrere Slices mit geringerer Bandbreite praktischer machen kann.
Google for Developers: Distributed LLM Training Across Metros: Streaming DiLoCo in MaxText- Google Developers Blog