GPT-6 Astra führte bei Coding-Agenten, erledigte aber nur 26,4 % der Aufgaben
OpenAIs GPT-6 Astra erfüllte in einem Benchmark für Coding-Agenten durchschnittlich 69,9 % der versteckten Abnahmekriterien, erledigte aber nur 26,4 % der Aufgaben vollständig. Die Studie Co-Design Bench legt nahe, dass von Agenten erzeugter Code in einem Pull Request vollständig wirken kann, obwohl weiterhin Anforderungen aus dem ursprünglichen Ticket fehlen.
- GPT-6 Astra erfüllte durchschnittlich 69,9 % der versteckten Kriterien.
- Es erledigte 26,4 % der 273 Benchmark-Aufgaben vollständig.
- Opus 5 erledigte 18,3 % der Aufgaben vollständig.
- Der Benchmark verwendete 2.331 versteckte Abnahmekriterien.
- Laut Qodo sollten Reviews Pull Requests mit den zugehörigen Tickets vergleichen.
Eine hohe Erfüllungsquote verdeckte unvollständige Aufgaben
Co-Design Bench wurde am 26. Oktober 2026 von Forschern bei Alibaba und fünf Universitäten veröffentlicht. Getestet wurden zehn Coding-Agenten mit 273 Aufgaben, die aus 37.463 deduplizierten Anfragen aus 26.314 realen Coding-Sitzungen von Nutzern stammten.
Die Aufgaben verlangten von den Agenten, funktionierende Webanwendungen zu überarbeiten, teilweise unter Verwendung eines angehängten Bildes, Audioclips, Videos oder Dokuments. Die Forscher erstellten 2.331 versteckte, von Experten formulierte Abnahmekriterien. Die Agenten erhielten die Anfrage des Nutzers und eine ausführbare Anwendung, nicht aber die Kriterien.
Nachdem jeder Agent seine Arbeit abgeschlossen hatte, bauten die Prüfer die Anwendung und führten sie in einem Browser aus. Anschließend bewerteten sie jedes Kriterium als „Erfüllt“, „Teilweise erfüllt“ oder „Nicht erfüllt“. Eine Aufgabe galt nur dann als vollständig erledigt, wenn jedes Kriterium erfüllt war. GPT-6 Astra belegte den ersten Platz: Pro Aufgabe erfüllte es durchschnittlich 69,9 % der Kriterien und schloss 26,4 % der Aufgaben vollständig ab. Opus 5 erfüllte 66,1 % der Kriterien und erledigte 18,3 % der Aufgaben vollständig, während Qwen3.8-Max auf 65,3 % beziehungsweise 16,5 % kam.
Der Benchmark konzentrierte sich auf schwierige, realistische Anfragen
Die Forscher wählten Anfragen anhand von Signalen für Schwierigkeit, Überprüfbarkeit und frühere Fehlschläge aus, darunter Neuformulierungen und Rollbacks. Der Benchmark sollte daher anspruchsvolle Arbeit statt routinemäßiger Coding-Prompts testen. Die Aufgaben betrafen Webanwendungen, nicht Backend-Dienste, und bestanden jeweils aus einer einzelnen, feststehenden Anfrage ohne Rückfragen.
GPT-6 Astra erledigte 41,0 % von 100 multimodalen Bearbeitungsaufgaben und 17,9 % von 173 Repository-Bearbeitungsaufgaben vollständig. Über alle zehn Modelle hinweg erfüllten Repository-Änderungen mit drei oder vier Änderungstypen 59,1 % der Kriterien, verglichen mit 65,4 % bei Änderungen mit einem oder zwei Typen. Von den 173 Repository-Aufgaben erforderten 166 mehr als einen Änderungstyp.
Die Ergebnisse hingen außerdem vom Software-Harness ab, mit dem die Agenten ausgeführt wurden. Jedes Modell wurde im Claude-Code-Harness getestet. Ein Wechsel des Harnesses veränderte Qwen3.8-27B’s Ergebnis bei Repository-Bearbeitungen jedoch von 56,0 % auf 74,9 %. Die Forscher verwendeten einen LLM-Prüfer, einen separaten LLM-Verifizierer, der positive Bewertungen infrage stellte, sowie zwei Experten, die 200 Ergebnisse kontrollierten.
Warum die Prüfung nur des Diffs das Problem übersehen kann
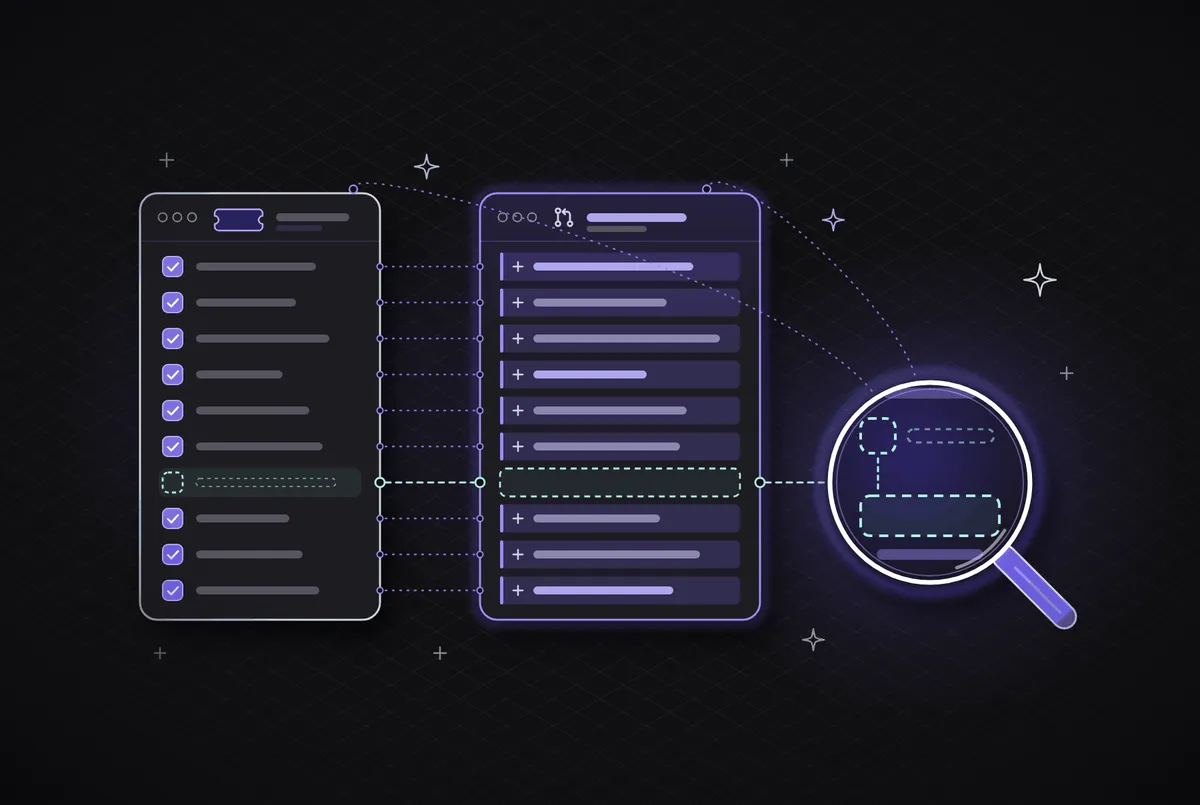
Die Analyse von Qodo lautet, dass ein Agent den Großteil einer Aufgabe erledigen und trotzdem eine wichtige Anforderung unberücksichtigt lassen kann. Eine Änderung, die neun von zehn Kriterien erfüllt, kann in einem Pull Request vollständig wirken, weil die fehlende zehnte Anforderung keine fehlerhafte Codezeile erzeugt, die ein Prüfer untersuchen könnte. Qodo nennt als Beispiel einen Rabatt, der nie die Bestellübersicht erreicht: Der erforderliche Code fehlt, statt sichtbar fehlerhaft zu sein.
Das Paper zu Co-Design Bench beschreibt dieses Muster mit den Worten: „Eine weitgehende Abdeckung einzelner Anforderungen kann mit einem begrenzten Erfolg bei vollständig erledigten Aufgaben einhergehen.“ Laut Qodo misst der Benchmark Agenten und nicht Code-Reviews. Die Schlussfolgerung zum Review ist daher eine Ableitung von Qodo.
Qodo gibt an, Pull Requests mit den zugehörigen Tickets aus Systemen wie Jira, Linear, Azure DevOps, GitHub Issues, GitLab Issues und Monday.com abzugleichen. Der erklärte Ansatz besteht darin, den Code mit der Absicht des Tickets, den Abnahmekriterien und den Teilaufgaben zu vergleichen und fehlende oder unvollständige Anforderungen als Befunde im Pull Request zu melden. Dieser Ansatz setzt schriftlich festgehaltene Anforderungen voraus: Ein vages Ticket lässt Prüfern wenig, was sie überprüfen können.
Auch die Autoren des Benchmarks nennen Einschränkungen, darunter die schwierige Auswahl der Aufgaben und die Möglichkeit von Bewertungsfehlern. Sie schreiben, die aufbewahrten Belege könnten „Bewertungsfehler nicht ausschließen“. Ein früherer Test kam zu einem anderen Ergebnis: Das Paper berichtet, dass Opus 4.8 bei WebCompass-edit eine Feature-Vollständigkeit von 99,4 % erreichte, wenn es seinen eigenen Code ausführen und reparieren konnte. Zugleich weist es darauf hin, dass die beiden Benchmarks unterschiedliche Aufgabenpools und Bewertungsverfahren nutzten.