Hamed Karimi erhält Auszeichnung für ein einflussreiches Paper zur Machine-Learning-Theorie
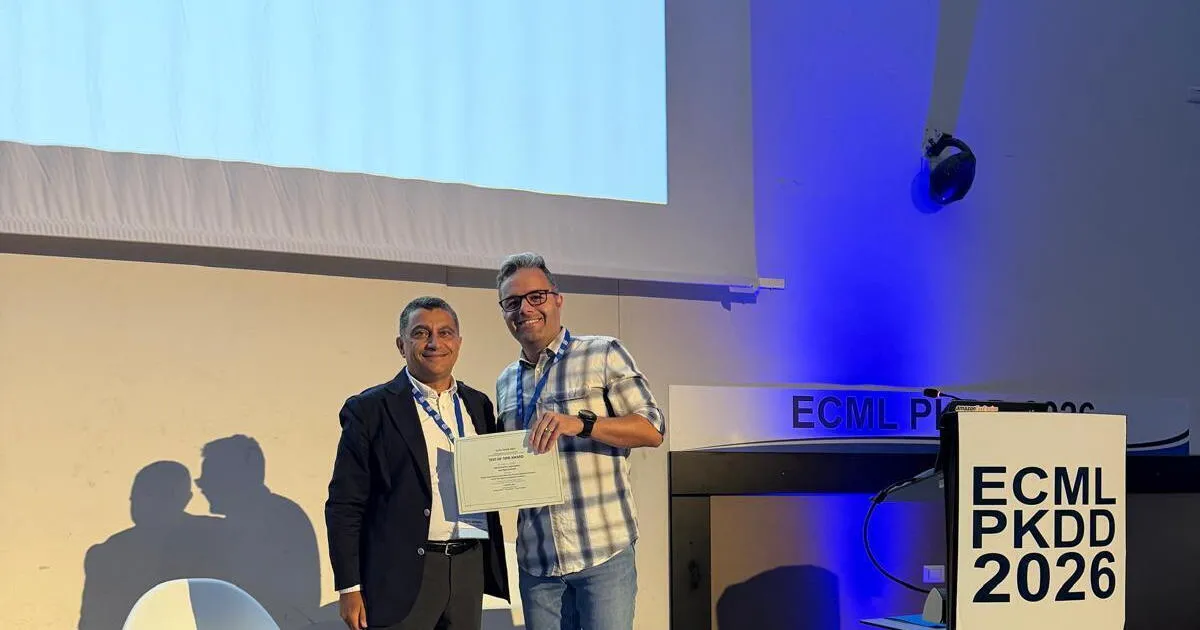
Der Senior Applied Scientist von Amazon, Hamed Karimi, und seine Koautoren haben den ECML-PKDD-Test-of-Time-Award 2026 für ein Paper erhalten, das erklärt, warum gängige Optimierungsmethoden im Machine Learning schnell konvergieren. Ihre Arbeit aus dem Jahr 2016 zeigte, dass die Polyak-Łojasiewicz-Bedingung lineare Konvergenz garantieren kann, ohne starke Konvexität vorauszusetzen.
- Hamed Karimi und seine Koautoren haben den ECML-PKDD-Test-of-Time-Award 2026 erhalten.
- Ihr Paper aus dem Jahr 2016 wurde mehr als 2.000-mal zitiert.
- Das Paper zeigte, dass die Polyak-Łojasiewicz-Bedingung lineare Konvergenz ohne starke Konvexität garantieren kann.
- Die Analyse umfasste Koordinatenabstieg, Vorzeichen-Gradientenabstieg und stochastischen Gradientenabstieg.
- Varianten der Bedingung werden im Reinforcement Learning, bei gekrümmten Parameterräumen und beim Sampling für Diffusionsmodelle eingesetzt.
Ein zehn Jahre altes Paper wird ausgezeichnet
Karimi erhielt die Auszeichnung in Neapel bei der European Conference on Machine Learning and Principles and Practice of Knowledge Discovery in Databases, kurz ECML PKDD. Der Preis würdigt Forschungsarbeiten, die ein Jahrzehnt zuvor veröffentlicht wurden und langfristig Wirkung entfaltet haben.
Das ausgezeichnete Paper Linear convergence of gradient and proximal-gradient methods under the Polyak, Łojasiewicz condition verfasste Karimi gemeinsam mit Julie Nutini und Mark Schmidt, als Karimi als Postdoktorand an der University of British Columbia tätig war. Laut Amazon Science wurde das Paper mehr als 2.000-mal zitiert und in Lehrbüchern für Graduierte aufgenommen.
„Als wir das Paper 2016 verfassten, hatten wir wirklich nicht erwartet, dass es für Aufsehen sorgen würde“, sagte Karimi. „Wir wussten nicht, dass das Ergebnis Teil der Methodik werden würde, mit der Forscher die Optimierung im Machine Learning analysieren.“
Warum Optimierung funktioniert
Machine-Learning-Modelle werden trainiert, indem ihre Parameter angepasst werden, um eine Verlustfunktion zu verringern. Diese misst den Unterschied zwischen den Modellausgaben und den gelabelten Trainingsdaten. Beim Gradientenabstieg und verwandten Verfahren werden die Parameter wiederholt in die Richtung angepasst, in der der Verlust sinkt.
Die mathematische Theorie garantierte traditionell eine schnelle, lineare Konvergenzrate für stark konvexe Funktionen. Amazon Science beschreibt diese Geometrie als steile Schüssel mit einem tiefsten Punkt. Moderne Machine-Learning-Probleme können stattdessen flache Talsohlen aufweisen, insbesondere wenn Trainingsdaten redundant sind und Modelle unverhältnismäßig mehr Parameter als Trainingsdaten besitzen.
Solche Probleme lassen sich mit dem Gradientenabstieg dennoch erfolgreich trainieren. Die frühere Theorie konnte jedoch nicht erklären, warum das funktioniert, oder angeben, wie schnell. Karimi und seine Koautoren zeigten, dass die Polyak-Łojasiewicz-Bedingung, eine 1963 unabhängig voneinander von Boris Polyak und Stanisław Łojasiewicz veröffentlichte Ungleichung, diese Garantie auch ohne stark konvexe Geometrie liefern kann. Der Beweis ist nur drei Zeilen lang.
Ein Rahmen für mehrere Trainingsverfahren
Das Paper ordnete zuvor getrennte Ansätze für Optimierungsprobleme mit schwächeren Bedingungen und zeigte, wie ihre Annahmen zusammenhängen. Es identifizierte die Polyak-Łojasiewicz-Bedingung als die schwächste bekannte Bedingung, die für die untersuchten Funktionen weiterhin eine lineare Rate garantiert.
Die Forscher führten außerdem eine Variante der Bedingung für Probleme ein, die glatte und nichtglatte Funktionen kombinieren. Anschließend wendeten sie die Analyse auf Koordinatenabstieg, Vorzeichen-Gradientenabstieg und stochastischen Gradientenabstieg an. In jedem Fall erhielten sie die zuvor nur für stark konvexe Funktionen bekannte Konvergenzrate.
Laut Amazon Science unterstützen Varianten dieses Ansatzes inzwischen Konvergenzergebnisse im Reinforcement Learning, bei der Optimierung über gekrümmte Parameterräume und bei den Sampling-Verfahren hinter Diffusionsmodellen. Das Ergebnis liefert Forschern eine kurze Vorlage für die Analyse neuer Trainingsverfahren und hilft dabei, die Leistung praktisch eingesetzter Algorithmen mit dem zu verbinden, was die mathematische Theorie beweisen kann.
Amazon Science: Hamed Karimi wins ECML PKDD Test-of-Time Award