Harvey baut MCP Policy Engine, die steuert, wie KI-Agenten Partner-Tools nutzen
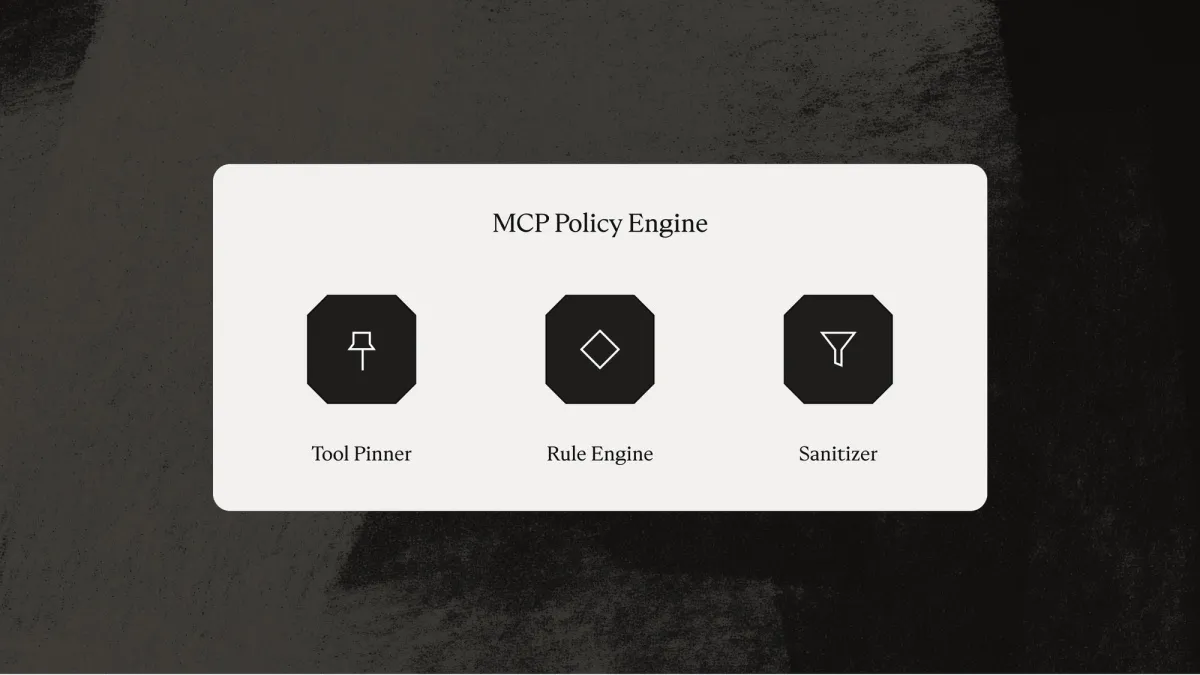
Harvey hat eine Model-Context-Protocol-(MCP-)Policy-Engine entwickelt, die regelt, wie die KI-Agenten des Unternehmens Partner-Tools nutzen, während ein Workflow läuft. Sie ergänzt die ersten Sicherheitsprüfungen der Konnektoren um Kontrollen zur Laufzeit. Das Unternehmen beschreibt das Design in einem technischen Blogbeitrag von Suha Sabi Hussain und Divya Sudhakar, der am 7. Oktober 2026 erschienen ist.
- Harvey hat eine MCP Policy Engine entwickelt, die steuert, wie seine Agenten MCP-Partner-Tools in Workflows nutzen.
- Sie richtet sich gegen Tool Poisoning und Rug-Pull-Angriffe, die über die „lethal trifecta“ Daten abfließen lassen können.
- Die Durchsetzung sitzt in der Orchestrierungsebene außerhalb des Modells und beruht auf Least Privilege, Complete Mediation und Secure Information Flow.
- Ein Tool Pinner erfasst freigegebene Tools und meldet Änderungen am Katalog, erzeugt derzeit aber viele Warnmeldungen.
- Harvey entwickelt feingranulares Pinning und semantische Klassifizierung von Änderungen, um Prüfungen zu priorisieren.
Warum Kontrollen zur Laufzeit nötig sind
Juristische Teams arbeiten mit Recheribeplattformen, Dokumentenmanagementsystemen und Kommunikationswerkzeugen. Laut Harvey geben die Agenten durch die Anbindung an diese Systeme mehr Kontext, es entsteht aber auch eine Sicherheitsherausforderung: Tools können sich nach der ersten Prüfung verändern, schädliche Anweisungen zurückgeben oder so ausgenutzt werden, dass sensible Informationen offengelegt werden.
Harvey hat die Engine beim Umbau seiner Connector Library entwickelt. Das Unternehmen erklärt, Prompt Injection bleibe ein ungelöstes Problem der KI-Sicherheit, weshalb es mehrere architektonische Kontrollen einsetzt, um Wahrscheinlichkeit und Auswirkungen von Missbrauch zu verringern. Als Inspiration für das Design nennt es die Forschungsarbeiten Sondera, Progent, ETDI und CaMeL. Diese untersuchen, wie sich Richtlinien außerhalb des Modells durchsetzen, Tool-Berechtigungen begrenzen und Informationsflüsse steuern lassen.
Harvey nennt vier Überlegungen hinter seinem Ansatz:
- Macht der Server: MCP-Server können, sofern unterstützt, Clients auffordern, Modelle aufzurufen oder Informationen von Nutzern einzuholen. Deshalb braucht es Grenzen für das, was Server anfordern dürfen.
- Sich verstärkende Risiken: Harvey verweist auf die „lethal trifecta“ aus Zugriff auf private Daten, Kontakt mit nicht vertrauenswürdigen Inhalten und externer Kommunikation, die über Prompt Injection zu Datenabfluss führen kann.
- Abhängigkeit von der Umsetzung: Harvey zitiert die NSA, die die Sicherheitslage von MCP als „uneinheitlich und stark von der Disziplin bei der Umsetzung statt von Protokollgarantien abhängig“ beschreibt.
- Sich entwickelndes Protokoll: Neue Spezifikationen können Lücken schließen, bringen aber zugleich Funktionen mit neuartigen Risiken.
Die Engine zielt auf zwei hartnäckige Bedrohungen. Beim Tool Poisoning lenken schädliche Anweisungen in der Definition eines Tools den Agenten um. Bei einem Rug-Pull-Angriff führt ein Server nach der Freigabe schädliche Änderungen ein.
Prüfung vor der Anbindung und Analyse der Tool-Argumente
Harvey beginnt nach eigenen Angaben mit einer gründlichen Prüfung jedes Partner-Servers und seiner Tools, bei der Authentifizierung, Funktionen, Berechtigungen und Datenverarbeitung untersucht werden. Das Unternehmen setzt bewährte MCP-Sicherheitspraktiken durch und beschränkt, wo möglich, OAuth-Scopes und den Tool-Zugriff nach dem Prinzip der geringsten Rechte. Neue Tools und Protokollfunktionen werden nicht automatisch aktiviert, nur weil ein Server sie anbietet; auch Ergänzungen werden geprüft.
Das Unternehmen argumentiert, dass eine Kennzeichnung als Lese- oder Schreibzugriff nicht alles beschreibt, was ein Tool tun kann. Ein reines Suchwerkzeug könnte dennoch vertrauliche Informationen preisgeben, wenn diese in eine Anfrage an einen externen Dienst eingebettet werden. Harvey bewertet deshalb zwei Eigenschaften der Argumente eines Tools:
- Kapazität: wie viele Informationen das Argument transportieren kann. Ein unbeschränktes Textfeld fasst mehr als ein Feld mit einer kleinen Auswahl an Werten, und wiederholte Aufrufe können die Kapazität erhöhen.
- Autorität: was das Argument steuert, etwa Inhalte, ein ausgewähltes Dokument oder einen Empfänger.
Mit diesen Eigenschaften kann Harvey Prompt Injection als Problem der Informationsflusskontrolle behandeln. Das Unternehmen hat außerdem ein internes Analysewerkzeug für MCP-Sicherheit entwickelt, das zum Zeitpunkt der Integration läuft. Es untersucht die Authentifizierungskonfiguration, die bereitgestellten Funktionen und JSON-Schemas und identifiziert Lücken zwischen den Garantien, die Harvey verlangt, dem, was ein Server in Schema und Dokumentation verspricht, und dem, was er tatsächlich durchsetzt.
Durchsetzung außerhalb des Modells
Maßnahmen wie Sicherheitstraining, Markierung von Inhalten und Klassifikatoren können das Risiko laut Harvey senken, sind aber umgehbar und genügen für sich allein nicht dem eigenen Sicherheitsanspruch. Das Unternehmen setzt deshalb vor allem auf architektonische Gegenmaßnahmen. Die Durchsetzung sitzt in der Orchestrierungsebene außerhalb des Modells, sodass Richtlinien vorgeschlagene Aktionen auch dann einschränken können, wenn das Modell einer schädlichen Anweisung folgt.
Drei Prinzipien leiten den Ansatz, angelehnt an „Systems Security Foundations for Agentic Computing“:
- Least Privilege: Die Fähigkeiten eines Agenten und die Bedingungen, unter denen er sie nutzen darf, werden beschränkt.
- Complete Mediation: Jeder Aufruf eines MCP-Partner-Tools wird vor der Ausführung geprüft. Die Freigabe zur Anbindung eines Servers autorisiert nicht jede spätere Aktion.
- Secure Information Flow: Der Workflow-Kontext wird genutzt, um Kombinationen von Fähigkeiten einzuschränken, die private Informationen offenlegen oder nicht vertrauenswürdige Inhalte folgenreiche Aktionen steuern lassen könnten.
Tool Pinner und die nächsten Schritte
Da MCP keine Versionierung einzelner Tool-Definitionen vorschreibt, kann sich ein Tool nach der Freigabe ändern. Harveys „Tool Pinner“ erfasst freigegebene Tools, einschließlich der für das Modell sichtbaren Beschreibungen und Eingabeschemas. Bei der Discovery vergleicht er den angebotenen Katalog jedes Konnektors mit dieser Baseline und meldet Ergänzungen, Entfernungen und Änderungen zur Prüfung durch das Security-Team.
Harvey räumt einen Zielkonflikt ein. Wer bei der ersten Nutzung fixiert und alle Updates ablehnt, wäre vor Rug-Pull-Angriffen geschützt, doch Konnektor-Kataloge ändern sich häufig, und der Pinner erzeugt derzeit eine erhebliche Zahl an Warnmeldungen. Das Unternehmen entwickelt ein feingranulares Pinning und eine semantische Klassifizierung von Änderungen, die Änderungen in Bestandteile zerlegt und deren richtlinienrelevantes Risiko bewertet. Zusammen mit Kontextinformationen und gezielter menschlicher Prüfung (Human in the Loop) soll das bestimmen, welche Version eines Tools ausgeliefert wird und wie die Engine damit umgeht. Harvey arbeitet außerdem daran, kumulative Änderungen zu untersuchen, um Salami-Slicing-Angriffe zu erkennen, bei denen eine Reihe kleiner Änderungen in der Summe eine folgenreiche Änderung ergibt.
Der Beitrag führt zudem aus, dass ein Tool-Aufruf je nach bisherigem Verlauf des Workflows unterschiedliche Risiken bergen kann, etwa nachdem ein Agent auf private Daten zugegriffen hat. Der vorliegende Quelltext endet bei der Einführung dieser kontextbasierten Bewertung.
Was das für Kunden bedeutet
Für Kanzleien und Unternehmen, die Harvey Agents mit angebundenen Systemen nutzen, zeigt der Beitrag: Die Freigabe eines Partner-Servers ist nur der erste Schritt. Jeder Tool-Aufruf wird vor der Ausführung geprüft, und Änderungen an freigegebenen Tools werden zur Prüfung gemeldet. Harvey macht transparent, dass Teile des Systems, darunter die Priorisierung der Warnmeldungen, noch verbessert werden.
Harvey: Building Harvey’s MCP Policy Engine