Harvey baut Review Tables um und lädt Tausende Dokumente seitenweise
Harvey hat neu gestaltet, wie seine Review Table lädt: Die Zeilen werden seitenweise vom Server abgerufen, statt die gesamte Tabelle in den Browser zu ziehen. Laut den Ingenieuren des Unternehmens laden Tabellen, die früher abstürzten, nun problemlos und schnell.
- Harvey hat Sortierung und Filterung der Review Table vom Browser auf den Server verlagert und lädt Zeilen seitenweise.
- Turbopuffer auf Basis von Azure Blobs dient als Lesespeicher, während Postgres die maßgebliche Datenquelle bleibt.
- Harvey entwickelte eine ID-basierte Paginierung, da Turbopuffer keine integrierte Paginierung bietet.
- Das Laden erfolgt in Phasen: Grundgerüst, Werte der Sortierspalte, dann Seiten mit Zeilen.
- Laut Harvey verbesserte sich die Latenz bei allen Tabellengrößen, und Tabellen, die früher abstürzten, laden nun.
Warum das Laden der kompletten Tabelle nicht mehr funktionierte
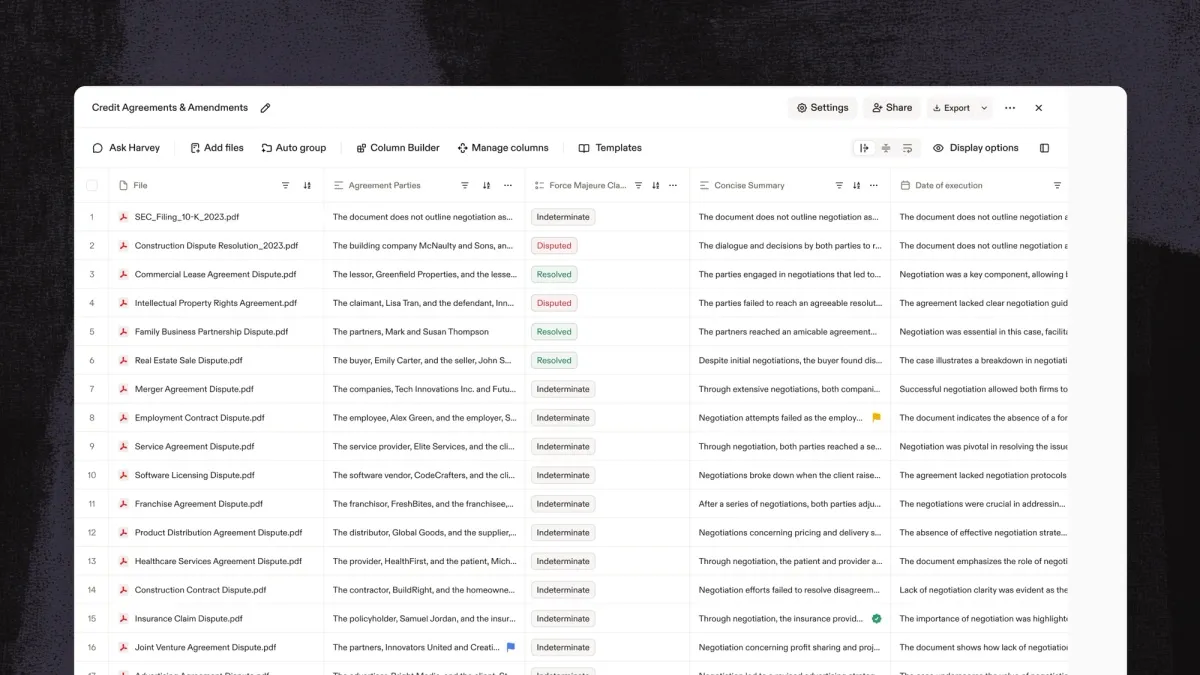
Die Review Table ist nach Harveys eigenen Worten die „größte, umfassendste Inferenz-Engine". Juristen laden Dokumente hoch, stellen Fragen in natürlicher Sprache und erhalten die Ergebnisse in einer strukturierten Tabelle. Die Zeilen entsprechen einzelnen Dokumenten, die Spalten den Fragen. Jede Zellantwort enthält die Begründung des Modells und wird durch Zitate aus dem Quelldokument belegt.
Die Tabelle soll zudem kollaborativ nutzbar sein. Zeilen lassen sich Kollegen zuweisen, Antworten können verifiziert oder gesperrt werden, und Nutzer können Kommentare hinterlassen. Einmal verifiziert, kann eine Tabelle als wiederverwendbare Wahrheitsquelle für ein späteres Memo oder eine Präsentation dienen.
Dieser Workflow setzt voraus, dass die Tabelle reaktionsschnell bleibt. Bisher lud der Browser die gesamte Review Table aus dem Blob Store und führte Sortierung, Filterung und Aggregation komplett im Arbeitsspeicher aus. Bei kleinen Tabellen funktionierte das, doch sobald eine Tabelle mehrere Tausend Zeilen überschritt, traten Probleme auf. Als Teams begannen, Hunderte Spalten über Tausende Dateien abzufragen, geriet die Tabelle nach Angaben der Ingenieure teils ins Stocken oder reagierte nicht mehr. In den größten Fällen ging dem Browser der Speicher aus, oder die Tabelle ließ sich gar nicht laden.
Zwei Hindernisse für eine einfache serverseitige Paginierung
Serverseitige Paginierung wirkt wie die naheliegende Lösung, doch Harvey nennt zwei Dinge, die im Weg standen.
- Trennung sensibler Daten. In Postgres liegen nur Metadaten, die eigentlichen Kundendaten befinden sich in Azure Blobs. Daten müssen daher zum Zeitpunkt der Anfrage aus Azure abgerufen, mit den Postgres-Daten zusammengeführt und an den Client übergeben werden. Um Paginierung mit Filterung und Sortierung zu unterstützen, brauchte es eine Abfrageschnittstelle auf dem Azure Blob Store.
- Keine geeignete Grid-Bibliothek. Laut Harvey unterstützt keine bestehende Grid-Bibliothek das benötigte Paginierungsschema. Das Team entwickelte daher eigene Abstraktionen für das Laden von Seiten, darunter Gruppierung nach Ordnerpfad, Sortierung und Filterung. Außerdem baute es die Zeilenauswahl sowie das Ein- und Ausklappen von Abschnitten neu, was die bisherige Grid-Bibliothek nicht mehr automatisch lieferte.
Turbopuffer als Leseschicht
Harvey verlagerte alle clientseitigen Operationen auf den Server. Postgres bleibt die maßgebliche Datenquelle (Source of Truth), während ein neuer Datenspeicher die Leseschnittstelle bereitstellt, nach dem CQRS-Muster. Das Team entschied sich für Turbopuffer, einen Vektor-Datenspeicher, der auf bestehenden Azure Blobs aufsetzt. Er unterstützt Vektorsuche, Volltextsuche (BM25) und Filterung über einen invertierten Index und organisiert Daten in Dokumenten innerhalb von Namespaces mit striktem Schema.
Zunächst mussten mehrere Probleme gelöst werden:
- Paginierung. Turbopuffer bietet keine integrierte Paginierung, daher schieden cursorbasierte Ansätze sowie Limit/Offset aus. Harvey setzte stattdessen auf ID-basierte Paginierung. Das Backend liefert Zeilen-IDs in der Reihenfolge, in der sie in der Oberfläche erscheinen sollen, und der Client kann Daten für jede beliebige Liste von Zeilen-IDs anfordern. Sortierung oder Filterung lädt diese Liste neu.
- Datentypen. Währungen und Datumsangaben müssen nach Wert sortiert werden, nicht lexikalisch. Da LLM-Antworten nicht immer zu einem Datentyp passen und Turbopuffer strikte Übereinstimmung verlangt, speichert Harvey jeden solchen Wert doppelt: einmal im strikten Typ und einmal als String.
- Schema-Drift. Fehlgeschlagene Schreibvorgänge konnten Postgres und Turbopuffer auseinanderlaufen lassen. Wird eine Abweichung erkannt, greifen Lesezugriffe auf Postgres zurück, und ein Backfill-Job repariert den betroffenen Namespace.
- Schema-Evolution. Zentrale Attribute wie Zeitstempel und Zeilenstatus gelten für alle Tabellen und ändern sich im Lauf der Zeit, sodass das System einen Weg zur Weiterentwicklung des Schemas benötigte.
Wird eine Tabelle angelegt, erzeugt Harvey in Postgres ihr Grundgerüst aus Zeilen-, Spalten- und Zellobjekten, wobei sensible Daten in einen getrennten Azure Blob wandern, und leitet daraus das Schema in Turbopuffer ab. Zellschreibvorgänge werden gebündelt an Turbopuffer übergeben.
Eine mehrphasige Ladestrategie
Leitprinzip ist, die wahrgenommene Latenz zu senken. Das Frontend fordert zunächst ein schlankes Grundgerüst mit Tabellenstatus, Spalten und Dateimetadaten an. Danach lädt es alle Werte der Sortierspalte in sortierter Reihenfolge. So können Nutzer an eine beliebige Stelle der Bildlaufleiste klicken und direkt zu diesem Teil der Tabelle springen. Standardmäßige Sortierspalte sind die Dateinamen.
Sobald diese beiden Teile geladen sind, rendert die Tabelle eine Struktur mit Kopfzeilen in der richtigen Reihenfolge und Ladeanimationen in den Zellen. Anschließend berechnet das Frontend den Zeilenbereich der aktuellen Seite, das Backend fragt Turbopuffer ab und liefert die Zeilen. Beim Scrollen werden weitere Seiten angefordert, wobei die Zahl der im Speicher gehaltenen Zeilen begrenzt ist. Wechselt man die Sortierspalte oder fügt Filter hinzu, beginnt der Vorgang von vorn.
Was das für Nutzer bedeutet
Harvey berichtet von sofortigen Latenzverbesserungen bei allen Tabellengrößen, wobei sich die Vorteile bei größeren Tabellen verstärken. Für Rechtsteams, die Tausende Dokumente prüfen, bedeutet das praktisch: Die größten Tabellen, die sich zuvor teils gar nicht öffnen ließen, laden nun und bleiben nutzbar, während Sortierung und Filterung erhalten bleiben.
Harvey: How We Made Review Tables Faster and More Reliable