Haut.AI stellt SkinFM und SkinBench vor und wirft führenden KI-Modellen Fehldeutungen der Haut vor
Haut.AI hat SkinFM vorgestellt, ein Foundation Model zur Hautanalyse, das mit mehr als 4 Millionen echten Hautbildern trainiert wurde. Dazu veröffentlicht das Unternehmen den öffentlichen Benchmark SkinBench. Laut Haut.AI zeigt dieser, dass sechs führende KI-Modelle häufig Hautprobleme erkennen, die nicht vorhanden sind, oder tatsächlich vorhandene übersehen.
- Haut.AI hat SkinFM vorgestellt, ein Foundation Model, das mit mehr als 4 Millionen echten Hautbildern trainiert wurde.
- SkinBench ist ein öffentlicher Benchmark mit 19 Tests zu sieben Hautthemen, der sechs führende KI-Modelle vergleicht.
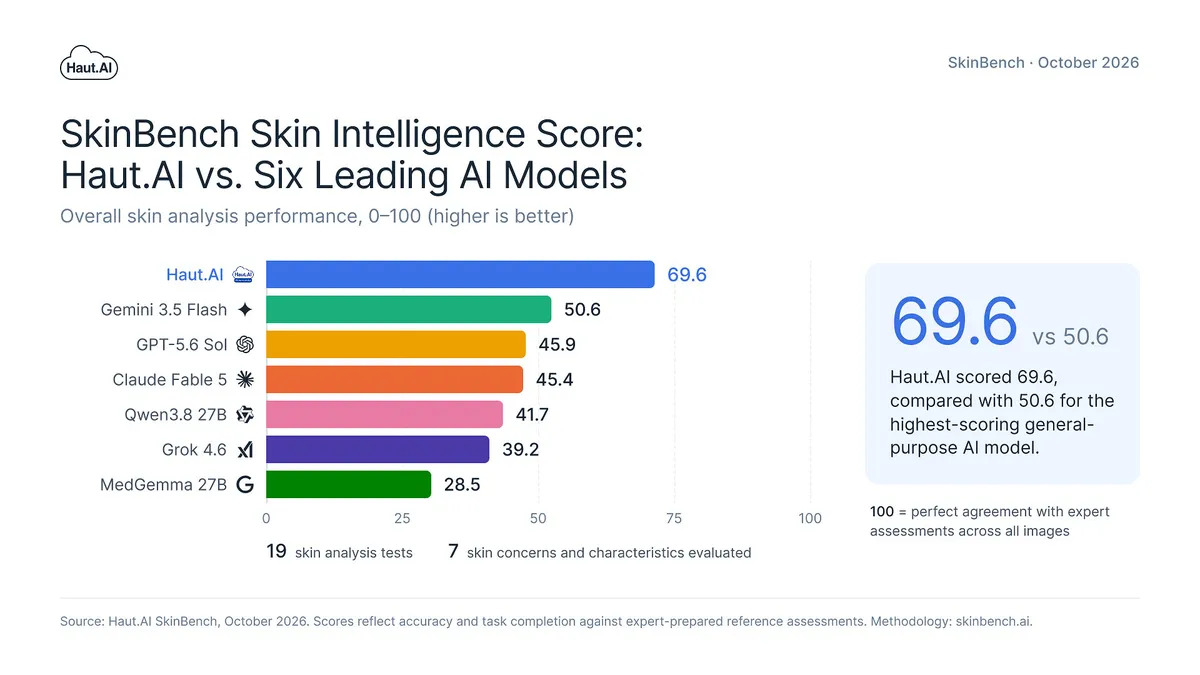
- Haut.AI erreichte 69,6 von 100 Punkten, Gemini 3.5 Flash als bestes Allzweckmodell 50,6.
- Laut Haut.AI erkannten die sechs Modelle bei etwa 95 bis 100 Prozent der Bilder ohne Schwellungen unter den Augen fälschlicherweise solche, bei der eigenen Analyse waren es rund 18 Prozent.
- Gemini 3.5 Flash schlug Haut.AI bei der Bewertung von Krähenfüßen und des Hauttons.
Was SkinFM ist und was es leistet
Haut.AI, ein SaaS-Unternehmen mit Fokus auf KI-gestützte Hautanalyse und personalisierte Hautpflege, beschreibt SkinFM als bildbasiertes Foundation Model. Anders als herkömmliche Systeme, die für verschiedene Aufgaben der Hautanalyse jeweils eigene Modelle benötigen, nutzt SkinFM nach Angaben des Unternehmens eine einzige Grundlage, um mehrere Hautmerkmale zu analysieren.
Haut.AI zufolge lassen sich dadurch neue Hautmessungen schneller entwickeln und individuelle Bewertungssysteme für einzelne Marken aufbauen. Die Technologie kann mehr als 230 Hautmessungen und 48 Biomarker erfassen, darunter Falten, Rötungen, Pigmentierung und weitere sichtbare Merkmale. Für Beauty-Marken bedeutet das laut Unternehmen: Bewertungen lassen sich auf die eigenen Produkte und Kunden zuschneiden, neue Messwerte schneller einführen, fundiertere personalisierte Empfehlungen aussprechen, sichtbare Verbesserungen über die Zeit verfolgen sowie Forschung und Produktentwicklung unterstützen.
Was SkinBench misst
SkinBench wurde vom Data-Science-Team von Haut.AI entwickelt. Der Benchmark vergleicht die spezialisierte Technologie des Unternehmens mit Gemini 3.5 Flash, GPT-5.6 Sol, Claude Fable 5, Grok 4.6, Qwen 3.8 27B und MedGemma 27B. Er umfasst 19 Tests zu sieben Hautthemen: Falten, Sonnenflecken, Rötungen, Hautton, Hauttyp, dunkle Augenringe und Schwellungen unter den Augen. Elf Tests identifizieren und bewerten sichtbare Merkmale, acht messen, wie genau die Modelle diese lokalisieren. Die Ergebnisse werden mit Referenzbewertungen von Expertinnen und Experten verglichen.
Beim SkinBench Skin Intelligence Score, einer Skala von 0 bis 100, bei der 100 für perfekte Übereinstimmung mit den Expertenurteilen bei jedem Bild steht, erreichte Haut.AI 69,6 Punkte. Gemini 3.5 Flash, das beste Allzweckmodell, kam auf 50,6.
Zentrale Ergebnisse: Fehlalarme und übersehene Befunde
Haut.AI zufolge haben alle sechs Modelle bei etwa 95 bis 100 Prozent der Bilder, auf denen keine Schwellungen unter den Augen vorhanden waren, dennoch solche erkannt. Die eigene, auf SkinFM basierende Analyse kam auf eine Fehlerkennungsrate von rund 18 Prozent. Das schwächste Modell übersah 85 Prozent der tiefen Stirnfalten, während das Modell von Haut.AI 82 Prozent fand; die übrigen Modelle kamen auf 15 bis 60 Prozent.
- Zornesfalten: Haut.AI erreichte bei der Übereinstimmung mit Expertenurteilen zum Schweregrad 0,82, GPT-5.6 Sol 0,73 und menschliche Bewerter 0,86. Grundlage waren 350 computergenerierte Gesichter.
- Falten lokalisieren: Beim Nachzeichnen von Zornesfalten auf 350 synthetischen Gesichtern kam Haut.AI auf 47,8 von 100 Punkten, GPT-5.6 Sol als stärkster Konkurrent auf 20,2. In einem Beispiel markierte Claude Fable 5 stattdessen Nase und Mund.
- Hauttyp: Haut.AI erzielte 77,8 von 100 Punkten, das stärkste konkurrierende Modell 57,7.
- Hauttöne: Haut.AI kam auf 50,9, das nächstbeste Allzweckmodell auf 30,3. Der Wert richtet sich nach der jeweils schwächsten berücksichtigten Hauttongruppe eines Modells.
Haut.AI gewann nicht jeden Test. Gemini 3.5 Flash schnitt bei der Bewertung von Krähenfüßen (71,7 gegenüber 61,8) und bei der Beurteilung des Hauttons (90,4 gegenüber 87,6) besser ab. Das Unternehmen sieht darin einen Beleg dafür, wie wichtig es ist, KI-Werkzeuge anhand der konkreten Aufgaben zu bewerten, für die sie gedacht sind, statt sich auf einen einzigen Gesamtwert zu verlassen.
Warum das für die Hautpflege relevant ist
Haut.AI verweist auf die wachsende Nutzung von KI für Beauty-Beratung. Das Unternehmen zitiert NielsenIQ, wonach 49 Prozent der Verbraucher Empfehlungen für Beautyprodukte von GenAI übernommen haben, sowie Accenture, wonach 75 Prozent der Beauty-Kunden offen für ein KI-gestütztes Einkaufserlebnis sind. Eine Umfrage von Haut.AI unter 1.238 Frauen in den USA ergab, dass 62 Prozent sich für KI-Beratung zu Haut- oder Körperpflege interessieren oder sie bereits nutzen.
„KI kann ein Gesicht erkennen, aber das heißt nicht, dass sie die Haut zuverlässig beurteilen kann“, sagte Anastasia Georgievskaya, CEO und Mitgründerin von Haut.AI. Das Unternehmen argumentiert, ungenaue Bewertungen könnten zu unnötigen Produktempfehlungen, verschwendeten Ausgaben und geringerem Vertrauen in die personalisierten Angebote der Marken führen. Außerdem verweist es auf eine Gartner-Prognose vom April 2025, wonach Unternehmen bis 2027 kleinere, spezialisierte KI-Modelle mindestens dreimal so häufig einsetzen werden wie universelle große Sprachmodelle.
Da SkinBench von Haut.AI selbst veröffentlicht wird und das eigene Produkt vergleicht, handelt es sich bei den Ergebnissen um Angaben des Unternehmens. Der Benchmark ist jedoch öffentlich, sodass andere nachprüfen können, wie die Modelle abschneiden.