Hugging Face zeigt MoE-Inferenz mit 180B und 32 GB RAM
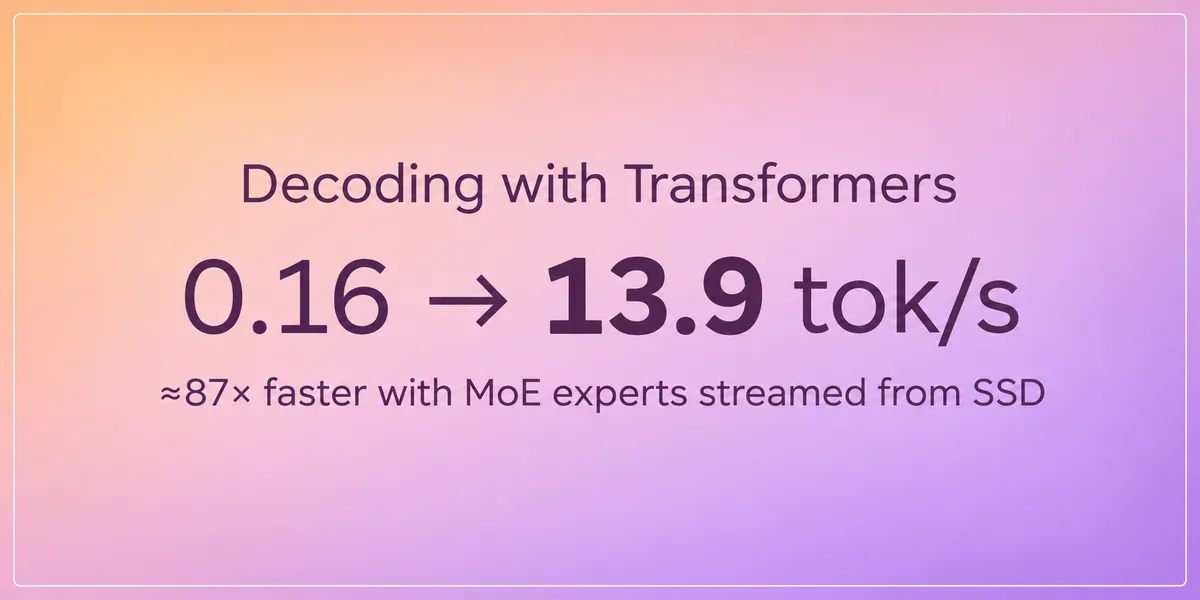
Hugging Face stellt einen Transformers-Ansatz namens MoE Expert Streaming vor. Die Seite trägt den Titel „180B Parameters, 32GB of RAM: Pushing MoE Inference to the Limit with Transformers“. Außerdem verweist sie auf die Textgenerierung mit Qwen3.8 und gestreamten Experten.
- Hugging Face hat eine Seite über MoE Expert Streaming in Transformers veröffentlicht.
- Der Titel bezieht sich auf 180B Parameter und 32 GB RAM.
- Die Seite verlinkt auf die Textgenerierung mit Qwen3.8 und gestreamten Experten.
- Der Quelltext enthält keine Benchmark-Ergebnisse, Implementierungsdetails oder Angaben zur Verfügbarkeit.
Fokus auf große MoE-Modelle
Die auf den 18. November 2026 datierte Seite von Hugging Face befasst sich mit der Inferenz von Mixture-of-Experts-Modellen, kurz MoE, in Transformers. Im Mittelpunkt des Titels stehen ein Modell mit 180B Parametern und ein System mit 32 GB RAM.
Die Seite beschreibt das Projekt als „MoE expert streaming in Transformers“ und stellt Expert Streaming als Thema des Artikels vor. Der verfügbare Quelltext enthält keine weiteren Details zur Implementierung, keine Benchmark-Ergebnisse und keine Angaben zur Hardware.
Qwen3.8 dient als Beispiel
Hugging Face verlinkt den Artikel mit einer Umgebung zur Textgenerierung, die als „Generate text with Qwen3.8 using streamed experts“ beschrieben wird. Dies ist das einzige konkrete Nutzungsbeispiel im Quelltext.
Die Seite führt außerdem im Artikel erwähnte Modelle auf und zeigt einen damit verbundenen Space. Der Quelltext sagt nicht, ob der Ansatz über ein bestimmtes Produkt, einen bestimmten Dienst oder eine bestimmte Hardwarekonfiguration verfügbar ist, abgesehen von der Angabe von 32 GB im Titel.
Warum die Ankündigung wichtig ist
Die Ankündigung lenkt den Blick auf die Diskrepanz zwischen der Gesamtzahl der Parameter eines Modells und dem verfügbaren Speicher des Systems, auf dem die Inferenz läuft. Indem Hugging Face 180B Parameter mit 32 GB RAM in der Überschrift kombiniert, präsentiert das Unternehmen Expert Streaming als Möglichkeit, die Grenzen beim Betrieb großer MoE-Modelle mit Transformers auszuloten.
Für Nutzer und Entwickler liegt die unmittelbare Bedeutung darin, dass Hugging Face einen Ansatz mit gestreamten Experten dokumentiert und ihn mit der Textgenerierung von Qwen3.8 verknüpft. Der Quelltext nennt weder eine bestimmte Geschwindigkeit noch eine Qualitätsverbesserung, einen Veröffentlichungstermin oder eine breitere Verfügbarkeit.