Intento testet 229 KI-Übersetzungslösungen in 100 Sprachen
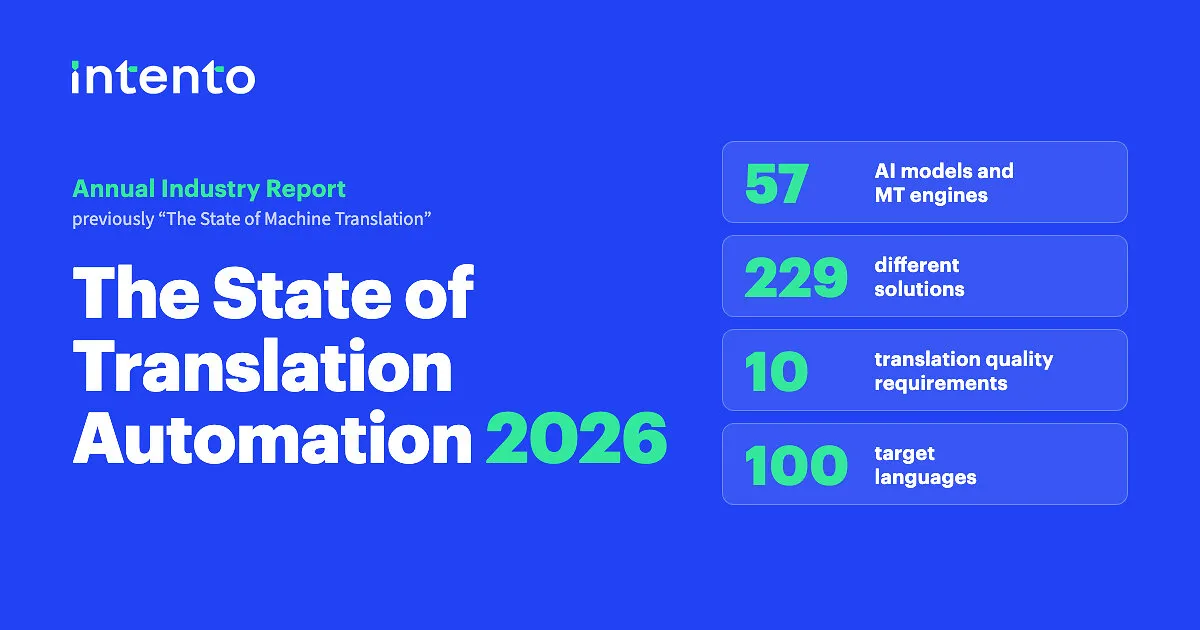
Intento hat den Report „The State of Translation Automation 2026“ veröffentlicht. Der interaktive Bericht vergleicht 229 KI-Übersetzungslösungen in 100 Sprachen nach Qualität, Kosten und Übersetzungsdauer. Laut Unternehmen zeigen die Ergebnisse, dass die Qualität stark von der Sprache, den Anforderungen und dem Workflow rund um das Modell abhängt.
- Intento bewertete 229 Lösungen aus 57 KI-Modellen und MT-Engines bei Übersetzungen aus dem Englischen in 100 Sprachen.
- Für Basic gibt es in 54 Sprachen eine einstufige Lösung plus geeigneten Ersatz, bei Standard sind es 38 und bei Advanced 12.
- Von den LLM-Lösungen, die zunächst scheitern, erfüllen 24 % die allgemeine Qualitätsanforderung nach Nachbearbeitung und 60 % nach Qualitätsbewertung und Fehlerbehebung.
- Keine der in 84 Sprachen bewerteten einstufigen Echtzeitlösungen erfüllt alle Standard-Anforderungen.
- Der Report ist kostenlos und ohne Registrierung lesbar, die Kosten basieren auf Listenpreisen vom August 2026.
Was der Report abdeckt
Leserinnen und Leser können im Report ihre Übersetzungsanforderungen, eine Zielsprache und das Optimierungsziel wählen: Qualität, Kosten oder Übersetzungsdauer. Anschließend zeigt er, welche Lösungen die Anforderungen in dieser Sprache erfüllen und wie sie im Vergleich abschneiden. Der Report ist ohne Registrierung zugänglich.
Sprachingenieure bei Intento bewerteten 229 Lösungen aus 57 KI-Modellen und Engines für maschinelle Übersetzung (MT) und übersetzten dabei aus dem Englischen in 100 Sprachen. Die 57 Modelle stammen von 37 Anbietern, darunter Alibaba, Amazon, Anthropic, Cohere, DeepL, DeepSeek, Google, Microsoft, Mistral, OpenAI, Tencent und xAI. Dazu zählen neuronale maschinelle Übersetzungsmodelle, MT-Systeme auf Basis großer Sprachmodelle (LLMs) sowie kommerzielle und offene LLMs (Open-Weight).
Jede Lösung kombiniert ein Modell mit einem Harness: Prompts, Glossare und weiterem Kontext sowie Vor- und Nachverarbeitung. Das Team testete fertige Standardmodelle und Modelle, die mit Glossaren, Vorgaben zur Tonalität und Tag-Handling angepasst wurden. Außerdem prüfte es zweistufige Lösungen, die übersetzen und anschließend mit einem LLM nachbearbeiten, dreistufige Lösungen, die übersetzen, die Qualität bewerten und Fehler beheben, sowie Multiagentensysteme für anspruchsvolle Anforderungen.
Drei Qualitätsstufen und Ablauf der Tests
Das Team bewertete 10 Anforderungen auf drei Qualitätsstufen:
- Basic: allgemeine Übersetzungsqualität.
- Standard: Basic plus Terminologie, Tonalität und sechs Formatierungsanforderungen, etwa Tag-Handling, gültiges JSON und Unicode-Unterstützung.
- Advanced: Standard plus Geschlechterneutralität.
Für jede Sprache begann das Team mit einem fertigen Standardmodell und ergänzte Schritte nur dann, wenn eine einfachere Lösung die Anforderungen nicht erfüllen konnte. Intento zufolge entspricht das dem Vorgehen bei Kundenprojekten.
Zwischen Juni und September 2026 übersetzten die Ingenieure vier englische Geschäftstexte mit insgesamt 2.978 Wörtern: einen redaktionellen Artikel, eine rechtliche Datenschutzerklärung, ein institutionelles Leitbild samt Planungsleitfaden und eine Reisewarnung. Zwei automatisierte Metriken zur Qualitätsschätzung wählten pro Sprache 10 bis 13 Lösungen in die engere Auswahl. Anschließend bewertete Intento LQA diese Übersetzungen. Drei LLM-Juroren von drei Anbietern identifizierten Fehler nach Art und Schweregrad, ein viertes LLM fasste deren anonymisierte Ergebnisse zusammen. Ein Ergebnis wurde nur akzeptiert, wenn die drei Juroren bei mindestens 90 % der Sätze übereinstimmten. Die sechs Formatierungsanforderungen wurden per Code geprüft. Die Kosten basieren auf den Listenpreisen vom August 2026 in US-Dollar pro Million Zeichen des englischen Ausgangstexts.
Zentrale Ergebnisse: Strengere Anforderungen verkleinern die Auswahl
Je anspruchsvoller die Anforderungen, desto weniger Sprachen bieten eine einstufige Lösung plus einen geeigneten Ersatz. Bei der Qualitätsstufe Basic gibt es diese Kombination in 54 der 100 Sprachen. Bei Standard sinkt die Zahl auf 38 Sprachen, bei Advanced auf 12. Der Ersatz kann zusätzliche Schritte erfordern. In 18 Sprachen sind automatisierte Prüfungen nicht zuverlässig genug, um jede Anforderung zu bewerten.
Zusätzliche Schritte helfen LLM-Lösungen, die Anforderung an die allgemeine Übersetzungsqualität zu erfüllen. Von den bewerteten LLM-Lösungen, die zunächst scheitern, schaffen es 24 % nach Übersetzung und Nachbearbeitung und 60 % nach Übersetzung, Qualitätsbewertung und Fehlerbehebung.
Tempo geht zulasten der Qualität. Keine der in 84 Sprachen bewerteten einstufigen Echtzeitlösungen erfüllt alle Standard-Anforderungen. In den 38 Sprachen, in denen eine einstufige Lösung diese Anforderungen erfüllt, benötigt die schnellste qualifizierte Lösung im Median rund 65 Sekunden pro 1.000 Wörter Ausgangstext.
Was das für Käufer von Übersetzungslösungen bedeutet
Konstantin Savenkov, CEO und Mitgründer von Intento, sagte, Übersetzungsautomatisierung habe früher bedeutet, „das ‚weniger falsche‘ Modell für maschinelle Übersetzung für Ihre Inhalte und Ihr Sprachpaar zu wählen“. Heute bedeute sie, einen Harness um die Modelle zu bauen, der Ihre Anforderungen erfüllt. Das sei nicht möglich „ohne Evaluierungen, die jede Anforderung prüfen“.
Für Unternehmen legt der Report nahe, dass die Wahl eines einzelnen besten Modells nicht ausreicht. Das passende Setup variiert je nach Sprache und Strenge der Anforderungen, und die Ergebnisse zeigen, wo zusätzliche Schritte oder Ersatzlösungen nötig sind. Intento weist darauf hin, dass dieselben Sprachingenieure KI-Workflows für mehr als 60 Unternehmenskunden über Hunderte Sprachpaare hinweg konfigurieren. Das Unternehmen verkauft Übersetzungsautomatisierung, daher sollten Leser berücksichtigen, dass der Benchmark von einem Anbieter in diesem Markt stammt.