IQuest-Q1: Coding-Modell mit 320 Milliarden Parametern stößt auf frühes Entwicklerinteresse
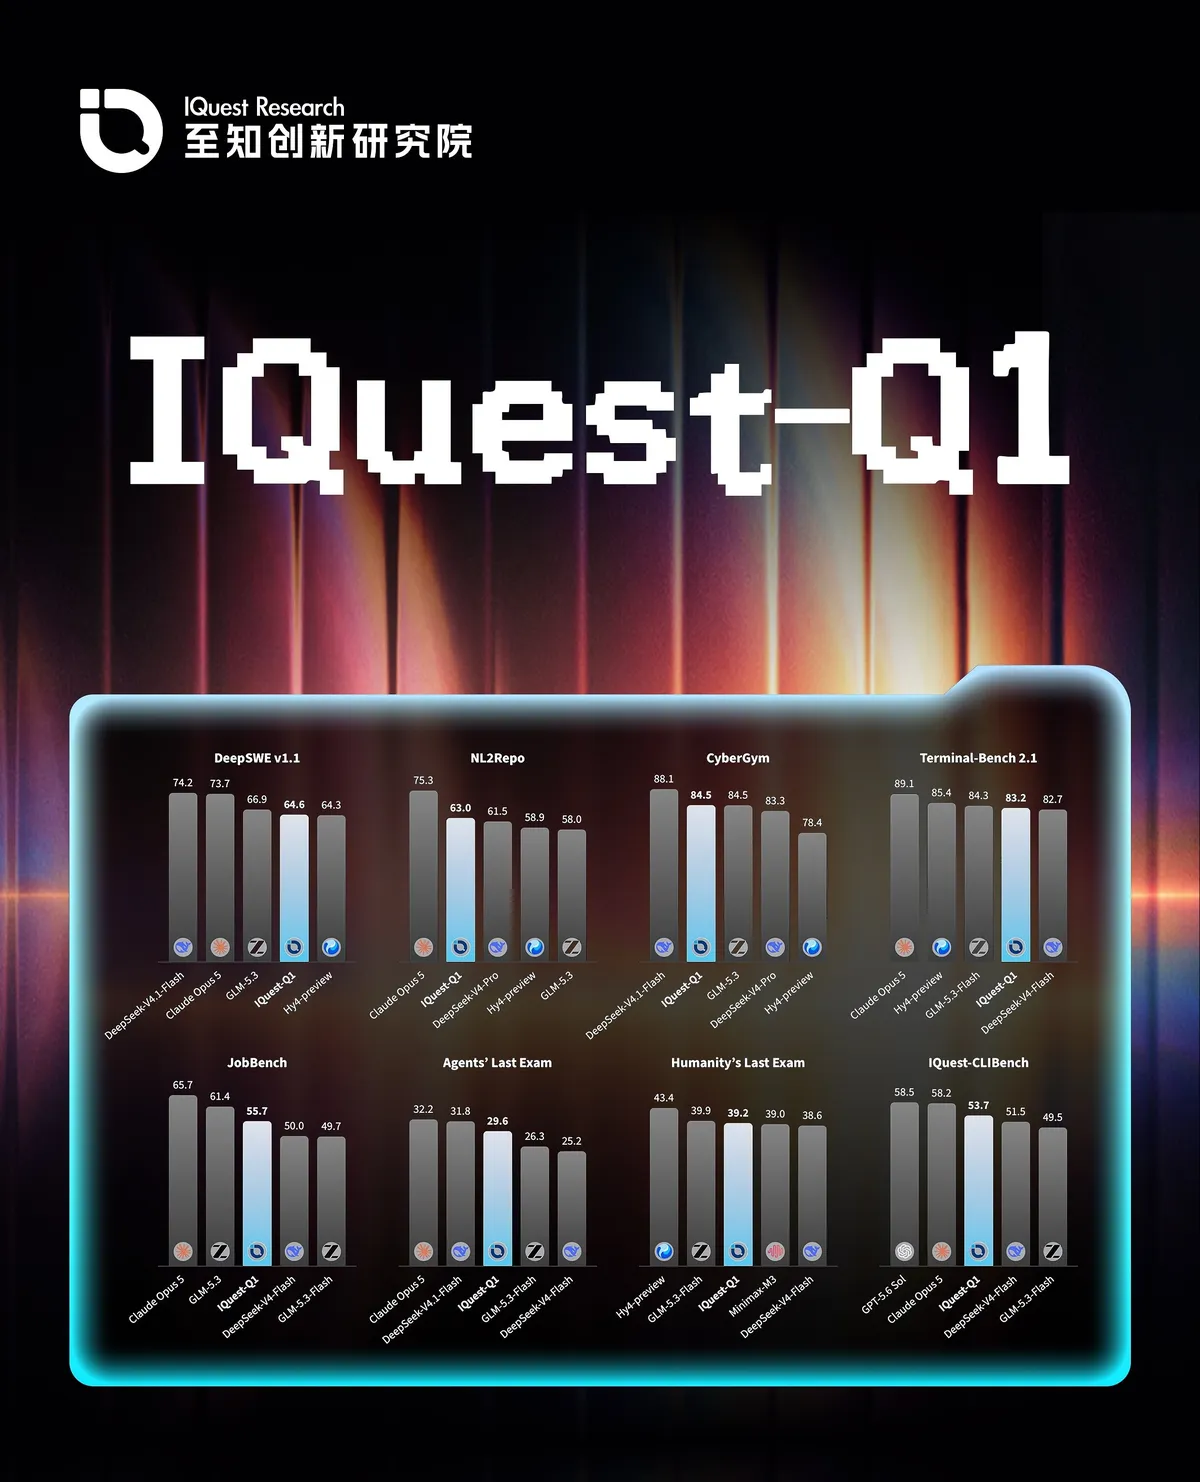
IQuest-Q1, ein Modell von IQuest Research, hat nach Angaben des Unternehmens früh Lob von Entwicklern und Branchenbeobachtern erhalten, und zwar für Programmierung, Softwareentwicklung, die Erzeugung interaktiver Anwendungen und langfristige Agentenaufgaben. Die Modellgewichte und technischen Unterlagen sind öffentlich auf GitHub und Hugging Face verfügbar.
- IQuest-Q1 von IQuest Research stößt früh auf Interesse bei Entwicklern, insbesondere für Coding, Softwareentwicklung und Agenten-Workloads.
- Das Modell hat rund 320 Milliarden Parameter insgesamt, davon etwa 15 Milliarden aktiv pro Token, in einem spärlich aktivierten Mixture-of-Experts-Design.
- Gewichte und technische Unterlagen sind öffentlich auf GitHub und Hugging Face verfügbar.
- Zu den Demos zählen Ego-Shooter und Rennspiel in einem Durchgang, das Debugging eines RL-Laufs und mehrstufige Büroaufgaben.
- Benchmark-Werte enthält die Mitteilung nicht; sie stehen im technischen Bericht.
Was erste Beobachter sagen
Laut IQuest Research hat in der externen Diskussion bereits die Auseinandersetzung damit begonnen, was IQuest-Q1 leisten kann. Ein Beitrag hob die Bewertung des Modells in den Bereichen Anwendungsentwicklung, 3D-Raumgenerierung, Codediagnose und -reparatur sowie komplexe werkzeuggestützte Workflows hervor. Ein weiterer öffentlich geteilter Anwendungsfall beschrieb, wie aus einem schriftlichen Produktbriefing ein interaktives SaaS-Analyse-Dashboard entsteht.
Eine technische Übersicht von dritter Seite beleuchtete die spärlich aktivierte Mixture-of-Experts-Architektur des Modells, die Anbindung an Claude Code und Codex CLI sowie die Infrastruktur, die für das Self-Hosting eines Modells mit 320 Milliarden Parametern nötig ist. Das Unternehmen erklärt, diese Beobachtungen deckten sich mit seinen eigenen offiziellen Demonstrationen.
IQuest Research beschreibt das Modell als auf den Entwickleralltag trainiert: sich in einem Repository zurechtfinden, ein Terminal bedienen, Werkzeuge aufrufen, einen langen Kontext im Blick behalten und mehrstufige Aufgaben abschließen. Schlussfolgern, Werkzeugnutzung, Verständnis langer Kontexte und mehrstufige Ausführung seien von Anfang an Teil des Trainingsziels gewesen und nicht erst nachträglich angepasst worden.
Demonstrationen: Apps, Debugging und Büroarbeit
Das Unternehmen verweist auf drei Arten von Demonstrationen.
- Interaktive Apps in einem Durchgang. Aus einem Prompt in natürlicher Sprache erzeugt das Modell lauffähige Apps in einem einzigen Durchlauf. In einer Demo eines Ego-Shooters umfasst eine einzige Generierung die 3D-Szene, Figurenbewegung, Lebenspunkte, Punktestand, Moduswechsel und einen In-Game-Shop für Ressourcen und Ausrüstung. In einer Rennspiel-Demo übernimmt das Modell die fortlaufende Erweiterung der Szene, darunter Streckengeometrie sowie Übergänge zwischen Vorder- und Hintergrund. Genau daran scheitern laut IQuest Research Ein-Schritt-Generierungen üblicherweise.
- Debugging eines echten RL-Laufs. Ausgehend von den Trainingskurven holte sich das Modell Logs und Ausführungsprotokolle, schloss rückwärts auf wahrscheinliche Ursachen und lokalisierte den Fehler im Code. Nach einem Patch und Neustart las es die neuen Metriken aus und bestätigte die Erholung. Die Ursache war ein versehentlich in die Trainingstrajektorie eingefügtes Leerzeichen.
- Mehrstufige Arbeit in einer realen Umgebung. In einem Arbeitsbereich mit gemischten Informationen und Werkzeugen liest das Modell, ruft Tools auf und korrigiert sich selbst, sobald neue Informationen eintreffen. Im Büroumfeld arbeitet es nach Angaben des Unternehmens über Chat, Cloud-Dokumente, Tabellen und Kommentarverläufe hinweg und liefert Analysen, Entwürfe und Überarbeitungen, die übergabereif sind.
Architektur und Training
IQuest-Q1 ist ein Decoder-only-Transformer mit einem spärlich aktivierten Mixture-of-Experts-Feed-Forward-Design. Es hat rund 320 Milliarden Parameter insgesamt, von denen etwa 15 Milliarden pro Token aktiv sind.
Das Training läuft in drei Phasen: Pre-Training, Mid-Training und Post-Training. Dem Unternehmen zufolge entsteht so zunächst Sicherheit im Umgang mit Code, die sich dann auf längere und schwierigere Aufgaben ausweitet. Das Post-Training konzentriert sich auf Softwareentwicklung, langfristige Agentenaufgaben und allgemeines Schlussfolgern und nutzt dafür überwachtes Feintuning und Reinforcement Learning.
Darüber hinaus bündelt Multi-Teacher On-Policy Distillation (MOPD) die Stärken mehrerer Lehrermodelle anhand der eigenen On-Policy-Rollouts des Schülermodells. Laut IQuest Research gewinnt das Schülermodell dadurch an Fähigkeiten, ohne das Verzerrungsprofil eines einzelnen Lehrers zu übernehmen. Zudem gibt das Unternehmen an, seine Pipelines, Trainingskonfigurationen, Evaluierungsumgebungen und Werkzeuge würden versioniert und über Iterationen hinweg wiederverwendet.
Benchmarks und Zugang
IQuest Research erklärt, IQuest-Q1 erreiche ausgewogene Ergebnisse in Benchmarks für Code, Softwareentwicklung, Terminalnutzung, Werkzeugnutzung und Agentenaufgaben. Genannt werden NL2Repo (Codegenerierung auf Repository-Ebene), CyberGym (Cybersicherheit), Terminal-Bench 2.1 (Terminalbedienung), DeepSWE v1.1 (langfristiges Coding) und JobBench (professionelle Büro-Workflows). Die Pressemitteilung nennt keine Punktwerte; die vollständigen Zahlen, Vergleichsmodelle und der Evaluierungsaufbau stehen im technischen Bericht.
Für Entwickler machen die öffentlichen Gewichte und die in der Übersicht von dritter Seite erwähnte Kompatibilität mit Tools wie Claude Code und Codex CLI das Modell für praktische Tests zugänglich, wobei das Self-Hosting eines Modells mit 320 Milliarden Parametern erhebliche Anforderungen an die Infrastruktur stellt. Entwickler und Forschungsteams, die an kommenden Early-Access-Testprogrammen interessiert sind, können sich per E-Mail bei IQuest Research um einen Testzugang bewerben.