Kilo Code: Sicherheit ist jetzt der Multiplikator in der LLM-Kaufentscheidung
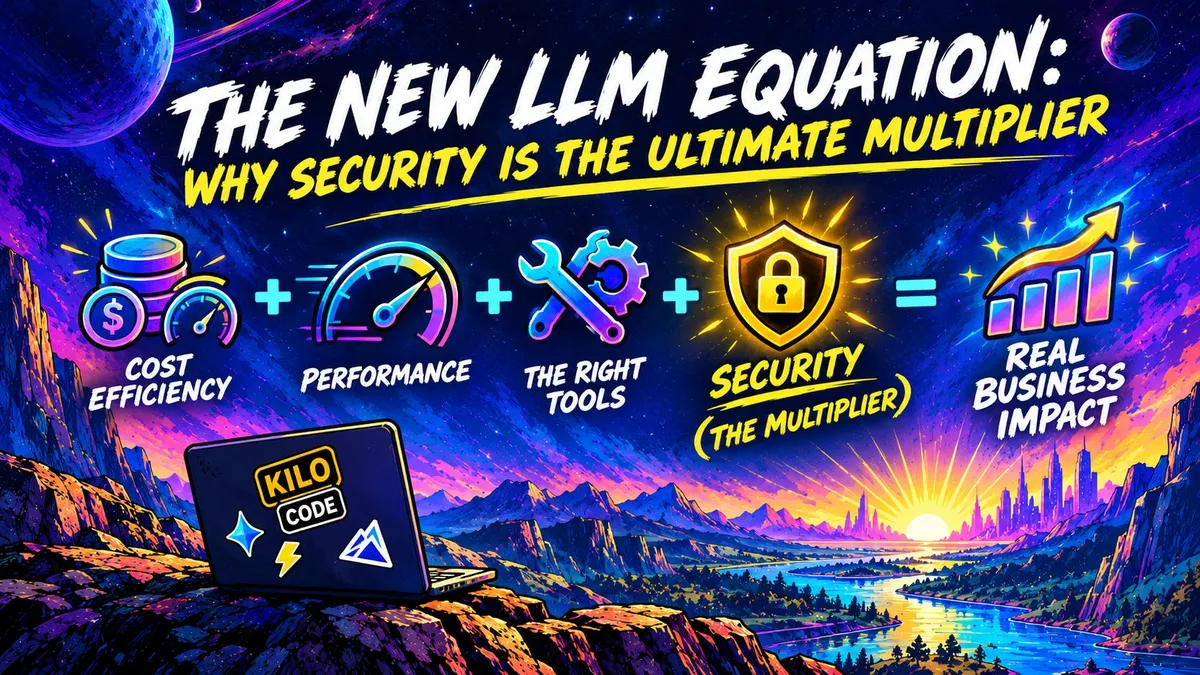
Kilo Code argumentiert, dass Unternehmen bei der Modellauswahl nicht mehr nur auf Kosten, Leistung und Effizienz schauen sollten, weil Sicherheit alle drei Faktoren jetzt multipliziert. In einem Blogbeitrag von Ari Messer verweist das Unternehmen auf die Veröffentlichungen von Google, OpenAI und Anthropic in dieser Woche als Beleg dafür, dass die führenden KI-Labore Sicherheit über Tempo stellen.
- Kilo Code zufolge sollte die Modellwahl nun (Kosten + Leistung + Effizienz) × Sicherheit lauten.
- Google führt Gemini 4 Argon laut Kilo gestaffelt ein, während es Schutzmaßnahmen verbessert.
- OpenAI verzichtete auf GPT-6.1 Astra und veröffentlichte auf der DevDay in San Francisco GPT-6.1 Sol.
- Claude Sonnet 5.5 kostet 2 / 10 US-Dollar pro Million Token und ist laut Kilo über 30 % schneller als Sonnet 5.
- Die Risikobewertungen von Enkrypt AI werden jetzt im Kilo Leaderboard angezeigt.
Eine neue Gleichung für die Modellwahl
Laut Kilo Code folgte die Diskussion über Unternehmens-KI den größten Teil dieses Jahres einer dreiteiligen Gleichung: Kosten + Leistung + Effizienz. Teams verfolgten Token pro Sekunde, die Größe von Kontextfenstern und die Dollarkosten pro Million Token. Diese Gleichung sei nun überholt und müsse lauten: (Kosten + Leistung + Effizienz) × Sicherheit.
Die Begründung: Ein schnelles, günstiges Modell nützt einem Unternehmen wenig, wenn es Daten preisgibt, anfälligen Code schreibt oder sich unvorhersehbar verhält, sobald es ohne Aufsicht läuft. Kilo verweist auf die Größenordnung, die das Thema dringlich mache: Kilo by Anaconda orchestriert monatlich Billionen von Token für mehr als 5 Millionen Entwickler, und jeder Token läuft durch ein Modell, das jemand auswählen und dem jemand vertrauen musste.
Google und OpenAI halten sich zurück
Kilo zufolge hat sich Google aus Sicherheitsbedenken für eine schrittweise, gestaffelte Einführung von Gemini 4 Argon entschieden statt für einen weltweiten Start mit allgemeiner Verfügbarkeit. Google habe das Modell intern ausgiebig genutzt und hebe besonders seine Stärken bei der Speichereffizienz sowie bei Migrationen und Optimierungen großer Codebasen hervor. Vor einer allgemeinen Freigabe arbeite das Unternehmen noch daran, eine Reihe „kritischer Frontier-Schutzmaßnahmen“ zu verbessern. Kilo zitiert einen Bericht des WSJ über die schrittweise Einführung und liest ihn als Zeichen dafür, dass das Management von Einsatzrisiken inzwischen wichtiger ist als der Sieg im Nachrichtenzyklus.
Der Beitrag erklärt außerdem, Gemini 3.8 Flash liege auf KiloBench vor GPT-5.5 und Kimi K3 und sei für viele Kilo Coders zum täglichen Arbeitswerkzeug geworden.
OpenAI ging dem Beitrag zufolge noch weiter. Die Branche habe GPT-6.1 Astra auf der DevDay in San Francisco erwartet, doch OpenAI habe sich unter Verweis auf eine Reihe von Sicherheitsbedenken gegen eine Veröffentlichung entschieden. Stattdessen erschien auf derselben Veranstaltung GPT-6.1 Sol. Kilo zufolge hat sich das neue Modell bereits als ausgerichtet und mit Leitplanken versehen erwiesen und bringe Leistung mit strengeren Sicherheitsgarantien in Einklang. Der Autor liest die Botschaft so: „Rohe Leistungsfähigkeit, die sich nicht absichern lässt, wird nicht ausgeliefert.“ Er fügt aber hinzu, die kommenden Monate würden zeigen, ob das konsequent geschieht oder nur ein einmaliger Ausrutscher war.
Anthropics Claude Sonnet 5.5
Anthropic hat diese Woche Claude Sonnet 5.5 vorgestellt, kurz nach Opus 5.5. Kilo beschreibt es als das bislang effizienteste Modell von Anthropic. Es kostet 2 / 10 US-Dollar pro Million Token und arbeitet im Vergleich zu Sonnet 5 über 30 % schneller und senkt die Kosten pro Aufgabe bei den meisten Arbeiten um bis zu 30 %.
Zur Sicherheit zitiert der Beitrag Anthropic mit den Worten, Sonnet 5.5 „schneidet bei unseren Alignment-Tests besser ab als Sonnet 5“ und verfüge über „neue, stärkere Schutzmaßnahmen, die dem Leistungssprung entsprechen“. Anfragen mit höherem Cybersicherheitsrisiko würden nun sofort abgelehnt. Kilo ergänzt, dass auf seinem Code-Review-Leaderboard zuletzt nicht das neue Sonnet, sondern GPT-6 Astra und Opus 5.5 weit oben standen, zusammen mit GLM 5.3 Flash.
Das Open-Weight-Dilemma und Kilos Antwort
Kilo sagt, Open-Weight-Modelle legten rasant zu, stellten aber eine andere Sicherheitsfrage. In den internen Benchmarks des Unternehmens erzielen MiMo v2.6 Pro und GLM 5.3 Spitzenergebnisse bei autonomem Code-Review, Schwachstellenerkennung und sicherer Codegenerierung. Dennoch fragten Unternehmensteams, wie die Modelle trainiert wurden, was in den Gewichten steckt und wo die Anfragen verarbeitet werden.
Der Beitrag weist darauf hin, dass Anthropic GLM-5.3 bei den Cybersicherheitsfähigkeiten mit Fable verglichen und festgestellt habe: „Die laxen Schutzmaßnahmen von GLM-5.3 erhöhen die für böswillige Akteure verfügbaren Cyberfähigkeiten erheblich.“
Kilo positioniert sein Unternehmensangebot als Antwort darauf. Aufgeführt werden mehrere Stufen von Sicherheitskontrollen, keine Datenspeicherung bei kostenpflichtigen Tarifen, Unterauftragsverarbeiter, Verschlüsselung und Zugriffskontrollen, Incident Response, Unterstützung für Auftragsverarbeitungsverträge (DPA) und ein Live-Trust-Center. Zudem empfiehlt Kilo Enkrypt AI, eine Sicherheits- und Governance-Plattform mit Inline-Sentry-Leitplanken, automatisiertem Red-Teaming und Compliance-Überwachung für Workspaces. Die Risikobewertungen von Enkrypt sind jetzt im Kilo Leaderboard verfügbar.
Was das für Entwickler bedeutet
Für Teams, die Modelle auswählen, lautet die Kernaussage des Beitrags: Benchmark-Geschwindigkeit und Preis genügen allein nicht mehr. Die Veröffentlichungsentscheidungen der großen Labore in dieser Woche zeigen, wie Kilo sie beschreibt, dass Schutzmaßnahmen mitbestimmen, was wann erscheint. Teams, die Open-Weight-Modelle einsetzen, sollten neben der Leistungsfähigkeit auch Herkunft und Serving-Standort bewerten. Als Anbieter von Werkzeugen in diesem Bereich hat Kilo ein eigenes Interesse an dieser Sichtweise, und die Benchmark-Aussagen im Beitrag stammen aus den eigenen internen Tests.
Kilo Code: The New LLM Equation: Why Security Is the Ultimate Multiplier