LanceDB ergänzt GPU-Beschleunigung für groß angelegte Vektorindizierung
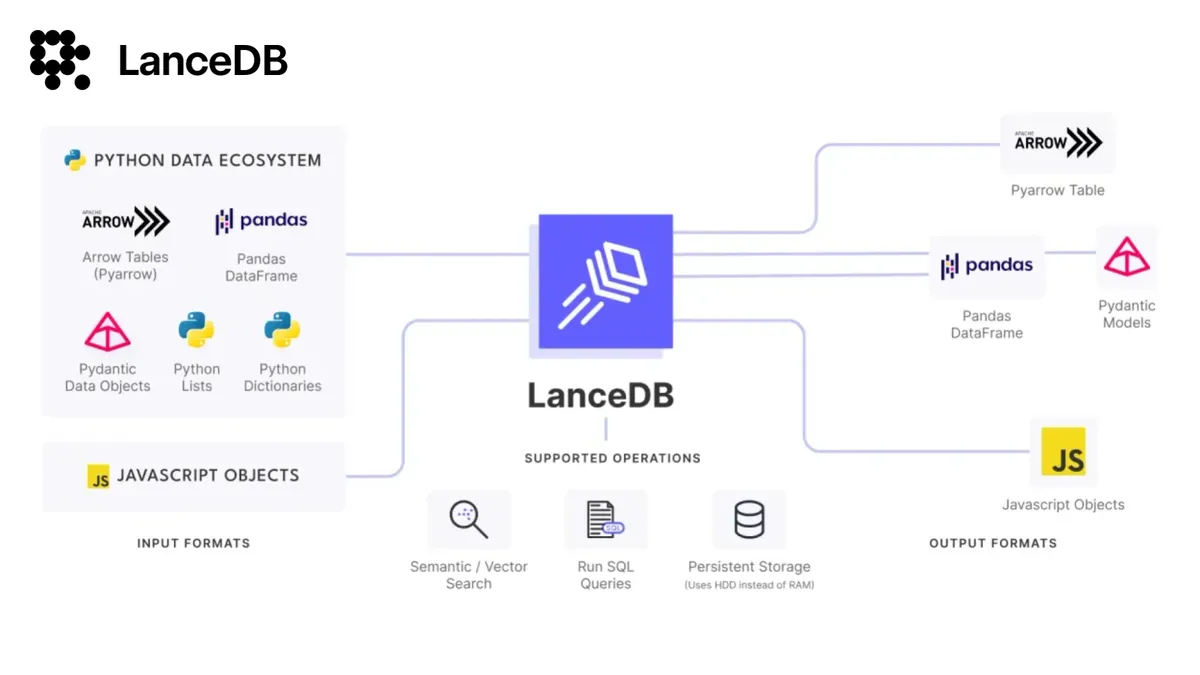
LanceDB hat die GPU-Beschleunigung für das Training von Vektorindizes ergänzt. Nutzer mit Nvidia-GPUs oder unterstützten Apple-Silicon-Geräten können beim Erstellen von Indizes CUDA oder MPS verwenden. Nach Angaben des Unternehmens kann das KMeans-Training dadurch bis zu 20, 26x schneller sein als bei der Verarbeitung durch die CPU.
- LanceDB v0.3.3 ergänzt CUDA- und MPS-Unterstützung für das Indextraining.
- Die GPU-Beschleunigung zielt auf das KMeans-Training für IVF-Indizes.
- LanceDB meldet ein bis zu 20, 26x schnelleres Training als bei der CPU-Verarbeitung.
- Der Benchmark verwendete 1-million 1536D-Vektoren und IVF_4096.
- Als Nächstes sind eine Beschleunigung des PQ-Trainings und der Vektorzuordnung geplant.
GPU-Unterstützung zielt auf einen kostspieligen Engpass bei der Indizierung
Vektordatenbanken unterstützen Anwendungen wie Retrieval-Augmented Generation, Empfehlungssysteme und Computer Vision. Während sich ein großer Teil der Diskussion über sie auf Abfragelatenz und Recall konzentriert, kann die für den Aufbau eines Vektorindexes benötigte Zeit laut LanceDB mit wachsenden Datensätzen zu einem erheblichen Engpass werden.
Das Erstellen eines Indexes ist rechenintensiv. Nach Angaben des Unternehmens steigt der Aufwand quadratisch mit der Anzahl der Vektoren oder deren Dimensionen. Gängige Verfahren wie IVF, kurz für Inverted File index, und PQ, kurz für Product Quantization, teilen Vektoren in Cluster auf. Um die Zentren der Cluster zu finden, ist KMeans erforderlich, ein iterativer Prozess mit einer großen Anzahl von Vektordistanzberechnungen.
Laut LanceDB eignen sich GPUs gut für diese Art von Berechnungen. Die neueste Version des Python-Pakets, LanceDB v0.3.3, die auf Lance v0.8.10 basiert, ergänzt GPU-Beschleunigung über einen accelerator-Parameter in create_index().
CUDA und MPS sind über das Python-Paket verfügbar
Die Implementierung unterstützt Nvidia-GPUs über CUDA und Apple-Silicon-GPUs über MPS. Im Hintergrund verwendet LanceDB PyTorch, um IVF-Cluster zu trainieren, und übergibt die daraus resultierenden KMeans-Zentren anschließend zur Serialisierung des Indexes an seinen Rust-Kern.
Nach Angaben des Unternehmens bietet dieser Ansatz Unterstützung für zwei wichtige Entwicklerplattformen: Linux und Mac. Für die GPU-Funktionen müssen Nutzer PyTorch installieren, gegebenenfalls einschließlich einer CUDA-fähigen Version.
LanceDB verweist außerdem auf weitere Verbesserungen bei der Indizierung, darunter das Shuffling außerhalb des Arbeitsspeichers und gebündeltes KMeans-Training auf GPUs. Dem Unternehmen zufolge können damit Indizes mit mehreren zehn Millionen Vektoren trainiert und zugleich Bedenken wegen Speichermangelfehlern auf CPU oder GPU reduziert werden.
Tests zeigen schnelleres KMeans-Training
Für seinen Benchmark trainierte LanceDB einen IVF_4096-Index mit 4096 Clustern und der euklidischen L2-Distanz. Der Test verwendete 1-million Vektoren auf Basis von OpenAI-Ada2-Embeddings mit 1536 Dimensionen und lief unter Linux und macOS.
Unter Linux kam eine Google-Cloud-Instanz des Typs g2-standard-32 mit 32 logischen Kernen und einer Nvidia-L4-GPU zum Einsatz. Sie lief mit Ubuntu 22.04 und nvidia-driver-525. Das Training auf der CPU dauerte 323 Sekunden, auf der GPU dagegen 12.5 Sekunden.
Für den macOS-Test wurde ein 14-Zoll-Macbook Pro mit Apple M2 Max, 64GB RAM und 30 GPU-Kernen verwendet. Das Training dauerte auf der CPU 397 Sekunden und auf der GPU 21 Sekunden. LanceDB berichtet, dass die GPU-Beschleunigung im Vergleich zu den CPU-Gegenstücken Geschwindigkeitssteigerungen von bis zu 20, 26x erreichte.
Weitere Indexphasen sollen beschleunigt werden
Die aktuelle Version beschleunigt das IVF-KMeans-Training, das nur einen Teil des vollständigen Indextrainings ausmacht. LanceDB plant nach eigenen Angaben, GPU-Beschleunigung für das PQ-Training und für die Zuordnung von Vektoren zu ihren korrekten Zentren hinzuzufügen. Das Unternehmen erwartet, dass diese Ergänzungen die Zeit für das Indextraining von Anfang bis Ende weiter verkürzen werden.
Da die Implementierung PyTorch verwendet, sieht LanceDB zudem einen Weg zu verteiltem GPU-Training und künftiger Unterstützung weiterer Hardwarebeschleuniger, darunter TPUs über XLA. Die Unterstützung für CUDA und Apple-Silicon-GPUs ist über pip install lancedb verfügbar. Entwickler können die Funktion damit bereits jetzt auf kompatibler Hardware testen.
LanceDB: GPU-Accelerated Indexing in LanceDB