Liquid AI veröffentlicht d1.2-Entscheidungsmodelle mit Audio- und Bildaufgaben
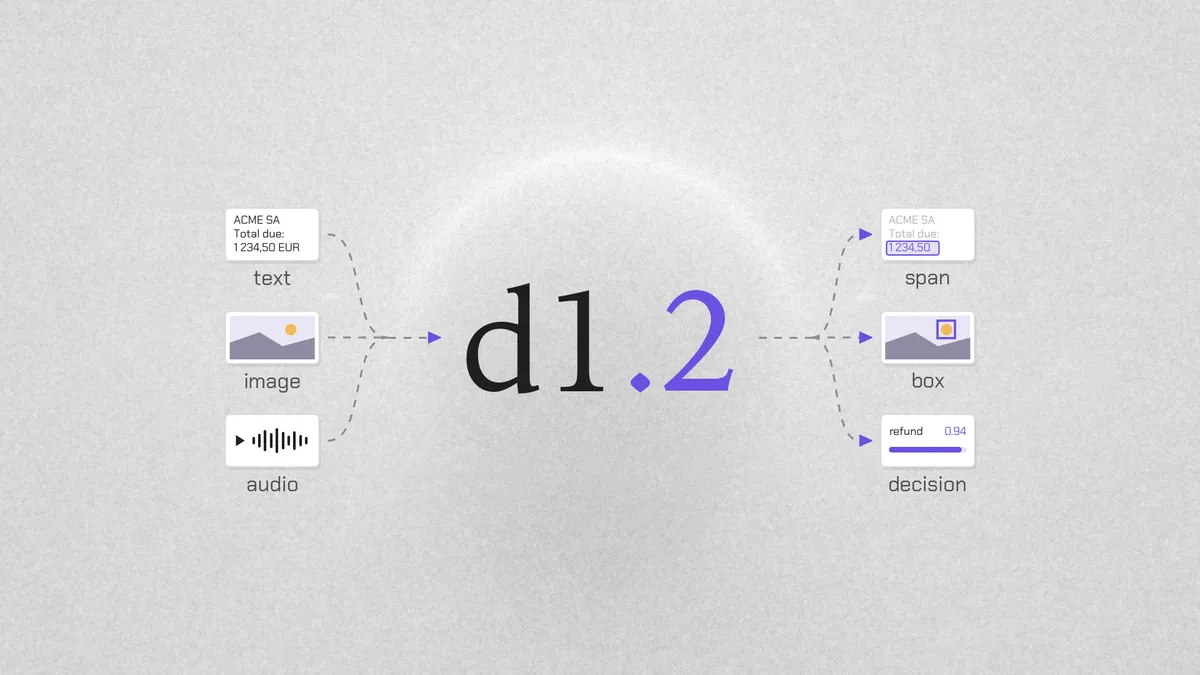
Liquid AI hat d1.2 und d1.2-ultra veröffentlicht, aktualisierte Entscheidungsmodelle mit Audioeingabe und fünf neuen API-Aufgaben. Nach Angaben des Unternehmens liegt d1.2-ultra im Artificial Analysis Decision Index v2.1 auf Platz eins unter den Entscheidungsmodellen.
- Liquid AI hat d1.2 und d1.2-ultra mit Audioeingabe veröffentlicht.
- Die Modelle ergänzen fünf strukturierte Entscheidungsaufgaben für Text und Bilder.
- d1.2-ultra erzielte 75 Punkte und belegte im Artificial Analysis Decision Index v2.1 den ersten Platz.
- Beide Modelle sind ab heute über die Liquid API verfügbar.
- Liquid AI zufolge werden die Modelle bald bei OpenRouter und Vercel verfügbar sein.
Fünf neue Möglichkeiten zur Informationsgewinnung und -bewertung
Die Modelle können jetzt einen Wert aus Text auslesen, etwa den Gesamtbetrag einer Rechnung, und die Zeichen zurückgeben, mit denen er identifiziert wird. Fehlt der angeforderte Wert, antworten sie mit "nicht gefunden", statt zu raten.
Außerdem können sie jede Passage einer bestimmten Art in einem Dokument finden, darunter Namen, Telefonnummern und E-Mail-Adressen. Bei Bildern können die Modelle ein Objekt oder jedes Vorkommen eines Objekts lokalisieren, indem sie Rechtecke um die Ziele zurückgeben. Weitere neue Aufgaben schätzen eine Zahl mit einer Bandbreite, etwa die Anzahl der Personen auf einem Foto, und wählen jede zutreffende Option aus, während sie für jede Auswahl eine Wahrscheinlichkeit angeben.
Audioeingabe und Benchmark-Ergebnisse
d1.2 und d1.2-ultra akzeptieren Audio als Eingabe. Nutzer können Fragen zur Aufnahme stellen, etwa welche Sprache gesprochen wird oder ob eine Sirene zu hören ist. Auch die Frage selbst kann aufgenommen werden, statt sie einzutippen. Bei zurückgehaltenen Aufnahmen beantworteten laut Liquid AI beide Modelle 95% bis 97% der Fragen zu Geräuschen aus ESC-50 oder zu gesprochenen Sprachen aus FLEURS, das 43 Sprachen abdeckt.
Im Artificial Analysis Decision Index v2.1 erzielte d1.2-ultra 75 Punkte und lag damit zwei Punkte vor dem bisherigen besten Entscheidungsmodell. Der Index bewertet sechs Benchmarks mit Aufgaben wie der Extraktion aus Lebensläufen, Quittungen und Forschungsarbeiten, Tool-Aufrufen sowie schwierigen Wissensfragen. Zudem berücksichtigt er die Konfidenz: Eine selbstsichere falsche Antwort wird stärker gewichtet als eine zögerliche.
Über 13 Benchmarks und 22,505 Fragen, die von allen fünf Modellen beantwortet wurden, meldet Liquid AI für d1.2-ultra einen Kalibrierungsfehler von 0.8 Punkten und für d1.2 von 1.2. Die Kalibrierung misst die Differenz zwischen der von einem Modell vorhergesagten Wahrscheinlichkeit und der Häufigkeit, mit der es richtig liegt.
Verfügbarkeit und Preise der API
Beide Modelle sind ab heute über die Liquid API verfügbar. Nutzer können sie mit einem Schlüssel von console.liquid.ai als d1.2 und d1.2-ultra aufrufen. Die neuen Antworttypen verwenden den bestehenden Endpunkt und das bestehende Anfrageformat. Beide Modelle rechnen ausschließlich Eingabetoken ab.
Liquid AI gibt den Preis mit $0.02 für d1.2 und $0.042 pro Million Eingabetoken für d1.2-ultra an. Bilder werden zum Texttarif mit 1.5 Token pro 32x32-Pixel-Block abgerechnet. Ein Bild mit 1024x1024 Pixeln kostet damit 1,536 Token. Laut Liquid AI werden die Modelle bald bei OpenRouter und Vercel verfügbar sein.
Für Nutzer, die Dokument-, Bild- oder Audio-Workflows entwickeln, bietet die Veröffentlichung strukturierte Ausgaben für Extraktion, Lokalisierung, Zählung und Klassifizierung bei weiterhin einheitlichem API-Format. Liquid AI hat außerdem eine interaktive Testversion über die Liquid Console bereitgestellt und auf die vollständige Dokumentation zu den Entscheidungsmodellen verlinkt.
Liquid AI: d1.2: State-of-the-Art Omnimodal Decision Models | Blog