Liquid AI führt offene d1-Entscheidungsmodelle für den Edge-Einsatz auf
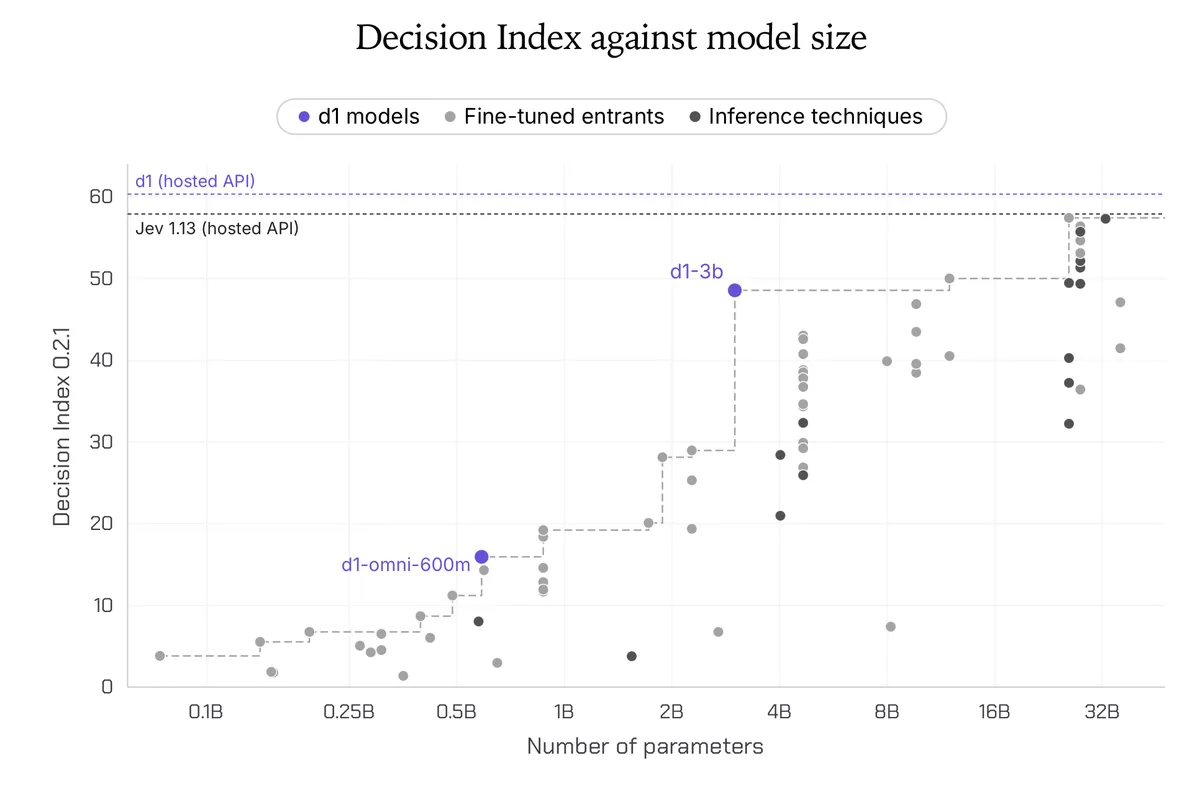
Liquid AI hat auf dem Hugging-Face-Blog einen Beitrag mit dem Titel "Multimodal open d1 decision models for the edge" veröffentlicht, der auf drei Modelle mit 0,4B, 0,6B und 3B Parametern verweist. Der für diesen Bericht verfügbare Text enthält neben dem Titel und den Modelllisten nur wenig, die meisten technischen Details sind daher unbestätigt.
- Liquid AI hat auf Hugging Face einen Beitrag mit dem Titel "Multimodal open d1 decision models for the edge" veröffentlicht.
- Verlinkt sind drei Modelle: ein Fill-Mask-Modell mit 0,4B Parametern sowie zwei Image-Text-to-Text-Modelle mit 3B und 0,6B Parametern.
- Frühere Beiträge desselben Autors behandeln LFM2.5-VL-DSpark und LFM2.5-DSpark, Letzteres mit dem Titel "Up to 3.2x Faster Inference".
- Der verfügbare Text enthält keine Benchmarks, Lizenz- oder Einsatzdetails.
Was der Beitrag auflistet
Der Beitrag erscheint im Hugging-Face-Blog unter der Organisation LiquidAI und trägt den Titel "Multimodal open d1 decision models for the edge". Der Titel deutet auf offene Modelle hin, die für den Einsatz auf Edge-Geräten gedacht sind und mehr als eine Art von Eingabe verarbeiten.
Im Artikel werden drei Modelle genannt. Eines ist mit Fill-Mask getaggt und hat 0,4B Parameter; die Seite zeigt es als am 28. Juli aktualisiert an. Ein zweites ist mit Image-Text-to-Text getaggt, hat 3B Parameter und wird als vor 13 Tagen aktualisiert angezeigt. Das dritte trägt ebenfalls den Tag Image-Text-to-Text, hat 0,6B Parameter und war zum Zeitpunkt der Seitenerfassung vor 4 Minuten aktualisiert worden.
Verwandte Arbeiten von Liquid AI
Die Seite verweist außerdem auf zwei frühere Beiträge desselben Autors. Der eine heißt "Accelerating vision-language models with LFM2.5-VL-DSpark" und ist auf den 24. September 2026 datiert. Der andere, "Up to 3.2x Faster Inference with LFM2.5-DSpark", stammt vom 20. August 2026. Die Angabe "3.2x" ist Teil des Titels dieses Beitrags; der verfügbare Text liefert keine weiteren Angaben dazu, wie sie gemessen wurde.
Zusammengenommen legen die Titel nahe, dass Liquid AI in den vergangenen Monaten Material zu schnelleren Vision-Language-Modellen und effizienter Inferenz veröffentlicht hat.
Was noch nicht bekannt ist
Der verfügbare Text nennt weder die Namen der Modelle noch beschreibt er Architektur oder Training, und er erklärt nicht, was "d1" und "Decision Models" in der Praxis bedeuten. Ebenso fehlen Benchmark-Ergebnisse, Lizenzbedingungen, Hardwareanforderungen und Angaben zu den vorgesehenen Edge-Anwendungsfällen. Die Zähler neben den einzelnen Modellen sind im Auszug nicht beschriftet und werden deshalb hier nicht gedeutet.
Wer multimodale Modelle auf lokaler oder eingebetteter Hardware betreiben möchte, findet Details im vollständigen Beitrag und auf den verlinkten Modellseiten bei Hugging Face. Solange diese Angaben nicht bestätigt sind, beschränkt sich die Nachricht darauf, dass Liquid AI unter dem Label open d1 eine Reihe kleiner Image-Text- und Fill-Mask-Modelle veröffentlicht hat.
Hugging Face: Multimodal open d1 decision models for the edge