Liquid AI stellt RIPL vor: Inferenz-Engine für LLM-Antworten in unter 50 ms
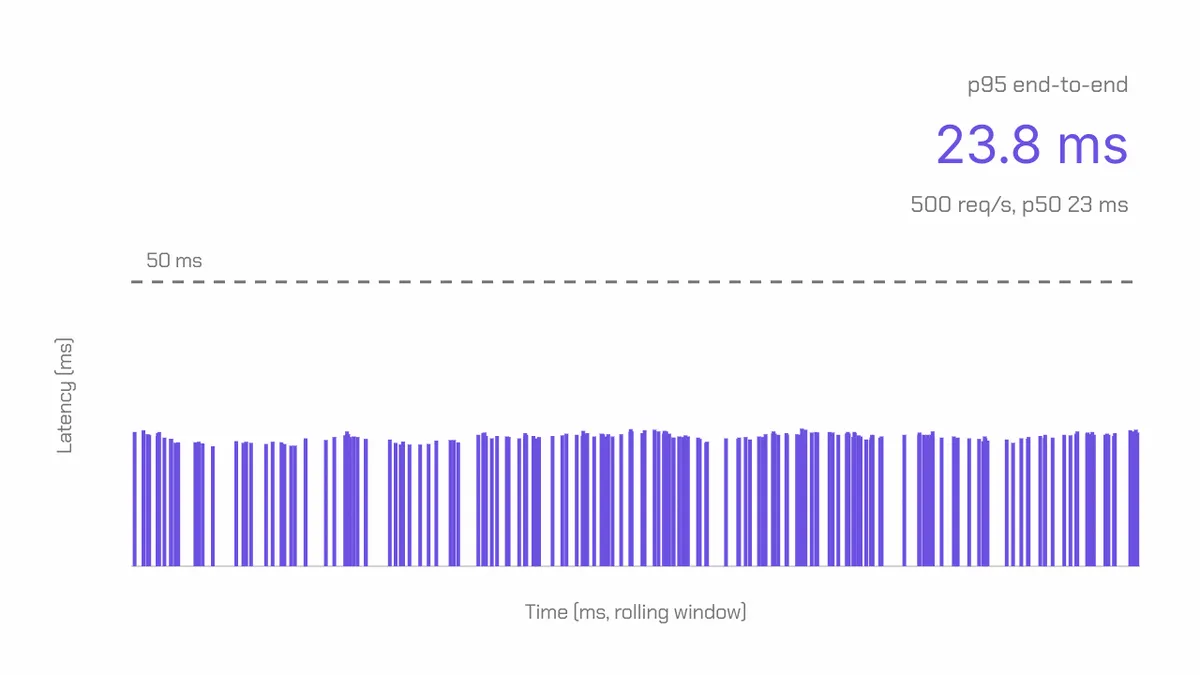
Liquid AI hat Liquid RIPL (Real-time Inference Pipeline) vorgestellt, eine Inferenz-Engine mit niedriger Latenz. Nach Angaben des Unternehmens liefert sie vollständig generierte Antworten der Liquid Foundation Models (LFMs) Ende zu Ende in unter 50 ms. Diese Geschwindigkeit halte RIPL auch dann, wenn bei Spitzenlast kontinuierlich Anfragen eintreffen.
- Liquid RIPL liefert laut Liquid AI vollständige LFM-Antworten Ende zu Ende in unter 50 ms, auch bei Spitzenlast.
- LFM2.5-1.2B auf RIPL hat eine 14,4- bis 28,4-fach niedrigere p95-Latenz als Qwen3.5-0.8B auf vLLM.
- LFM2.5-2.6B hat eine 5,6- bis 7,7-fach niedrigere p95-Latenz als Qwen3.5-2B.
- Shopify nutzt LFMs zur Verbesserung der Suche mit Inferenz in unter 20 ms auf realen Produktions-Workloads.
- RIPL ist ab sofort für Enterprise-Deployments auf NVIDIA-GPUs wie H100, H200, B200 und RTX PRO 6000 verfügbar.
Für Live-Anfragen gebaut, nicht für lange Agenten-Läufe
Liquid AI argumentiert, dass die meiste aktuelle Serving-Infrastruktur auf eine andere Aufgabe zielt: universelle Modelle, große Batches und lang laufende agentische Workflows, bei denen einige Sekunden pro Anfrage akzeptabel sind. Echtzeit-Workloads in Unternehmen kommen mit deutlich kleineren Latenzbudgets aus.
Als Beispiele, die eine Antwort in Millisekunden benötigen, nennt das Unternehmen Suchrankings, Produktempfehlungen, Betrugsentscheidungen und Zahlungsfreigaben. Schon kleine Verzögerungen führten zu Reibungsverlusten, etwa ein langsamerer Checkout, der die Conversion beeinträchtigt. Deshalb setzten solche Systeme traditionell auf schnelle, aber weniger genaue Verfahren wie Gradient-Boosted Trees oder kleine Embedding-Modelle.
RIPL soll diesen Zielkonflikt auflösen. Liquid AI zufolge platziert die Engine LFMs direkt im Pfad einer Live-Anfrage. Ziel sei es, generative KI-Erlebnisse reaktionsschneller zu machen, wenn Kunden suchen, entdecken, bezahlen und interagieren.
Latenzwerte im Vergleich zu vLLM
Liquid AI hat Vergleiche für zwei Workloads veröffentlicht. Nach Angaben des Unternehmens hat LFM2.5-1.2B auf Liquid RIPL eine 14,4- bis 28,4-fach niedrigere p95-Latenz als Qwen3.5-0.8B auf vLLM. LFM2.5-2.6B kommt auf eine 5,6- bis 7,7-fach niedrigere p95-Latenz als Qwen3.5-2B.
Diese Zahlen stammen von Liquid AI selbst. Der Beitrag beschreibt außerdem ein interaktives Tool, mit dem Nutzer eine GPU und ein Anfrageprofil auswählen können, um die Latenz eines LFM2.5-Modells Ende zu Ende bei steigender Anfragerate abzuschätzen.
Shopify als Produktionsbeispiel
Liquid AI zufolge setzt Shopify LFMs in der Produktion für latenzkritische Commerce-Workloads ein, bei denen schnelle und zuverlässige Inferenz unter hohem Anfragevolumen zählt. Ein Beispiel ist die Verbesserung der Suche, bei der LFMs eine Inferenz in unter 20 ms auf realen Produktions-Workloads ermöglichen.
Laut dem Beitrag übertreffen LFMs mit rund 50 % weniger Parametern die Alternativen und liefern dabei eine 2- bis 10-fach schnellere Inferenz, ohne Abstriche bei der Qualität. Liquid AI stellt dies als Beleg dafür dar, dass effiziente, auf Aufgaben spezialisierte Modelle gut funktionieren, besonders in Kombination mit einer Hochleistungs-Engine wie RIPL.
Verfügbarkeit und Einordnung
RIPL ist ab sofort für Enterprise-Deployments von LFMs auf NVIDIA-GPUs wie H100, H200, B200 oder RTX PRO 6000 verfügbar. Preise nennt der Beitrag nicht.
Für Teams, die Anfragepfade mit hartem Latenzbudget betreiben, lautet das Versprechen: Kleine Sprachmodelle könnten schnellere, aber weniger genaue Verfahren in Bereichen wie Ranking, Empfehlungen sowie Betrugs- und Zahlungsentscheidungen ersetzen. Liquid AI lädt interessierte Teams zur Kontaktaufnahme ein. Da die Leistungsangaben vom Unternehmen selbst stammen, dürften Käufer sie vermutlich an den eigenen Workloads überprüfen wollen.
Liquid AI: RIPL: Real-time Intelligence When Every Millisecond Counts | Blog